

短视频批量配音指南:Azure与ElevenLabs工具选择及避坑建议
本文介绍短视频批量配音的标准化流程,强调文案编号、参数统一与异步任务管理。对比 Azure Speech 和 ElevenLabs 的技术特点,说明如何避免批量生成中的常见错误,并指出高情绪旁白等例外场景的处理原则。
短视频批量配音的核心不在于寻找一个能“一键导入表格并自动交付全部视频”的神器,而在于建立一套稳定的生产流。建议先把文案拆成能独立交付的条目,确认一个音色和一套输出规格,再进入批量生成环节。这种模式适用于旁白风格相近的口播或解说类视频;如果每条视频都需要不同的角色切换和复杂的情绪起伏,强行统一参数反而会增加后期的返工成本。
在工具选择上,可以重点考察 Azure Speech 的批量合成接口以及 ElevenLabs 的文字转语音能力。前者适合有技术团队维护任务流程的场景,后者则更适合先进行中文声音评估,确定音色后再按条生成。理解这两者的差异,有助于根据实际需求接入自动化流程,而不是盲目追求所谓的“全自动”。
1. 为每条文案分配稳定编号
假设本周需要处理十条产品介绍视频,第一步不是打开软件,而是为这十条内容分配从 vid01 到 vid10 的唯一编号。每条记录应包含最终确定的文案、目标时长、选定的音色以及版本号。例如,vid03_v2 代表第三条文案的第二版修改稿,这个版本不应直接覆盖第一版的音频文件,而应作为新文件生成,确保剪辑师不会误用旧音频。
编号解决的是文案与音频之间的对应关系,而非模型本身的生成质量。如果仅依靠文件的下载时间排序,一旦中间某条文案修改后重新下载,整个序列就会打乱。即使某些工具会自动给输出文件加上序号,团队内部仍应保留业务编号与原文案的映射表,这是批量处理不混乱的基础。
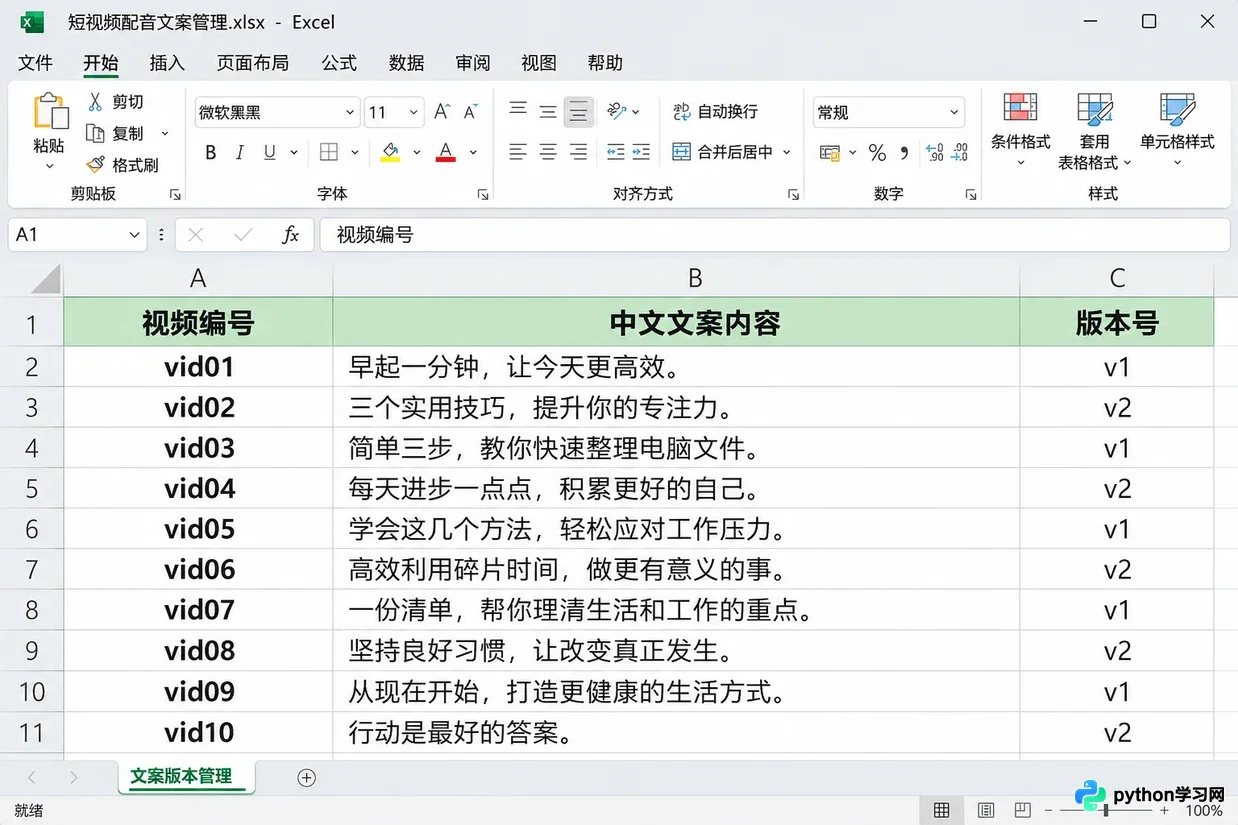
文案编号与版本管理示意
2. Azure Speech 适合明确的异步批处理
微软 Azure Speech 服务的 Batch synthesis API 支持以纯文本或 SSML(语音合成标记语言)提交多条输入。它的核心逻辑是异步处理:创建任务、查询状态、等待成功后下载结果,而不是发出请求后立刻获得所有音频文件。
官方文档指出,批量合成的结果会提供打包下载,并按输入顺序为音频文件编号。团队可以利用这一特性,将输出的音频文件与内部的 vid01 等业务编号对应起来,随后送入剪辑环节。需要注意的是,这是一个开发接口方案,并非无需配置的桌面软件。使用前必须核实资源区域、可用音色、账户额度以及相关费用,确保技术链路畅通。
3. ElevenLabs 适合先比较声音再组织生成
ElevenLabs 的文字转语音文档中列出了支持中文的多语种模型,并提供 MP3 等常见输出格式。它的工作流更适合“先试听、后批量”的模式:先用同一段具有代表性的中文文案测试不同音色的读法和情感表现,确定满意的声音后,保持参数一致,再逐条生成旁白。
如果需要实现批量自动化,应依据其当前的接口限制和账号配额来组织任务。不能将普通的单条合成功能误解为已有现成的“表格导入按钮”。不同模型、输出质量等级以及套餐类型都会影响实际可用能力,不能仅凭支持格式列表就承诺所有功能均可免费或无限制使用。
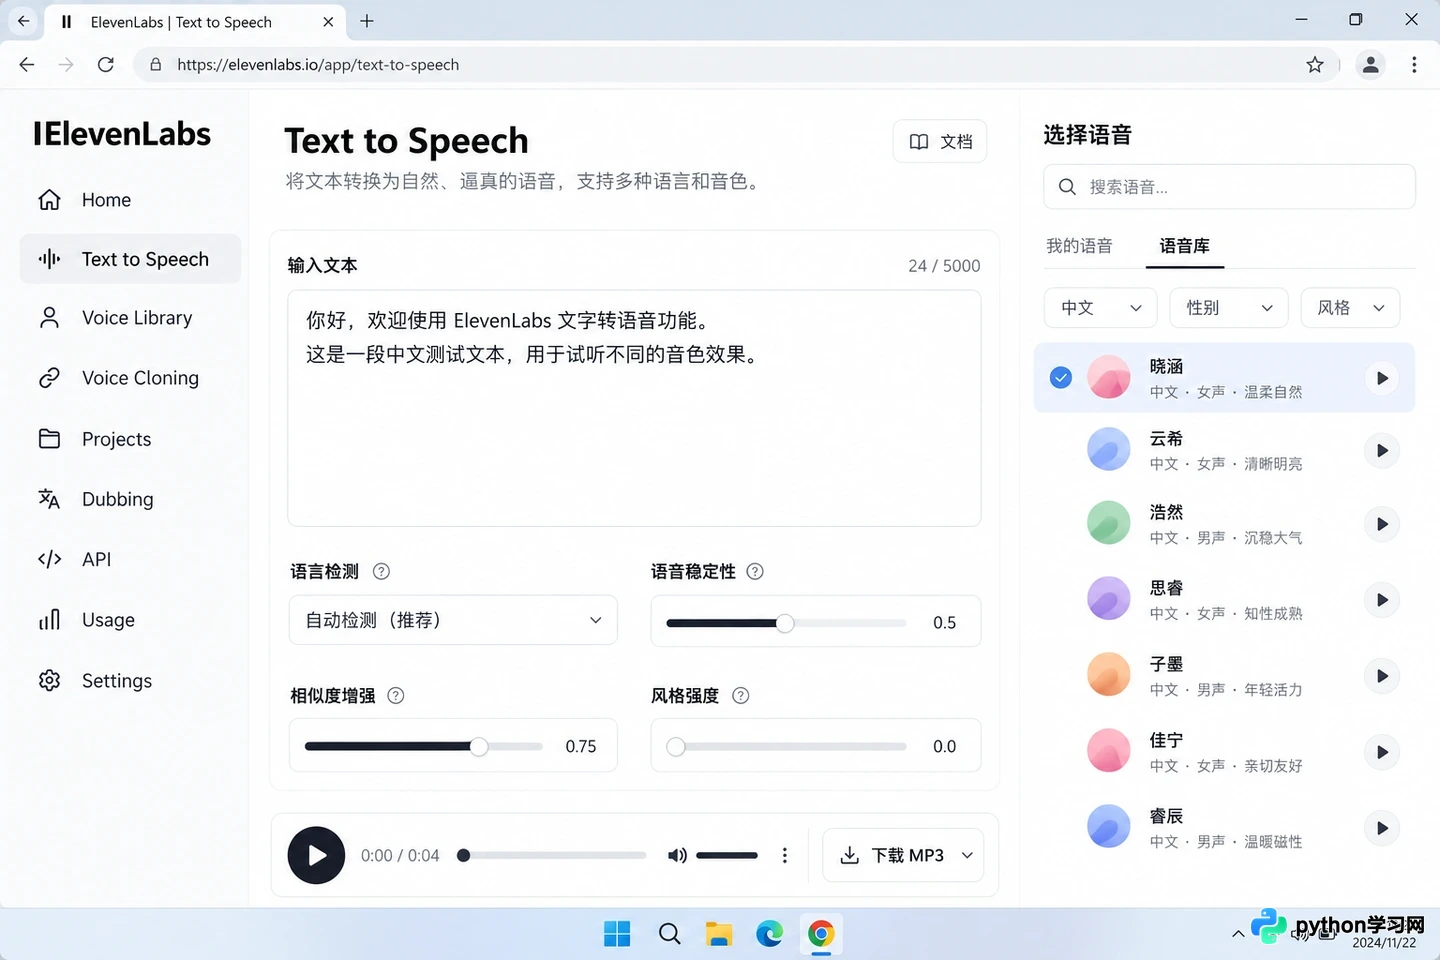
ElevenLabs中文音色选择与试听
4. 定稿和试听应放在大批量生成之前
在启动批量任务前,务必选取一条包含人名、数字、多音字和英文缩写的代表性文案进行试听。重点检查读音准确性、停顿自然度以及语速是否合适。如果跳过这一步,同一个读音错误可能会复制到整批音频中,原本为了节省时间而进行的批量操作,最终会耗费更多时间在替换和复核上。
此外,视频时长不能仅靠字数估算。同一段文字在使用不同声音模型或调整停顿设置时,生成的音频长度可能会有显著差异。应将实际生成的音频放入视频时间线中进行核对,而不是试图通过加快语速硬塞进固定的画面时长中。对于重要的文案修改,应先更新文案版本,再重新生成受影响的特定条目。
5. 批量成功不等于每条都能直接交付
下载结果后,必须进行二次核对:检查条目数量是否完整、文件是否可正常播放、文案内容与编号是否一一对应。对于异步任务,还要特别检查是否有部分输入失败的情况,不能仅凭拿到一个压缩包就认定全部完成。
对于状态未知的请求,应先查询原任务的状态,避免重复提交导致重复计费。已确认成功的条目保留结果,只针对失败或内容确需修改的部分进行处理。在使用接口时,访问凭据应由受控的配置系统提供,严禁直接放入共享的文案表格或成片目录中,以保障账户安全。
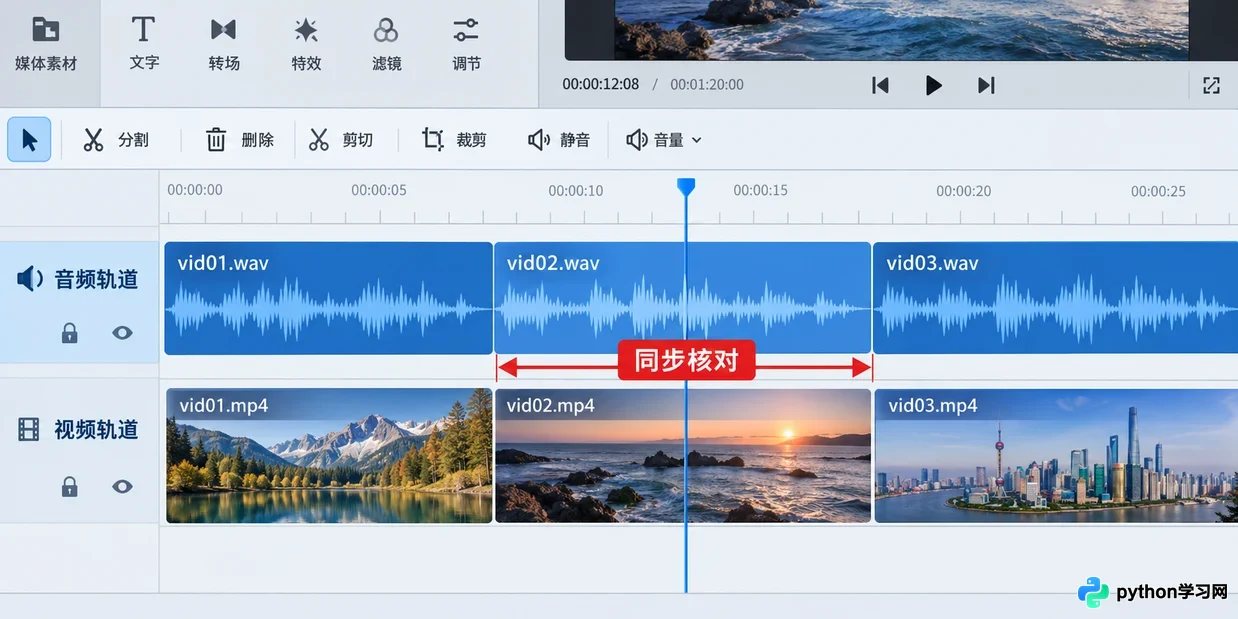
音频文件核对与时间线匹配
6. 少量高情绪旁白是批量统一的例外
人物对话、剧情转折或需要严格卡点的短片,不适合所有句子共用固定的语速和语气。这类内容可以先拆分角色与段落,逐段试听调整;必要时采用真人录音,再统一音频规格交给剪辑。
工具选择时还应仔细核对声音授权、内容用途与套餐条款。自定义或克隆声音通常需要相应的授权许可,支持生成并不自动代表具备任何商业用途的使用权。把批量化用在编号管理、参数统一、任务状态监控和结果整理上,把人工精力留给读音校对与情感表达。只有当文案稳定、映射清楚、每条验证通过时,才算真正完成了一批可用的配音。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









