

用Python切片反转元组或提取间隔元素
详细讲解在Python中使用切片语法反转元组及提取间隔元素的方法、底层执行机制、边界陷阱与性能考量。
在 Python 开发中,元组(tuple)是基础且重要的不可变序列容器。由于元组具备不可变性,它并不支持像列表那样的 list.reverse() 原地反转方法。如果需要获得逆序的元组,或者按固定规律跳跃提取其中的奇数项、偶数项等间隔元素,最简洁、高效且符合 Python 规范(Pythonic)的手段就是利用切片语法(Slicing)。通过指定合理的步长参数,例如 t[::-1] 或 t[::2],可以在微秒级内从原元组派生出所需的新元组。
一、元组切片基础语法与索引机制
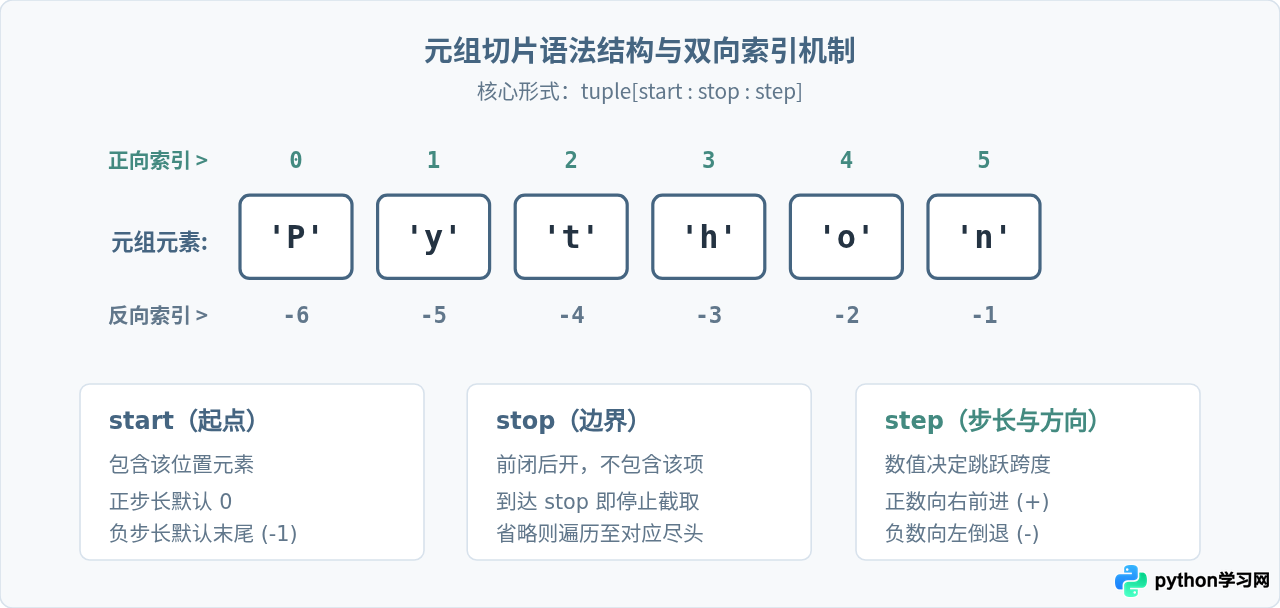
Python 中序列切片的标准格式为:sequence[start:stop:step]。这三个参数均由冒号分隔,各自承担不同的定位职责:
- start(起始索引):切片截取的起点下标。如果省略,在正步长下默认为序列起点
0;在负步长下默认为末尾最后一个元素。 - stop(终止索引):切片截取的终点下标。切片采用前闭后开(包含 start,不包含 stop)规则。如果省略,切片将一直延伸至序列对应方向的最边界。
- step(步长与方向):每次截取元素时的下标跨度。其绝对值代表间隔大小,正负号决定移动方向:正数表示由左向右遍历,负数表示由右向左反向遍历。
元组支持双向索引机制:正向索引从 0 开始递增至 len(t) - 1;反向负向索引从末尾的 -1 开始递减至 -len(t)。切片操作能够直接理解这两种索引形式。
二、用切片反转元组的操作方法与原理解析
对元组进行全量反转的标准写法是 tuple[::-1]。这种写法语义明确且执行效率极高。我们通过以下可执行代码进行验证:
# 定义一个包含多个不同数据项的元组
raw_tuple = (10, 20, 30, 40, 50, 60)

# 使用负步长 -1 进行全量反转
reversed_tuple = raw_tuple[::-1]

print("原元组:", raw_tuple)
print("反转后元组:", reversed_tuple)

# 示例运行输出:
原元组: (10, 20, 30, 40, 50, 60)
反转后元组: (60, 50, 40, 30, 20, 10)
1. 为什么省略参数能完成全量反转?
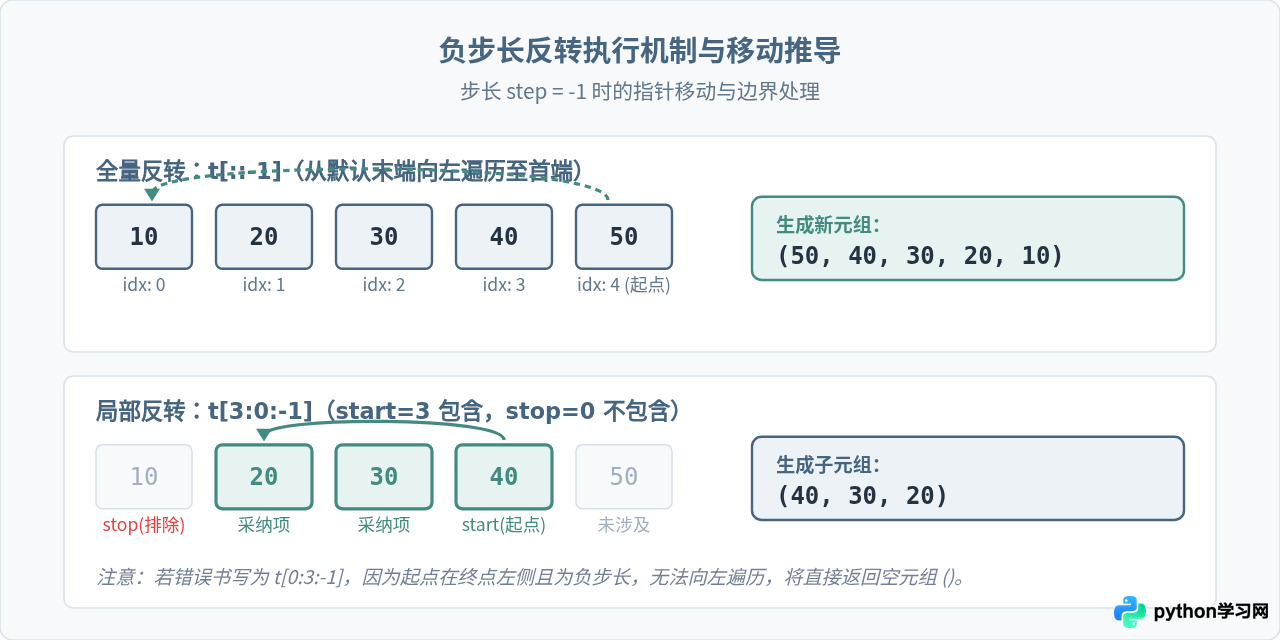
在表达式 raw_tuple[::-1] 中,start 和 stop 均被省略,只有 step 被明确设为 -1。当 Python 检测到 step < 0 时:
- 默认的
start自动绑定为序列的最右端(最后一个元素),即下标len(t) - 1。 - 默认的
stop自动绑定为序列最左端的前一个位置,从而确保下标为0的元素能够被顺利包含。 - 迭代指针从末尾元素出发,每一步递减
1,逐个提取元素并打包为新元组。
2. 局部区间反转与常见边界陷阱
如果只想反转元组的某一部分,必须牢记:当步长为负数时,遍历方向是从右向左,因此 start 的位置必须在 stop 的右侧(即 start > stop)。
# 局部反转示例:提取索引 4 到 1 之间的元素并倒序
t = ("A", "B", "C", "D", "E", "F")
# 索引 4 是 'E',索引 1 是 'B'(stop 不包含索引 1)
sub_reversed = t[4:1:-1]
print("局部反转结果:", sub_reversed)

# 常见陷阱:如果写成 t[1:4:-1]
empty_result = t[1:4:-1]
print("反向越界结果:", empty_result)

# 示例运行输出:
局部反转结果: ('E', 'D', 'C')
反向越界结果: ()
在上面的错误示例中,t[1:4:-1] 试图从下标 1 向左倒退寻找下标 4,在负步长下永远无法触碰目标区间,因此 Python 会安全地返回一个空元组 (),而不会抛出异常。这是初学者极易混淆的关键点。
三、提取间隔元素的常用模式与切片技巧
在数据处理、信号采样或交替拆分场景中,我们经常需要隔一个或隔几个元素抽取一项。设置 step > 1 即可轻松实现间隔提取。
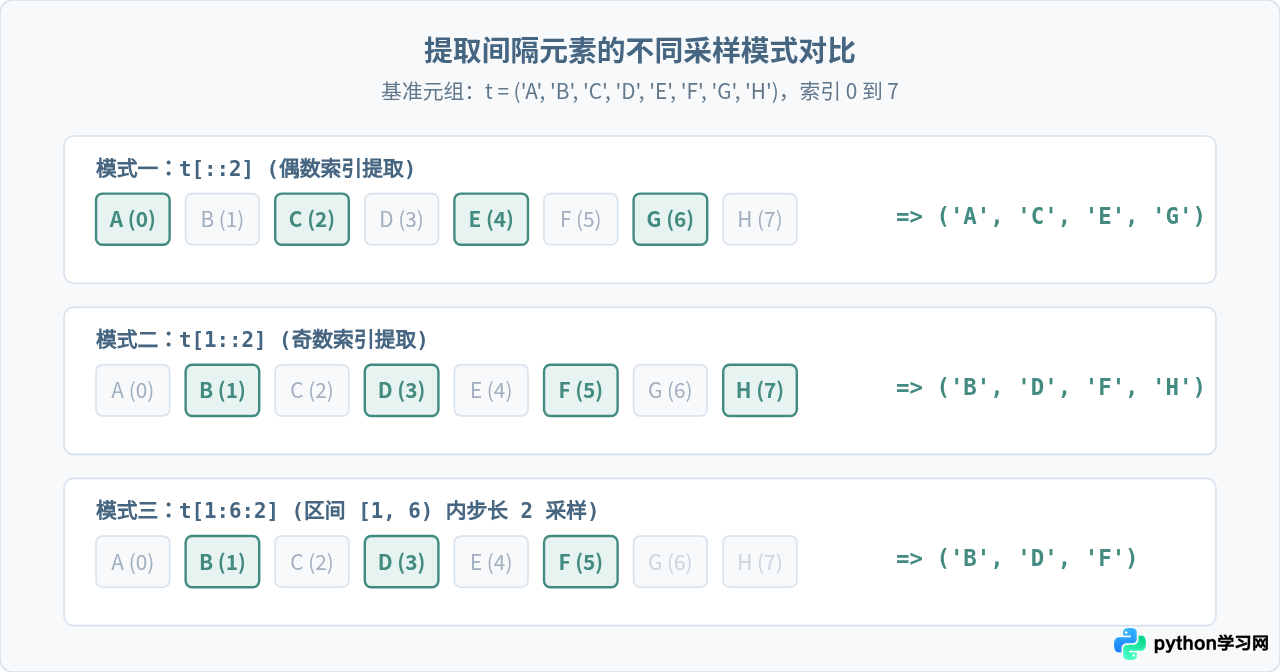
1. 提取所有偶数索引元素:tuple[::2]
当 start 和 stop 省略,step=2 时,切片从索引 0 开始,每次递增 2,截取位置为 0, 2, 4, 6... 的所有元素。在零基索引中,这对应于列表/元组的第 1、3、5、7... 个奇数位位置(程序视角的偶数索引):
items = ("零", "一", "二", "三", "四", "五", "六", "七")

# 提取偶数下标元素(0, 2, 4, 6)
even_idx_items = items[::2]
print("偶数下标元素:", even_idx_items)

# 示例运行输出:
偶数下标元素: ('零', '二', '四', '六')
2. 提取所有奇数索引元素:tuple[1::2]
将 start 显式指定为 1,stop 省略,step=2,切片将从索引 1 开始跳跃提取位置为 1, 3, 5, 7... 的元素:
# 提取奇数下标元素(1, 3, 5, 7)
odd_idx_items = items[1::2]
print("奇数下标元素:", odd_idx_items)

# 示例运行输出:
奇数下标元素: ('一', '三', '五', '七')
3. 限定区间与自定义步长采样
切片的三要素可以组合使用。例如从索引 1 截取到索引 7(不含 7),每隔 2 项抽取一个:items[1:7:2];或者进行每 3 个元素取一个的大跨度采样:items[::3]:
# 在 [1, 7) 区间内按步长 2 提取
sampled = items[1:7:2]
print("区间步长采样:", sampled)

# 每隔 3 项抽取一个(0, 3, 6)
step3_items = items[::3]
print("步长为3采样:", step3_items)

# 示例运行输出:
区间步长采样: ('一', '三', '五')
步长为3采样: ('零', '三', '六')
四、内存特性、浅拷贝与替代方案选型
1. 浅拷贝机制与可变对象风险
对元组执行切片操作时,Python 会在底层的 C 层面申请一段新的内存来存放新元组对象,并将被选中的元素引用直接填充过去。这一过程属于浅拷贝(Shallow Copy):
- 对于包含不可变元素(如整数、字符串、浮点数)的元组,新旧元组完全独立,没有任何副作用。
- 如果元组中包含了可变对象(例如列表
list、字典dict),切片得到的新元组中保存的依然是对原可变对象的相同内存引用。如果修改了该可变对象的内容,原元组和新元组都会看到变化。
# 浅拷贝验证:元组内包含列表
nested_tuple = ([1, 2], [3, 4], [5, 6])
rev_nested = nested_tuple[::-1]

# 修改反转元组中的第一个列表元素
rev_nested[0].append(999)

print("新元组:", rev_nested)
print("原元组也被间接影响:", nested_tuple)

# 示例运行输出:
新元组: ([5, 6, 999], [3, 4], [1, 2])
原元组也被间接影响: ([1, 2], [3, 4], [5, 6, 999])
开发提示:若元组内部包含可变容器且业务要求深度隔离,切片后应配合 copy.deepcopy() 进行深拷贝处理。
2. 切片反转与 reversed() 的选型对比
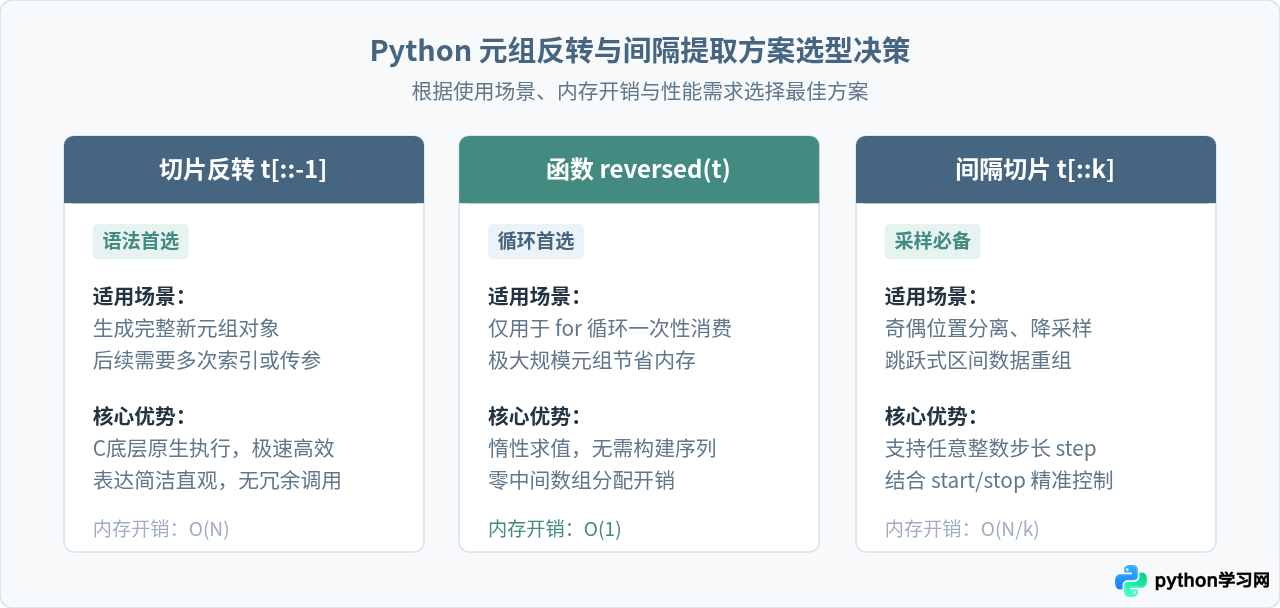
除了切片 t[::-1],Python 还提供了内置函数 reversed(t)。两者适用场景截然不同:
| 对比维度 | 切片反转 t[::-1] |
内置函数 reversed(t) |
|---|---|---|
| 返回值类型 | 全新的 tuple 实例 |
reversed 迭代器对象 |
| 内存占用 | \(O(N)\)(需要分配新元组内存) | \(O(1)\)(仅保存当前游标指针) |
| 支持下标索引 | 支持(可随机访问 t[0] 等) |
不支持(仅供一次性遍历) |
| 推荐应用场景 | 需要持久化存储、多次复用、作为字典键或需要下标访问 | 用于 for item in reversed(t): 等仅需反向遍历一次的场景 |
五、总结
在 Python 中对元组进行反转或间隔提取,利用切片语法是最干净、最符合直觉的方案。掌握其核心规律只需牢记以下要点:
- 全量反转用
t[::-1]:省略前后索引、设置步长为-1,底层自动以最右侧元素为起点、最左侧为终点逆序产出新元组。 - 提取偶数项用
t[::2],提取奇数项用t[1::2]:通过正向步长 2 轻松实现奇偶下标的分离与均匀降采样。 - 负步长要求
start > stop:逆向切片时若误写成由小到大的索引,将得到空元组()。 - 切片具备安全性与浅拷贝特性:切片索引越界时会自动截断而不报错;返回的新元组保持对内部对象的浅拷贝引用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









