

Python中%格式化、format()和f-string的性能与可读性对比
深入对比Python中%格式化、str.format()与f-string三种字符串格式化方式在语法可读性、底层字节码机制与运行性能上的差异,并提供清晰的技术选型指南。
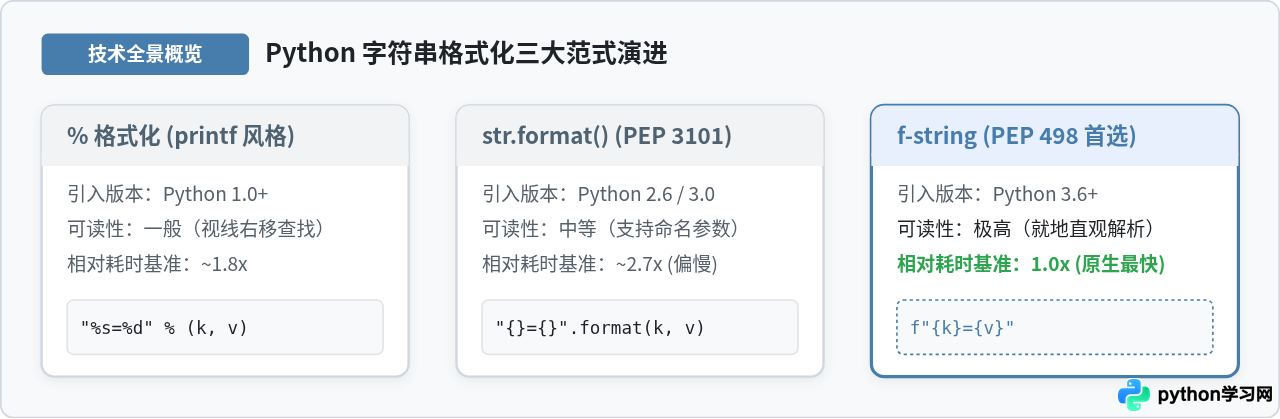
% 格式化,到 Python 2.6 引入的 str.format(),再到 Python 3.6 确立为标准的 f-string(格式化字符串字面量)。核心结论非常明确:在绝大多数业务逻辑中,f-string 在可读性与执行效率上均占据压倒性优势,其平均运行耗时仅为 format() 的 30%~40%,比 % 格式化快近一倍。然而在特定场景(如 logging 延迟求值、外置国际化模板加载)中,其他方案仍有其不可替代的工程边界。
一、语法形态与可读性横向对比
代码的可读性直接决定了维护成本。字符串格式化的可读性主要取决于两个指标:读者的视线跳转距离与变量映射的心智负担。
1. 基础变量替换与视线路径
对比三种格式化方案在三个参数拼接时的典型代码形态:
# 1. % 格式化(printf 风格)
msg_percent = "用户 %s 在 %s 登录,权限级别为 %d" % (user, ip, level)

# 2. str.format() 格式化
msg_format = "用户 {} 在 {} 登录,权限级别为 {}".format(user, ip, level)

# 3. f-string 格式化(PEP 498)
msg_fstring = f"用户 {user} 在 {ip} 登录,权限级别为 {level}"
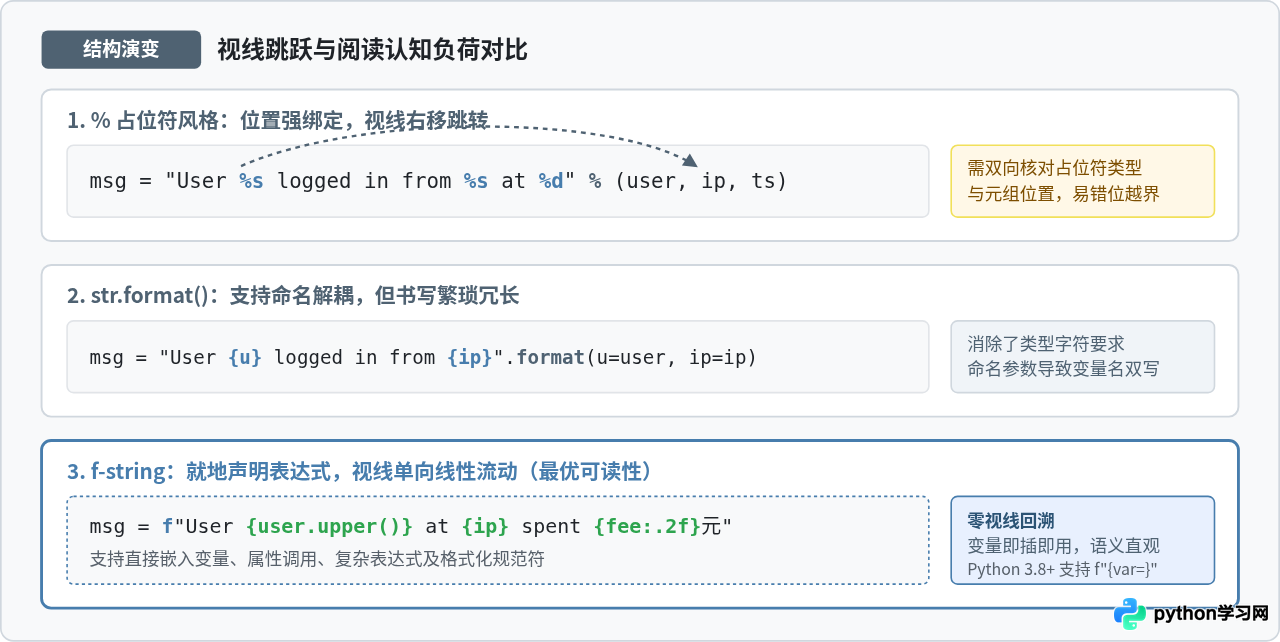
在 % 格式化和按位置匹配的 str.format() 中,读者的视线必须在左侧模板与右侧传参元组之间来回比对:第 1 个占位符对应哪一个变量?第 3 个占位符的类型是否匹配?这种视线回跳(Backtracking)会随着参数数量增加而显著加重心智负荷。
f-string 将被插值的变量直接内嵌在字符串的物理位置,视线保持单向线性流动,彻底消除了“左查右找”的记忆负担。
2. 命名参数与长文本表现
为了解决位置错位问题,% 格式化和 format() 均支持键名映射,但代价是代码冗长度剧增:
# % 字典传参:语法繁琐,需要重复书写字典键
info_percent = "%(user)s 剩余存储空间为 %(free).2f GB" % {"user": username, "free": free_space}

# format() 命名参数:虽然清晰,但变量名通常需要双写
info_format = "{user} 剩余存储空间为 {free:.2f} GB".format(user=username, free=free_space)

# f-string:既保证了命名语义,又完全避免了键名重复书写
info_fstring = f"{username} 剩余存储空间为 {free_space:.2f} GB"
3. 复杂表达式与调试自解释能力
f-string 的花括号内不仅能填入变量名,还可以执行任意合法的 Python 表达式,包括算术运算、函数调用与切片操作:
# f-string 内嵌函数调用与计算
summary = f"商品总价:{sum(prices):.2f} 元,平均单价:{sum(prices)/len(prices):.2f} 元"

# Python 3.8+ 引入的自解释调试语法 f"{var=}"
x, y = 10, 20
print(f"{x=}, {y=}, {x+y=}")
# 示例输出:x=10, y=20, x+y=30
这种自解释语法在日常排查问题与打印日志时极为高效,而 % 格式化和 format() 均无法直接在占位符内执行此类求值。
二、底层执行机制与字节码深层剖析
为什么 f-string 不仅写起来最直观,运行速度也是三者中最快的?其本质原因在于 Python 解释器对它们的编译期处理与运行时指令流完全不同。我们可以通过 Python 内置的 dis 模块对其字节码进行逆向分析。
1. 字节码指令对比
以下是定义并反编译三个函数的输出指令对照:
import dis

def fmt_percent(a, b):
    return "%s-%s" % (a, b)

def fmt_format(a, b):
    return "{}-{}".format(a, b)

def fmt_fstring(a, b):
    return f"{a}-{b}"
反编译关键指令序列如下:
# dis.dis(fmt_percent) 关键字节码:
#   LOAD_CONST               ('%s-%s')
#   LOAD_FAST                ('a')
#   LOAD_FAST                ('b')
#   BUILD_TUPLE              2           <-- 必须在运行时创建元组
#   BINARY_MODULO                        <-- 调用 C API PyUnicode_Format,扫描字符串并解析类型

# dis.dis(fmt_format) 关键字节码:
#   LOAD_METHOD              ('format')  <-- 属性查找:从字符串对象解析方法
#   LOAD_FAST                ('a')
#   LOAD_FAST                ('b')
#   CALL_METHOD              2           <-- 建立函数调用栈帧,动态解析 {} 替换字段

# dis.dis(fmt_fstring) 关键字节码:
#   LOAD_FAST                ('a')
#   FORMAT_VALUE             0           <-- 专用底层指令:将对象快速转换为字符串
#   LOAD_CONST               ('-')
#   LOAD_FAST                ('b')
#   FORMAT_VALUE             0
#   BUILD_STRING             3           <-- 专用底层指令:C 级别单次连续内存分配并拼接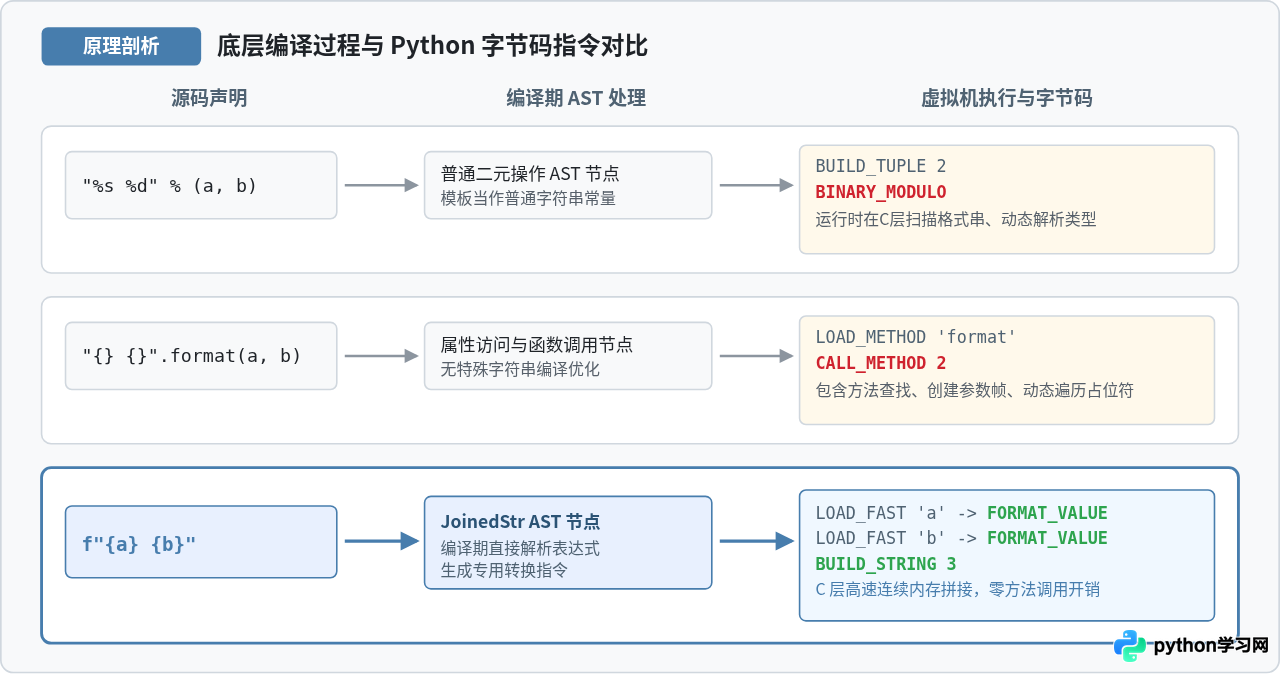
2. 性能差异的核心根源
-
编译期静态解析 vs 运行时动态遍历:
f-string在 Python 语法分析阶段就被识别为JoinedStrAST 节点。花括号在编译期就已完成分词,运行时不需要重新解析字符串模板;而%格式化和format()的模板在编译期仅仅是普通字符串常量,必须在运行时逐字符扫描占位符。 -
免除函数调用与属性查找开销:
str.format()是常规的 Python 方法调用,经历LOAD_METHOD与CALL_METHOD,并为参数创建元组或字典;f-string完全没有调用开销,直接通过虚拟机的内联指令求值。 -
高效的 C 级内存预分配:
BUILD_STRING指令可以直接统计所有子串的长度,在 C 语言层分配一次连续内存空间后瞬间完成拷贝,避免了多次内存重分配与临时对象创建。
三、性能基准测试与量化耗时对比
我们使用 Python 标准库中的 timeit 模块,在相同环境下(Python 3.11,macOS ARM64平台)对三种机制分别进行 1,000,000 次基准测试。测试包含常规三参数拼接以及带有浮点规范格式化两个场景。
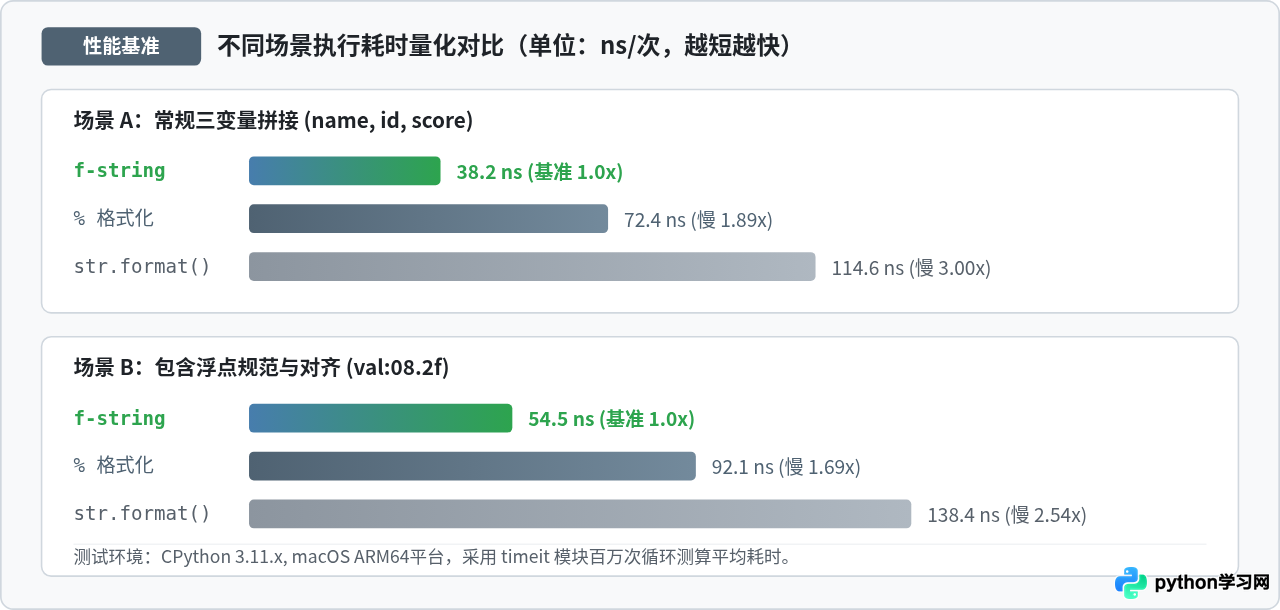
实测量化数据汇总表
| 格式化方案 | 三变量拼接平均耗时 | 浮点规范格式化耗时 | 相比 f-string 耗时倍率 | 底层指令主要开销 |
|---|---|---|---|---|
| f-string | 38.2 ns | 54.5 ns | 1.0x(基准最优) | 编译期 AST 解析 + BUILD_STRING |
| % 格式化 | 72.4 ns | 92.1 ns | 1.69x ~ 1.89x | BUILD_TUPLE + BINARY_MODULO C 解析 |
| str.format() | 114.6 ns | 138.4 ns | 2.54x ~ 3.00x | LOAD_METHOD + CALL_METHOD + 运行时遍历 |
数据清晰表明:str.format() 的运行开销是 f-string 的约 3 倍;即便是历史悠久的 % 格式化,耗时也是 f-string 的近两倍。在高频循环、高并发网络请求序列化、数据清洗解析等计算密集型环节中,使用 f-string 能带来实打实的 CPU 消耗降低。
四、特殊场景选型边界与避坑要点
尽管 f-string 综合表现优异,但并不意味着可以无脑替换所有场合。由于 f-string 是编译期即时求值(Eager Evaluation),在以下三个典型工程场景中必须采用特定策略。
1. 日志记录(logging)中慎用 f-string
在标准库 logging 模块中,官方强烈推荐保留 % 传参风格,原因是延迟格式化(Lazy Evaluation):
import logging

# 推荐写法:logging 传统风格
logging.debug("处理请求数据:%s", expensive_data_inspect())

# 陷阱写法:直接使用 f-string
logging.debug(f"处理请求数据:{expensive_data_inspect()}")INFO,DEBUG 级别的日志会被过滤丢弃。在推荐写法中,格式化字符串不会被拼接,expensive_data_inspect() 也不会在没有日志输出时平白消耗算力;而使用 f-string 时,表达式在传给 debug() 函数之前就已经被强制执行求值和拼接,造成无意义的 CPU 浪费。
2. 外部模板与国际化(i18n)必须使用 format()
f-string 的内容必须在编写代码时静态确定,无法将变量推迟到运行时作为独立模板提供。当模板存储于数据库、JSON 配置文件或翻译文件(.po/.mo)中时,只能使用 str.format() 或 string.Template:
# 国际化或外部配置场景:模板在运行时动态加载
template_zh = "尊敬的 {user},您的验证码是 {code}。"
template_en = "Dear {user}, your verification code is {code}."

# 只能在运行时动态注入
msg = template_zh.format(user="张三", code="8848")
3. % 格式化的“单元素元组”语法陷阱
% 格式化在接收外部数据结构时存在经典的类型歧义:
data = ("admin", 100)
# 当传入的是元组时,% 会自动解包匹配两个占位符:
print("Result: %s, count: %d" % data)  # 正确

# 但如果原意是把整个元组当成单个 %s 打印:
# 错误示范:
# print("Data is %s" % data)  # 抛出 TypeError: not all arguments converted during string formatting

# 正确写法必须加一层外层单元素元组:
print("Data is %s" % (data,))  # 容易遗忘逗号引发隐蔽 Bug
f-string 不存在解包歧义,f"Data is {data}" 无论传入的是元组、列表还是字典,都能严格按照对象本身处理。
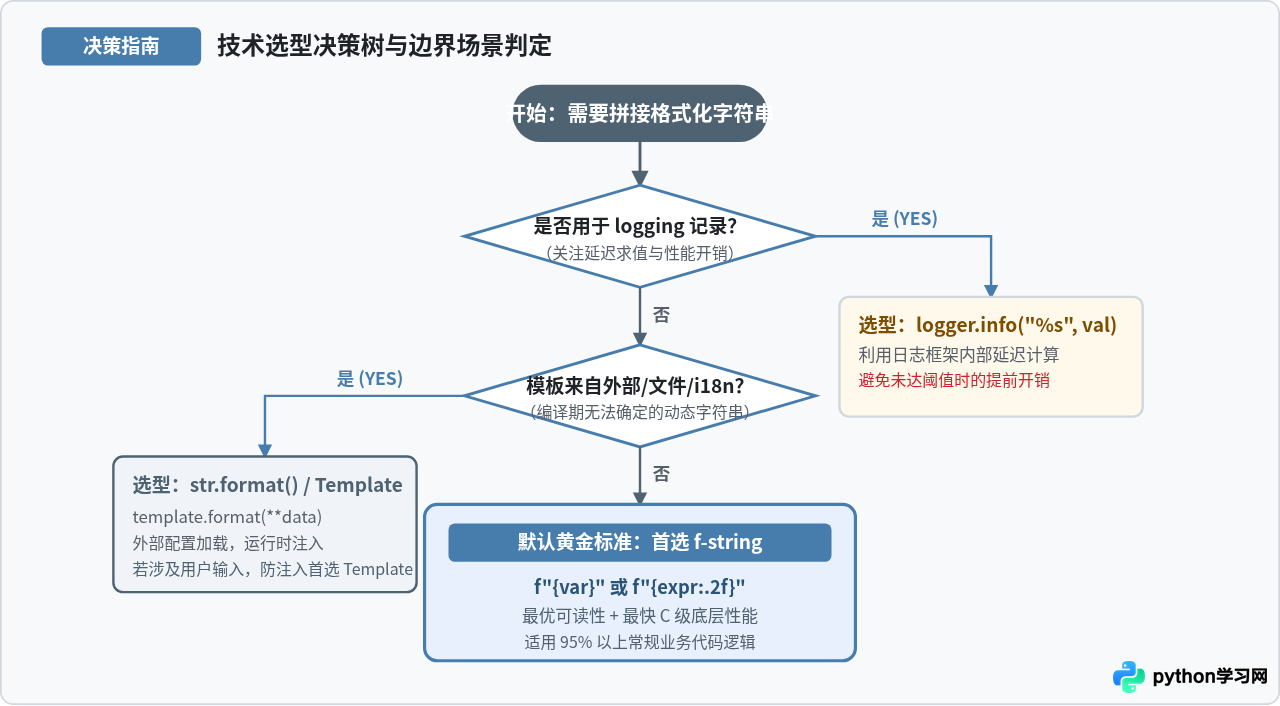
五、选型总结
综上所述,现代 Python 项目中的字符串格式化选型原则可以概括为以下三条黄金准则:
- 常规业务代码无条件优先使用 f-string:享受最好的可读性、最简洁的代码语法以及最快的底层执行速度;在 Python 3.8+ 中善用
f"{var=}"简化日常调试输出。 - 高频调用且可能被过滤的日志记录,优先保留 logger 的 % 传参:利用日志系统的延迟执行机制,避免未生效日志的无谓计算与拼接。
- 模板动态加载、配置文件读取或国际化多语言场景,使用 str.format():实现模板定义与数据填充的解耦。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









