

Python异常处理try-except用法:怎么捕获错误并记录日志
深入讲解Python异常处理try-except机制及如何规范记录日志。详细解析try-except-else-finally执行逻辑、标准库logging模块接入、logger.exception堆栈记录技巧及生产环境最佳实践。
假设你编写了一个自动化脚本,每天凌晨从多个远程接口抓取数据、清洗字段并存入数据库。如果代码中没有任何错误处理,一旦某个接口发生网络短暂超时或返回了格式异常的 JSON,整个程序就会瞬间崩溃中断,后续所有任务随之瘫痪。相反,如果随手加上一句简陋的 try ... except: pass,程序虽然不会报错中断,但数据静默丢失,你在排查数据不一致时将看不到任何报错轨迹。编写稳健程序的正确路径,是通过 try-except 明确圈定高危操作,同时接入标准库 logging 模块,把发生异常时的入参上下文与完整调用栈准确写入日志。
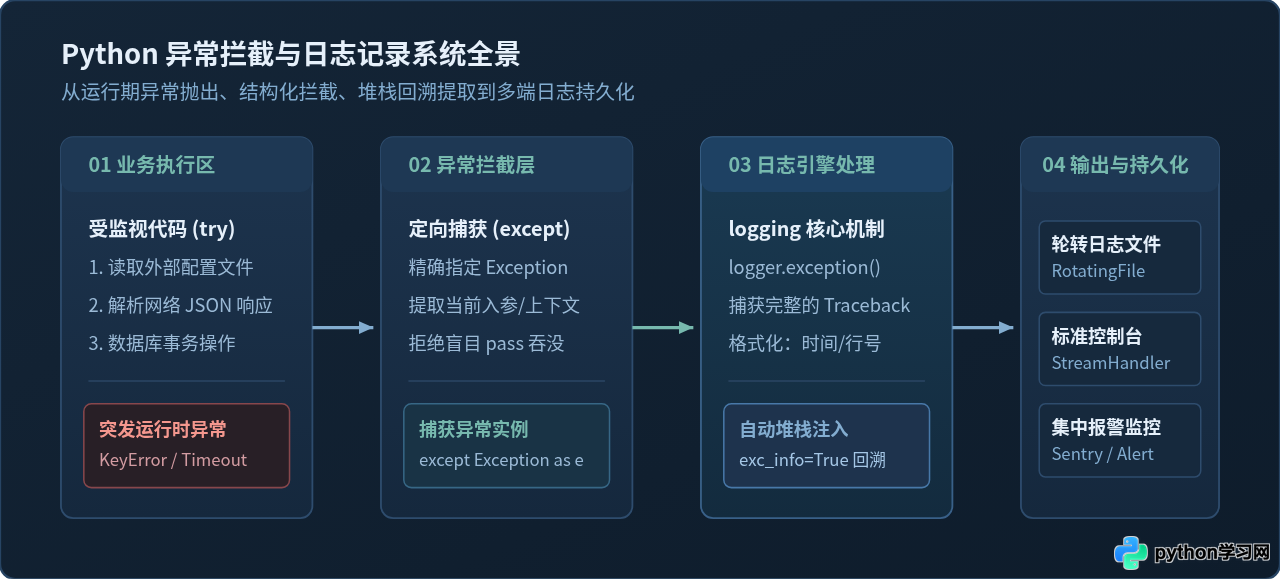
一、try-except 的完整结构与执行时序
在 Python 中,完整的异常处理语法由四个关键字协同完成:try、except、else 和 finally。很多初学者往往只使用前两者,忽视了后两者的关键职责:
- try:放置需要监视的代码。这里的代码只要抛出异常,Python 执行引擎就会立刻中断后续语句,转入异常匹配流程。保持
try代码块的简短精炼至关重要。 - except:用于声明与捕获特定类型的异常。一旦
try抛出的异常与当前分支类型吻合,便执行该分支内的恢复逻辑或日志记录。 - else:在
try块没有发生任何异常、完全正常执行完毕时触发。把依赖try成功结果的常规后续业务放在else块中,能有效防止把新的错误误判为try块中的错误。 - finally:无论是否发生异常、无论异常是否被捕获,甚至在
try或except中遇到了return,finally块中的代码都一定会执行。它常用于执行不可或缺的清理工作,如关闭文件、释放数据库连接或解除线程锁。
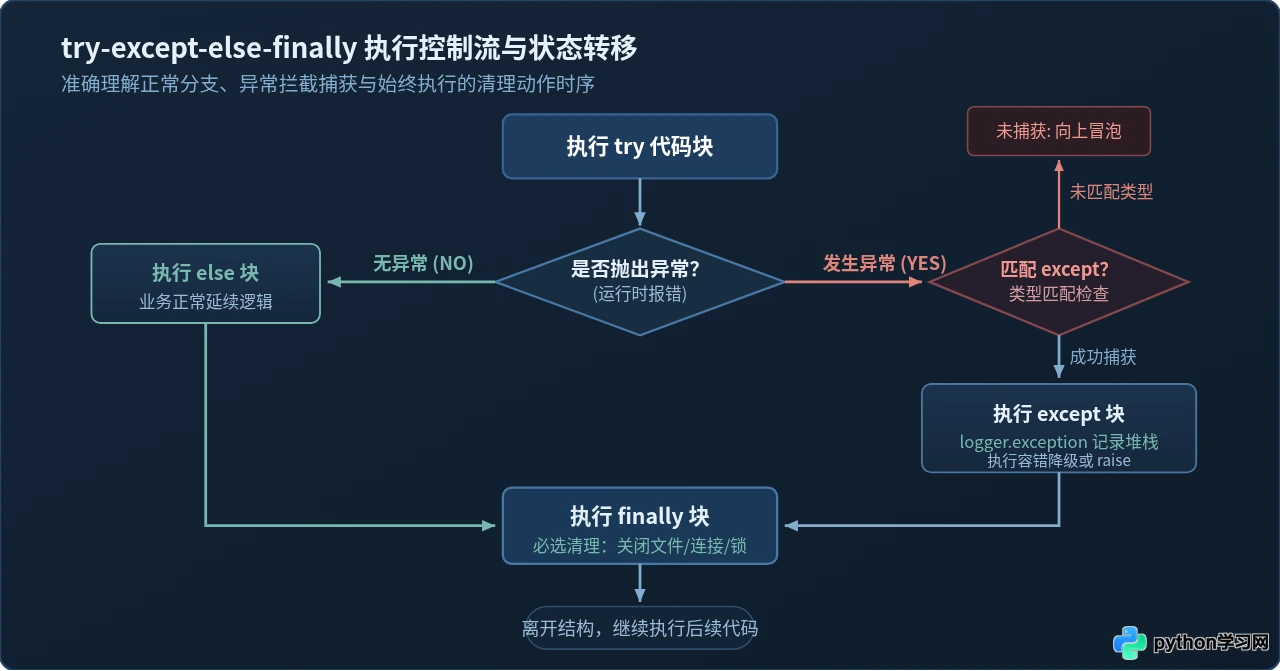
try 块的作用域尽可能小。只将真正可能抛出异常的 I/O、网络请求或数据类型转换放入 try,将后续依赖成功结果的数据清洗与展示逻辑放入 else。
二、异常捕获规范:为什么坚决拒绝裸写 except
在编写异常捕获时,最容易犯且危害最大的错误就是直接书写裸 except: 或 except: pass。在 Python 的异常继承体系中,顶层基类是 BaseException,所有常规业务错误继承自 Exception,而系统级信号(如用户在终端按 Ctrl+C 触发的 KeyboardInterrupt,以及调用退出函数的 SystemExit)则直接继承自 BaseException。
# 错误写法:裸 except 会捕获系统中断信号,导致终端无法正常终止程序
try:
    process_critical_data()
except:
    pass  # 吞没所有错误与中断信号,造成僵尸进程与数据黑洞
规范的捕获策略包含以下三个核心准则:
- 明确指定异常类型:根据调用的函数特性,精确捕获可预期的异常,例如文件操作捕获
FileNotFoundError,网络请求捕获requests.RequestException,数据类型转换捕获ValueError。 - 提取异常实例对象:使用
except SpecificError as e语法,将异常实例绑定到变量e,以便提取错误消息str(e)或类型名称。 - 兜底捕获必须使用 Exception:如果确实需要在一个保护区内防止任何未知业务崩溃,显式声明
except Exception as e:。这样既能兜底所有常规运行时错误,又不会误伤KeyboardInterrupt和SystemExit。
三、规范记录日志:标准库 logging 接入四步法
很多开发者在刚开始排查问题时习惯使用 print(e)。然而在生产环境或后台守护进程中,print() 存在致命缺陷:它没有时间戳、无法按严重级别分流、不支持自动切分文件、无法提供行号,且多线程并发时输出极易交错混乱。Python 标准库自带的 logging 模块是解决这一问题的专业工具。
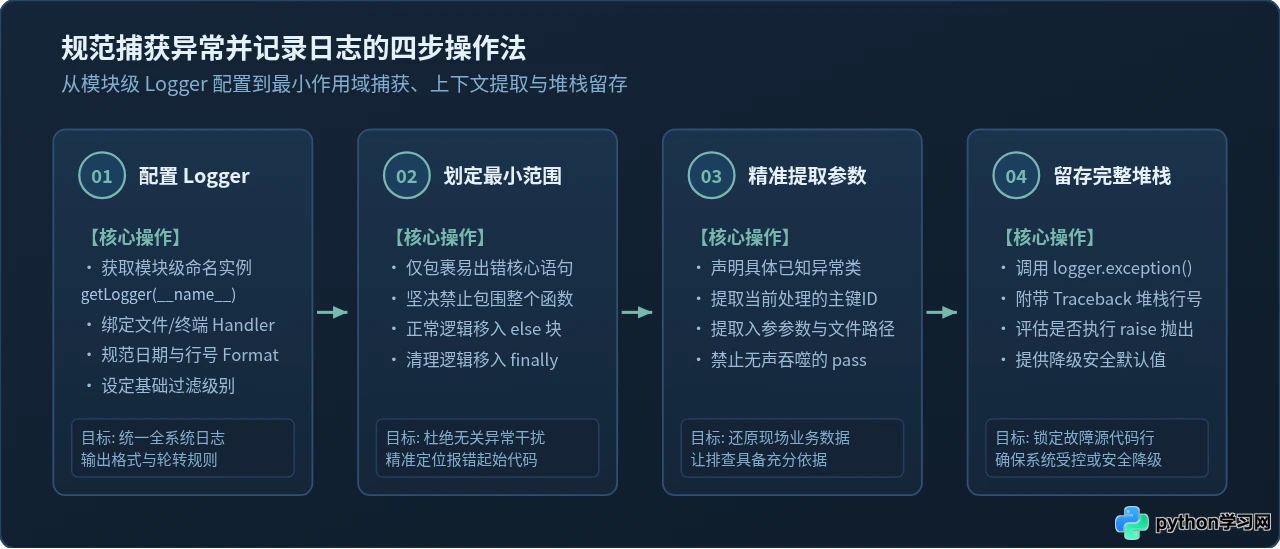
步骤一:创建模块级 Logger 并配置文件输出
避免在全局反复调用 logging.info(),应当在每个模块的开头通过 logging.getLogger(__name__) 获取具有层级命名空间的 Logger 实例,并为其配置带时间戳和行号的输出格式。
import logging
from logging.handlers import RotatingFileHandler

# 1. 获取以当前模块名为标识的 logger 实例
logger = logging.getLogger(__name__)
logger.setLevel(logging.DEBUG)  # 允许捕获的最低日志级别

# 2. 定义统一的日志格式(时间、级别、模块名、所在行号、消息)
log_formatter = logging.Formatter(
    fmt="%(asctime)s [%(levelname)s] [%(name)s:%(lineno)d] - %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)

# 3. 创建输出到控制台的 Handler
console_handler = logging.StreamHandler()
console_handler.setLevel(logging.INFO)
console_handler.setFormatter(log_formatter)

# 4. 创建自动滚动的文件 Handler(单文件最大 5MB,保留 3 个备份)
file_handler = RotatingFileHandler(
    filename="app_error.log",
    maxBytes=5 * 1024 * 1024,
    backupCount=3,
    encoding="utf-8"
)
file_handler.setLevel(logging.ERROR)
file_handler.setFormatter(log_formatter)

# 5. 绑定到 logger
if not logger.handlers:
    logger.addHandler(console_handler)
    logger.addHandler(file_handler)
步骤二与步骤三:划定最小范围并注入业务上下文
当异常发生时,单看错误类型往往不够,排查人员需要知道“究竟是在处理哪一个用户、哪张订单、哪个文件时报的错”。在 except 代码块中,应立即将当前迭代的关键参数拼接到日志文本中。
步骤四:使用 logger.exception 记录完整调用栈
这是异常处理中最核心的技巧:在 except 分支内部,直接调用 logger.exception(...)。该方法会自动调用 sys.exc_info(),在输出错误信息的同时,将完整的异常堆栈回溯(Traceback)完整写入日志。它等价于 logger.error(..., exc_info=True)。
四、信息维度对比:print vs logger.error vs logger.exception
理解为什么生产代码必须使用 logger.exception(),最直接的方法是对比它们在实际发生异常时记录的信息完整度。
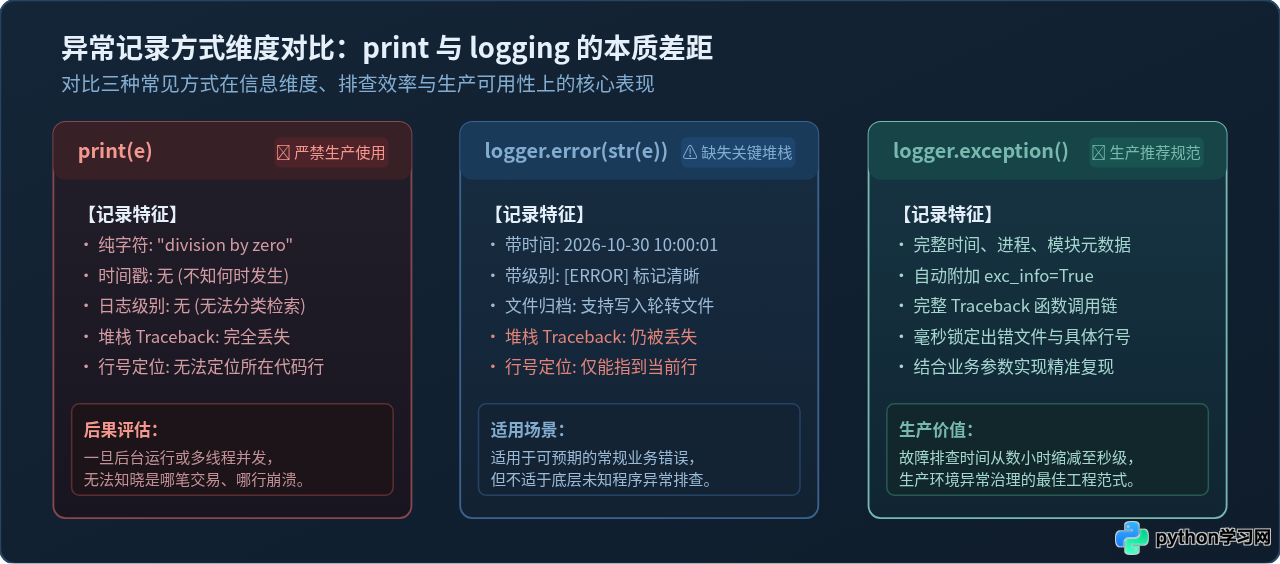
我们以一个除以零的计算异常为例,直观观察三者的输出差异:
| 记录方式 | 调用代码示例 | 实际日志输出效果 | 排查评价 |
|---|---|---|---|
print(e) |
print(f"出错: {e}") |
出错: division by zero |
丢失时间、级别、文件名和行号,无法在生产中定位故障点。 |
logger.error(e) |
logger.error(f"出错: {e}") |
2026-10-30 10:05:01 [ERROR] [calc:42] - 出错: division by zero |
包含时间和级别,但无调用链回溯,若错误发生在深层子函数中将无从查找。 |
logger.exception() |
logger.exception("计算失败") |
2026-10-30 10:05:01 [ERROR] [calc:42] - 计算失败
Traceback (most recent call last):
  File "worker.py", line 18, in run
    val = divide(a, b)
ZeroDivisionError: division by zero |
包含完整时间戳、模块元数据与多层函数回溯调用链,秒级定位报错代码行。 |
五、生产级实战完整代码示例
下面是一个符合生产规范的完整 Python 示例,模拟从本地磁盘批量读取 JSON 数据文件、执行解析并更新系统状态的过程。该示例演示了如何结合使用 try-except-else-finally 与 logging 记录详细上下文与堆栈。
import json
import logging
import os
import sys

# -------------------------------------------------------------
# 1. 初始化标准日志配置
# -------------------------------------------------------------
logger = logging.getLogger("BatchProcessor")
logger.setLevel(logging.DEBUG)

formatter = logging.Formatter(
    fmt="%(asctime)s [%(levelname)s] [%(name)s] - %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)

console_handler = logging.StreamHandler(sys.stdout)
console_handler.setFormatter(formatter)
if not logger.handlers:
    logger.addHandler(console_handler)

# -------------------------------------------------------------
# 2. 核心业务处理函数(带完整异常拦截与日志)
# -------------------------------------------------------------
def process_user_record(file_path: str, record_id: int) -> dict:
    """
    读取并解析指定用户的记录文件。
    演示精准捕获、业务参数注入、日志记录与资源释放。
    """
    file_obj = None
    logger.info("开始处理用户记录任务: RecordID=%d, FilePath=%s", record_id, file_path)

    try:
        # 仅将易发生 I/O 与解析错误的代码放入 try 块
        file_obj = open(file_path, "r", encoding="utf-8")
        data = json.load(file_obj)

        # 模拟可能出现的数据格式校验
        if "score" not in data:
            raise KeyError("数据包缺失必要字段: 'score'")

        score_value = float(data["score"])
        normalized_ratio = 100.0 / score_value  # 若 score_value 为 0 将引发 ZeroDivisionError

    except FileNotFoundError:
        # 精确捕获特定已知异常:记录 WARNING 级日志并返回默认占位数据
        logger.warning("目标记录文件不存在,跳过本次解析: RecordID=%d, Path=%s", record_id, file_path)
        return {"record_id": record_id, "status": "skipped", "reason": "file_not_found"}

    except (json.JSONDecodeError, KeyError) as e:
        # 数据格式畸变:记录 ERROR 级日志并附带完整堆栈
        logger.exception("数据格式畸变导致解析失败: RecordID=%d, ErrorType=%s", record_id, type(e).__name__)
        return {"record_id": record_id, "status": "failed", "reason": str(e)}

    except Exception as e:
        # 未预期的严重运行时异常:完整记录堆栈并重新抛出,防止脏数据入库
        logger.exception("处理记录时遭遇未知致命异常: RecordID=%d", record_id)
        raise

    else:
        # 当且仅当 try 内无任何异常时执行的逻辑
        logger.info("用户记录解析成功: RecordID=%d, NormalizedRatio=%.2f", record_id, normalized_ratio)
        return {"record_id": record_id, "status": "success", "ratio": normalized_ratio}

    finally:
        # 确保打开的文件句柄一定得到关闭释放
        if file_obj and not file_obj.closed:
            file_obj.close()
logger.debug("已安全关闭文件资源: Path=%s", file_path)2026-10-30 10:06:12 [INFO] [BatchProcessor] - 开始处理用户记录任务: RecordID=8041, FilePath=test_bad.json
2026-10-30 10:06:12 [ERROR] [BatchProcessor] - 数据格式畸变导致解析失败: RecordID=8041, ErrorType=JSONDecodeError
Traceback (most recent call last):
File "batch_data_loader.py", line 33, in process_user_record
data = json.load(file_obj)
File "/usr/lib/python3.9/json/__init__.py", line 293, in load
return loads(fp.read(),
File "/usr/lib/python3.9/json/__init__.py", line 346, in loads
return _default_decoder.decode(s)
json.decoder.JSONDecodeError: Expecting value: line 1 column 1 (char 0)
2026-10-30 10:06:12 [DEBUG] [BatchProcessor] - 已安全关闭文件资源: Path=test_bad.json六、异常处理与日志记录的最佳实践准则
在长期运行的 Python 系统中,异常处理与日志记录不仅关乎单一函数的正确性,更直接决定了系统的稳定性与运维可观测性。以下三项准则应当作为团队开发的固定基准:
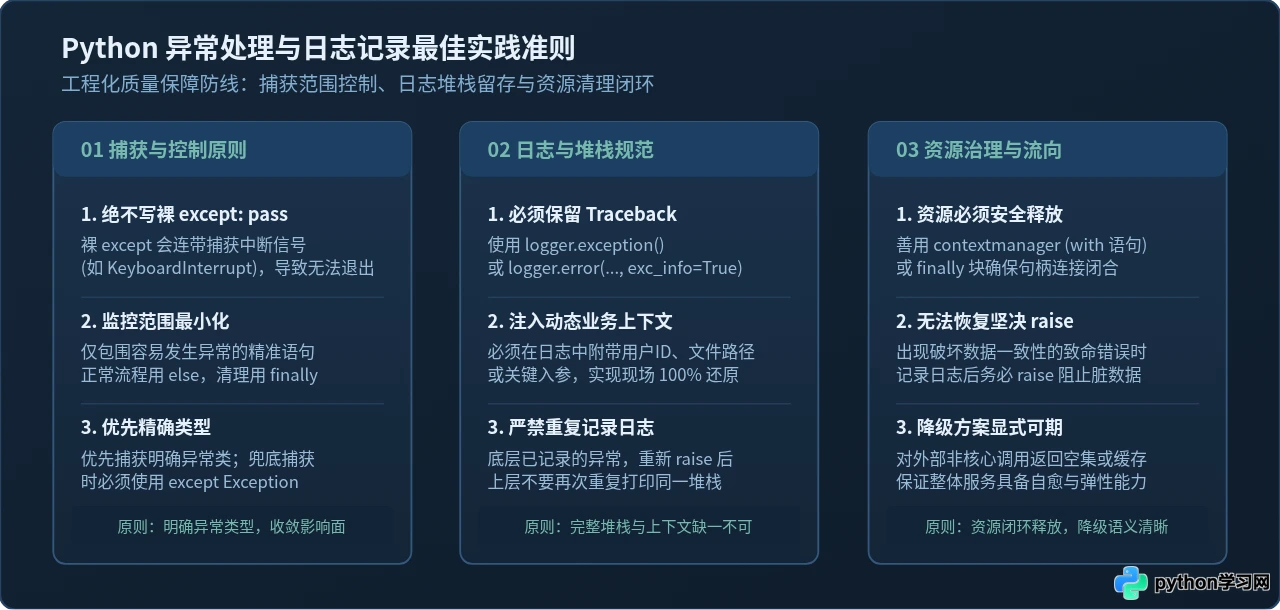
1. 捕获与控制原则
- 拒绝盲目吞没(Swallowing Exceptions):捕获异常后如果什么都不做(如
except: pass),不仅会让业务在不一致的状态下继续执行,更会切断所有排查线索。无论如何都必须至少记录一行包含上下文的日志。 - 捕获层级明确:底层库应当专注于抛出有意义的特定异常;业务层捕获后将其转换为带有上下文的错误日志或业务错误响应;应用最外层通过统一中间件进行最终
Exception兜底。
2. 日志记录原则
- 单一职责记录,避免堆栈风暴:如果在调用链的每一层都使用
logger.exception()记录同一处异常并层层向上raise,日志文件中就会出现数段完全相同的 Traceback 刷屏。原则是:要么在捕获处记录堆栈并就地解决/降级,要么向上传播交由上层统一记录,不要两处重复记录。 - 使用占位符而非字符串格式化拼接:记录日志时推荐使用
logger.error("用户 %s 登录失败", user_id),而不是logger.error(f"用户 {user_id} 登录失败")。前者由 logging 引擎在真正满足日志输出级别时才进行字符串插值计算,性能更优。
3. 资源治理原则
- 优先使用上下文管理器(with 语句):对于文件、网络套接字、互斥锁等资源,优先使用
with语句管理其生命周期。with内部自动封装了try...finally机制,即使在代码块中发生异常也能确保资源被可靠释放。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









