

Python怎么定义数组:列表list的创建与基本操作
全面解析在Python中如何使用列表list定义和实现动态数组,涵盖字面量创建、推导式构建、双向索引访问、切片提取、增删改查高频方法、二维数组避坑指南及数组技术选型。
在 Python 中,如果需要使用“数组”来按顺序存放一组数据,最标准、最直接且日常使用最广泛的方式是使用内置的列表(list)。Python 在语言核心层面没有像 C 或 Java 那样将原始定长数组作为基础类型,而是提供了高度优化的动态连续内存指针数组——list。本文将从列表的定义创建、元素读取切片、常见增删改查方法,到多维嵌套避坑与专业选型,系统化说明其实际操作方式与底层运作机制。
一、Python 中的“数组”本质:为什么优先使用列表 (list)
在很多编程语言(例如 C、C++、Java)中,“数组(Array)”意味着在内存中开辟一块连续空间,并且其长度固定、元素类型严格统一。初学 Python 的读者往往会寻找类似于 int array[10] 的语法,但实际上 Python 的设计哲学强调通用性与开发效率。
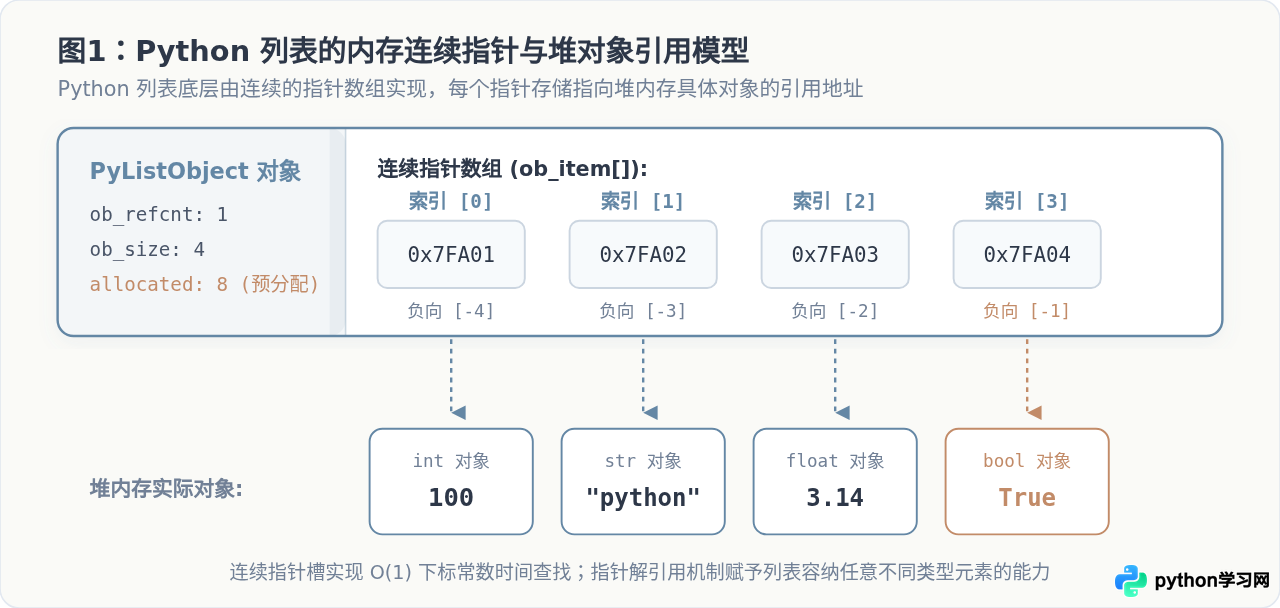
Python 原生内置的 list 就是一种高性能的动态数组(Dynamic Array)。它在底层实现上由 C 语言的结构体(PyListObject)管理,内部维护一个连续的引用地址数组(ob_item)。与传统静态数组相比,Python 列表具备三个核心特点:
- 动态扩容:创建列表时无需提前锁死容量,调用追加方法时 Python 会自动分配多余的空闲槽位,避免频繁申请内存。
- 支持异构对象:由于列表槽位中存储的是指向 Python 堆内存中具体对象的指针(地址引用),因此一个列表可以同时容纳整型、浮点型、字符串乃至另一个列表。
- 常数级随机访问:由于底层是指针的线性连续排列,根据索引(下标)读取或修改任意元素的时间复杂度均为
O(1)。
二、列表的定义与初始化方式
在 Python 中定义一个列表有多种常用方式,读者可以根据具体的业务场景、初始数据来源以及数据规模灵活选择。
1. 直接使用方括号字面量定义
这是最常用且运行效率最高的写法。直接用成对的英文方括号 [] 包裹元素,元素之间以半角逗号 , 分隔。
# 1. 定义空列表
empty_list = []

# 2. 定义包含初始整数的列表
scores = [88, 92, 79, 95]

# 3. 存储不同类型数据的异构列表
user_profile = ["Alice", 28, True, 3.14]
2. 使用内置函数 list() 进行类型转换
list() 构造函数可以将任何可迭代对象(Iterable,如字符串、元组 tuple、集合 set、字典的键、range 生成器等)转换为新的列表对象。
# 将字符串拆解为单字符列表
char_list = list("Python")

# 将 range 区间转为连续整数列表(生成 0 到 4)
number_sequence = list(range(5))

print("字符列表:", char_list)
print("连续数值:", number_sequence)连续数值: [0, 1, 2, 3, 4]
3. 利用乘法运算符创建固定长度默认值
如果需要在算法初始化阶段预分配一个长度为 N 且填充特定初始值(如 0 或 None)的列表,可以使用乘法运算符 *。
# 创建长度为 6、初始值全部为 0 的一维列表
zeros = [0] * 6
print("固定长度默认值列表:", zeros)4. 使用列表推导式(List Comprehension)
当需要按照特定数学公式或过滤规则生成列表时,列表推导式是 Python 最具表达力的语法特性之一。它的执行速度通常显著优于显式书写的 for 循环加 append 调用。
# 生成 0 到 9 之间所有偶数的平方
even_squares = [x ** 2 for x in range(10) if x % 2 == 0]
print("偶数平方列表:", even_squares)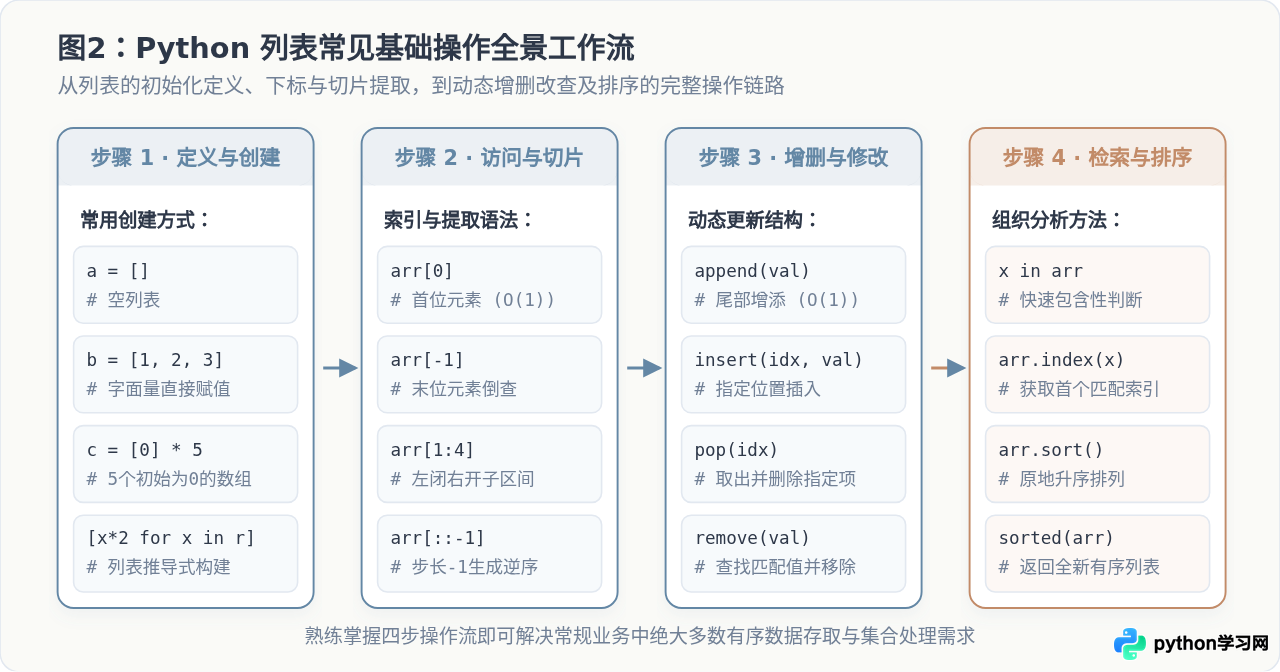
三、元素的索引访问与切片截取
定义好列表后,核心操作之一就是从列表中精确获取需要的数据。Python 提供了独特的正向与负向双向索引机制,以及功能强大的切片语法。
1. 正向与负向索引访问
正向索引从 0 开始递增,指向第一个元素;负向索引从 -1 开始递减,-1 永远代表列表的最后一个元素,-2 代表倒数第二个元素,依此类推。
fruits = ["苹果", "香蕉", "橙子", "草莓"]

print("首个元素 (索引 0):", fruits[0])
print("末尾元素 (索引 -1):", fruits[-1])
print("倒数第三个元素 (索引 -3):", fruits[-3])末尾元素 (索引 -1): 草莓
倒数第三个元素 (索引 -3): 香蕉
⚠️ 常见错误提醒:越界异常 IndexError
如果访问的索引超过了列表实际长度的边界(例如长度为 4 的列表访问 fruits[4] 或 fruits[-5]),Python 会立即抛出 IndexError: list index out of range。在不确定长度时,可以先用 len(fruits) 确认元素总数。
2. 切片截取:获取子列表
切片的基本语法结构为 list[start:stop:step],它遵循左闭右开原则,即包含 start 处的元素,但不包含 stop 处的元素;step 为提取步长,缺省默认为 1。
data = [10, 20, 30, 40, 50, 60, 70]

# 提取索引 1 到 4(不含 4)的子列表
print("切片 [1:4]:", data[1:4])

# 省略 start 代表从开头提取,省略 stop 代表一直提取到末尾
print("前3个元素 [:3]:", data[:3])
print("从第3项到末尾 [3:]:", data[3:])

# 步长为 2 间隔提取
print("隔项提取 [::2]:", data[::2])

# 步长为 -1 快速实现列表逆序反转
print("逆序切片 [::-1]:", data[::-1])前3个元素 [:3]: [10, 20, 30]
从第3项到末尾 [3:]: [40, 50, 60, 70]
隔项提取 [::2]: [10, 30, 50, 70]
逆序切片 [::-1]: [70, 60, 50, 40, 30, 20, 10]
四、列表核心操作:增、删、改、查与排序
列表是可变序列(Mutable Sequence),这意味着无需重新创建整个容器,即可就地修改其长度与内容。
1. 添加元素:append()、insert() 与 extend()
append(x):将元素x作为一个整体追加到列表尾部。平均耗时为O(1),是日常最推荐的添加方式。insert(i, x):在指定索引i前插入元素x。由于需要将i之后的所有元素指针整体后移一位,耗时为O(n)。extend(iterable):将另一个可迭代对象中的全部元素依次展开追加至末尾。注意与append的区别,append会把传入的列表作为子列表直接嵌套放进去。
items = ["A", "B"]

# 1. 尾部追加
items.append("C")
print("append 后:", items)

# 2. 索引 1 处插入
items.insert(1, "X")
print("insert 后:", items)

# 3. 批量合并扩展
items.extend(["D", "E"])
print("extend 后:", items)insert 后: ['A', 'X', 'B', 'C']
extend 后: ['A', 'X', 'B', 'C', 'D', 'E']
2. 删除元素:pop()、remove()、del 与 clear()
pop([i]):移除并返回指定索引i处的元素;若不传参数,默认移除并返回最后一个元素(O(1))。remove(x):从左向右搜索,移除首个值等于x的元素。若元素不存在,抛出ValueError。del 语句:不仅可以按单个索引删除(如del arr[0]),还可以批量删除一段切片区间(如del arr[1:3])。clear():清空列表中的所有元素,使其变为[]。
nums = [10, 20, 30, 20, 40]

# 弹出末尾项
popped_val = nums.pop()
print(f"弹出的值: {popped_val}, 弹出后的列表: {nums}")

# 删除第一个 20
nums.remove(20)
print("remove(20) 后的列表:", nums)

# 使用 del 删除指定下标
del nums[0]
print("del 后的列表:", nums)remove(20) 后的列表: [10, 30, 20]
del 后的列表: [30, 20]
3. 元素修改与存在性检查
修改元素只需要对指定下标进行直接赋值赋值;查询元素是否存在推荐使用 in 关键字;查找元素位置使用 index();统计频次使用 count()。
colors = ["red", "green", "blue"]

# 修改元素
colors[1] = "yellow"
print("修改后:", colors)

# 检查元素是否存在
print("blue 是否存在:", "blue" in colors)
print("pink 是否存在:", "pink" in colors)

# 获取索引与统计
print("yellow 的位置:", colors.index("yellow"))
print("red 出现的次数:", colors.count("red"))blue 是否存在: True
pink 是否存在: False
yellow 的位置: 1
red 出现的次数: 1
4. 列表排序:sort() 与 sorted()
对列表进行排序有两种常用工具,初学者应特别注意它们的返回值与是否改变原列表:
list.sort(key=None, reverse=False):原地排序方法,直接修改调用它的原列表,执行后返回值为None。sorted(iterable, key=None, reverse=False):内置通用函数,不改动原列表,排序后生成并返回一个全新的列表。
raw_nums = [42, 12, 88, 5, 23]

# 方式一:sorted 返回新列表,保留原列表不动
sorted_nums = sorted(raw_nums)
print("sorted 生成的新列表:", sorted_nums)
print("原列表不受影响:", raw_nums)

# 方式二:sort() 原地降序排序
raw_nums.sort(reverse=True)
print("调用 sort(reverse=True) 后原列表改变:", raw_nums)原列表不受影响: [42, 12, 88, 5, 23]
调用 sort(reverse=True) 后原列表改变: [88, 42, 23, 12, 5]
五、关键陷阱剖析:多维“数组”初始化的浅拷贝避坑
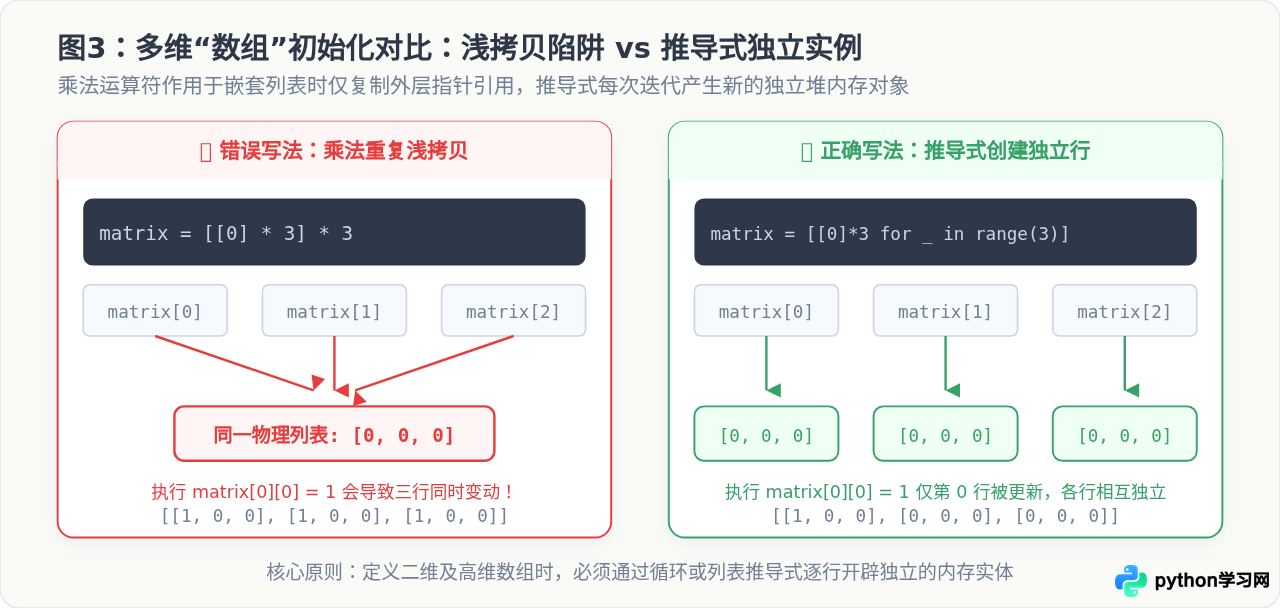
很多开发者在需要定义二维矩阵(例如 3 行 3 列全为 0 的网格)时,会直觉性地采用类似一维列表的乘法语法:matrix = [[0] * 3] * 3。这在 Python 中是一个极其隐蔽且高频出现的严重陷阱。
陷阱原因:外层的 * 3 并不是创建 3 个独立的一维列表,而是将内部列表 [0, 0, 0] 的内存引用地址重复复制了 3 份。换句话说,matrix[0]、matrix[1] 和 matrix[2] 指向的是堆内存中完全相同的同一个列表对象。
一旦对其中某一行进行赋值修改(例如 matrix[0][0] = 1),读者会惊讶地发现,所有 3 行的第一列都变成了 1!
# ❌ 错误示范:乘法复制导致引用共享
bad_matrix = [[0] * 3] * 3
bad_matrix[0][0] = 99
print("错误写法修改第一行后:", bad_matrix)

# ✅ 正确做法:使用列表推导式,每次循环都调用 [0] * 3 实例化一个全新对象
good_matrix = [[0] * 3 for _ in range(3)]
good_matrix[0][0] = 99
print("正确写法修改第一行后:", good_matrix)正确写法修改第一行后: [[99, 0, 0], [0, 0, 0], [0, 0, 0]]
六、数组技术选型与高频方法速查总结
在 Python 生态中,除了最常用的内置列表 list 外,针对特定规模与性能场景,标准库和第三方库还提供了其他“数组”载体。明确它们的适用边界,有助于写出兼顾开发效率与运行性能的代码。
| 数据结构 | 所属模块 | 底层存储机制 | 主要优势 | 最适场景 |
|---|---|---|---|---|
| list(列表) | 内置(Built-in) | 动态指针数组,存储对象指针 | 灵活强大、支持异构对象、API丰富 | 绝大多数日常开发、业务流程控制、常规集合 |
| array | 标准库 array |
连续同构内存,存储原始 C 类型数值 | 内存占用极其紧凑,紧贴 C 语言内存布局 | 受限内存设备、海量单类型基础数字(如百万级整数)存取 |
| ndarray | 第三方 NumPy |
多维连续内存块,基于 C/Fortran 底层优化 | 支持广播机制、多维矩阵运算、向量化高性能计算 | 科学计算、数据分析、机器学习与深度学习领域 |
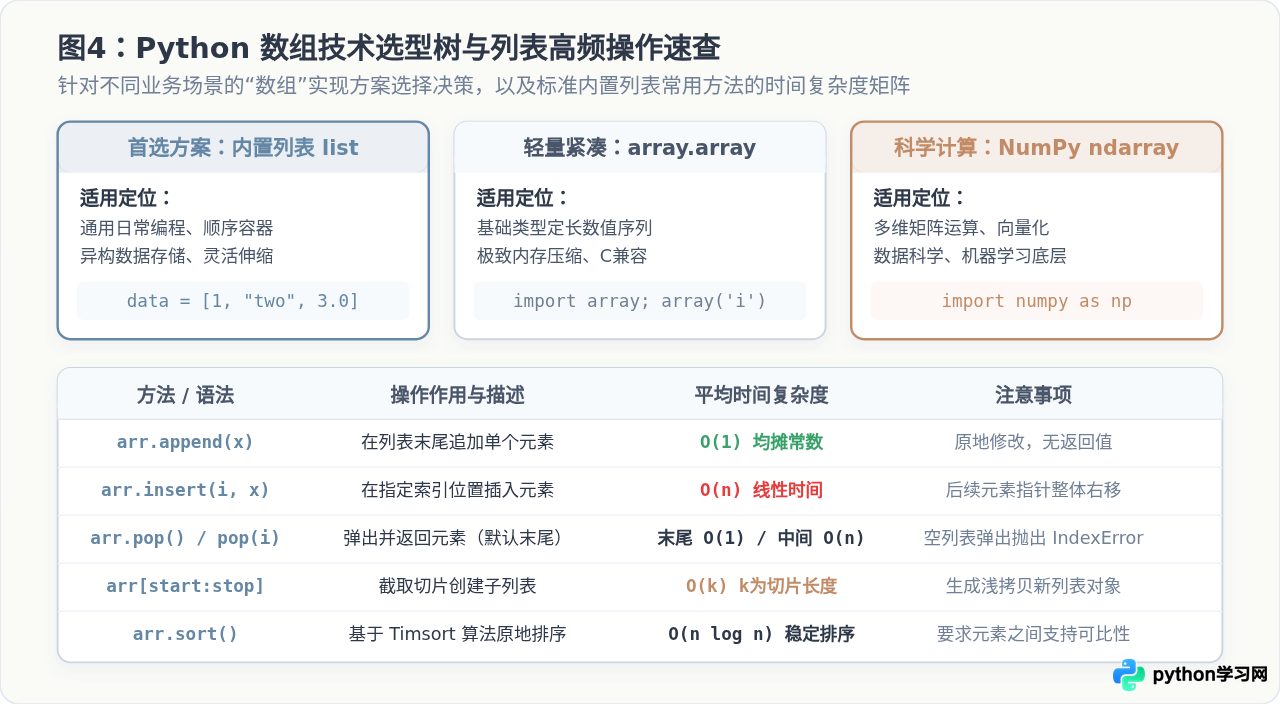
核心方法速查清单
- 创建:
arr = [](空列表)、arr = [1, 2, 3](字面量)、[0] * n(定长一维)、[expr for x in seq](推导式)。 - 读取与截取:
arr[0](首位)、arr[-1](末位)、arr[start:stop:step](切片,左闭右开)、arr[::-1](倒序)。 - 添加与扩展:
arr.append(val)(追加单项,O(1))、arr.extend(seq)(展平合并)、arr.insert(idx, val)(插入,O(n))。 - 删除与清空:
arr.pop()(弹出末位,O(1))、arr.remove(val)(按值删除首项)、del arr[i](按索引删除)、arr.clear()(清空)。 - 组织与排序:
arr.sort()(原地升序排序)、sorted(arr)(返回新有序列表)、len(arr)(获取长度)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









