

怎么用Python搭建机器学习模型推理API服务
本文详细介绍如何使用Python搭建机器学习模型推理API服务,涵盖模型持久化导出、FastAPI服务编写、Pydantic数据校验、服务预加载、并发调优及生产环境部署的完整实操指南。
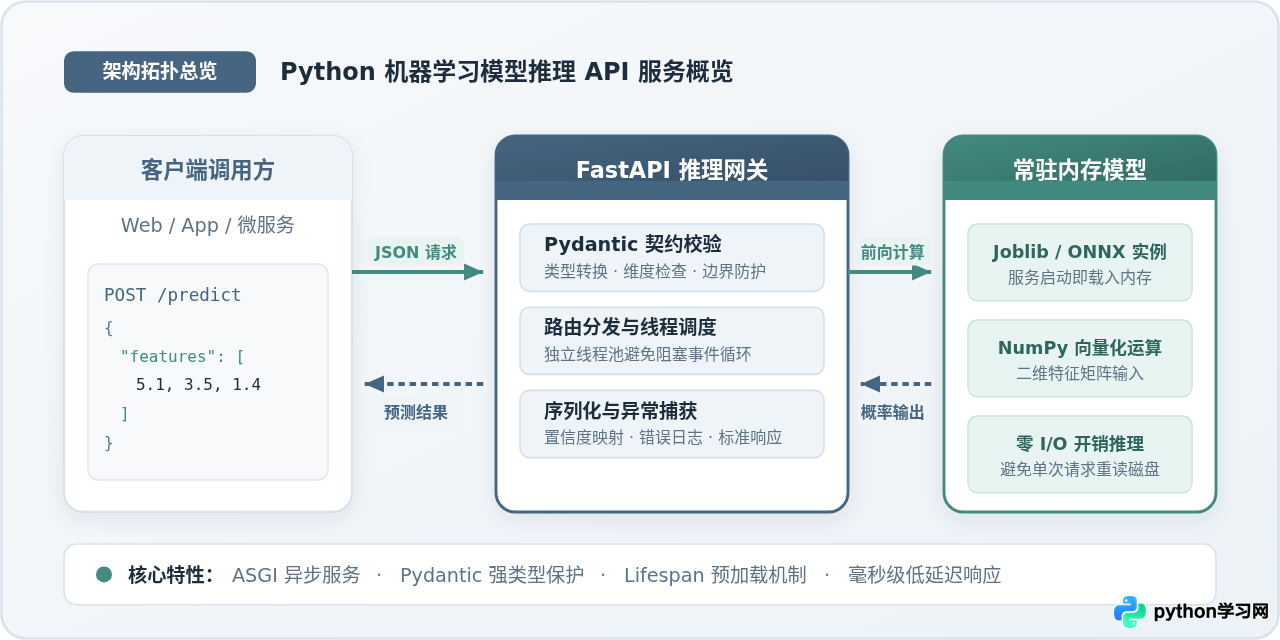
搭建机器学习模型推理 API 服务,核心是将离线训练好的模型权重载入常驻内存,借助现代 Web 框架(推荐使用高性能异步框架 FastAPI)封装出符合业务规范的 HTTP 接口,并通过 Pydantic 进行严格的请求参数校验,最终通过生产级 ASGI 服务器提供稳定、低延迟的在线预测能力。本文将从模型导出、服务编码、参数校验、接口调用到并发部署,完整讲解端到端的构建方法。
准备工作:训练并导出可持久化的机器学习模型
在编写 API 服务前,需要准备好已经完成离线训练的模型二进制文件。在 Python 机器学习生态中,Scikit-Learn 模型推荐使用 joblib 库进行序列化与反序列化,因为 joblib 针对大型 NumPy 数组内部的存储结构做了深度优化,读取与反序列化速度显著快于标准库中的 pickle。
以下示例以鸢尾花(Iris)分类模型为例,演示如何训练随机森林模型并持久化导出为 model.joblib:
# train_and_export.py
import joblib
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

def train_and_save():
    # 1. 加载数据集
    iris = load_iris()
    X, y = iris.data, iris.target

    # 2. 划分训练集与测试集
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # 3. 训练随机森林分类器
    clf = RandomForestClassifier(n_estimators=50, random_state=42)
    clf.fit(X_train, y_train)

    # 4. 验证基本测试集精度
    score = clf.score(X_test, y_test)
    print(f"模型测试集准确率: {score * 100:.2f}%")

    # 5. 持久化存储模型与标签元数据
    model_payload = {
        "model": clf,
        "target_names": iris.target_names.tolist(),
        "feature_names": iris.feature_names
    }
    joblib.dump(model_payload, "model.joblib")
    print("模型已成功导出为 model.joblib 文件")

if __name__ == "__main__":
train_and_save()关键设计要点:在打包导出模型时,建议将特征名称(feature_names)和目标类别名称(target_names)一并打包写入字典,避免在线推理服务硬编码分类索引与映射字典,减少后续迭代脱节的风险。
核心构建流程:从模型文件到在线服务
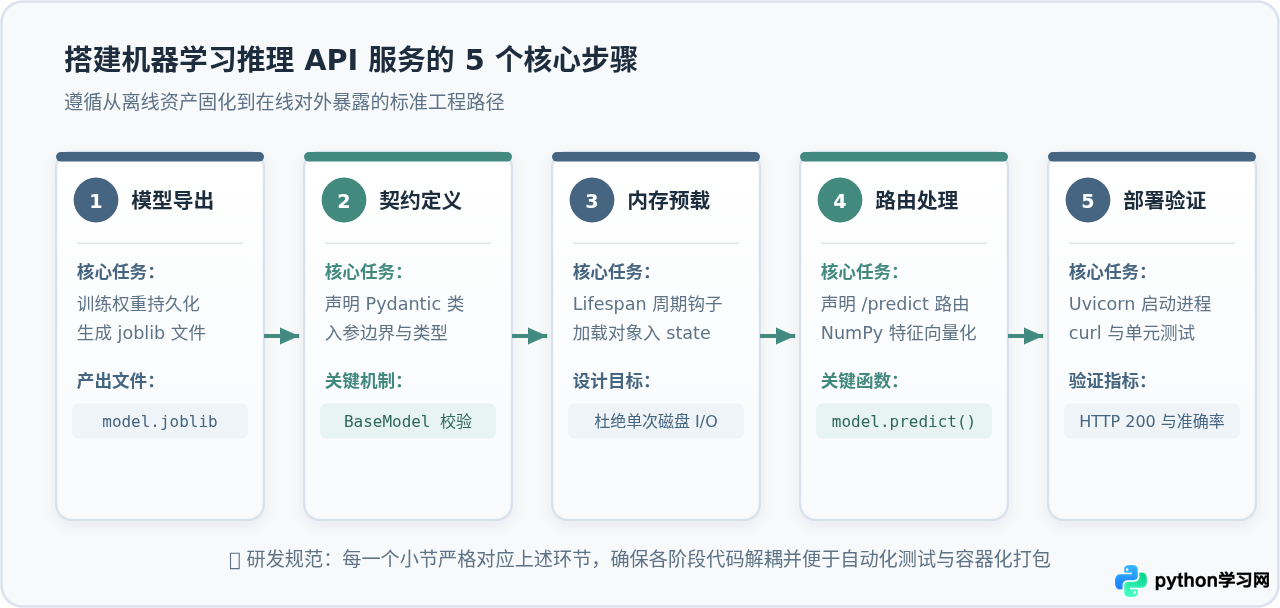
搭建在线推理服务的全过程可以清晰解构成五个标准阶段:模型离线导出、定义数据契约、内存预载初始化、路由业务计算以及运行验证。按照此流水线作业,能够确保代码具有良好的可测性与高吞吐特征。
编写核心推理服务(FastAPI 与 Pydantic)
使用 FastAPI 搭建推理服务主要包含三个技术关键点:
- 数据输入与输出契约:使用 Pydantic 声明请求体
BaseModel,对字段类型、取值范围进行严格约束,不合规的请求会在进入推理逻辑前直接被拦截并返回 422 状态码。 - 生命周期预加载(Lifespan):利用 FastAPI 推荐的
lifespan上下文管理器,在应用启动瞬间一次性完成模型的读取与内存初始化,确保每个后续请求都直接使用常驻内存中的模型对象,绝不每次请求读盘。 - 执行模式选择:虽然 FastAPI 擅长异步
async def,但常规机器学习模型的model.predict()是纯 CPU 密集型计算任务。如果在async def路由中直接执行长时 CPU 计算,会阻塞 asyncio 的底层单线程事件循环。因此,直接声明普通的同步函数def predict(...),FastAPI 会自动将其放入后台外部线程池中执行,保障整个服务的高并发吞吐。
创建服务文件 main.py,完整代码实现如下:
# main.py
import contextlib
import os
import joblib
import numpy as np
from typing import List
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

# 1. 定义数据契约 Schema
class IrisFeatures(BaseModel):
    sepal_length: float = Field(..., gt=0.0, description="花萼长度 (cm)")
    sepal_width: float = Field(..., gt=0.0, description="花萼宽度 (cm)")
    petal_length: float = Field(..., gt=0.0, description="花瓣长度 (cm)")
    petal_width: float = Field(..., gt=0.0, description="花瓣宽度 (cm)")

    class Config:
        json_schema_extra = {
            "example": {
                "sepal_length": 5.1,
                "sepal_width": 3.5,
                "petal_length": 1.4,
                "petal_width": 0.2
            }
        }

class PredictionResponse(BaseModel):
    predicted_class: str
    class_index: int
    confidence: float
    probabilities: dict

class BatchPredictRequest(BaseModel):
    instances: List[IrisFeatures]

# 2. 全局模型容器与生命周期管理
ml_models = {}

@contextlib.asynccontextmanager
async def lifespan(app: FastAPI):
    # 启动阶段:加载模型至内存
    model_path = os.getenv("MODEL_PATH", "model.joblib")
    if not os.path.exists(model_path):
        raise RuntimeError(f"模型文件不存在: {model_path},请先执行训练脚本")

    loaded_data = joblib.load(model_path)
    ml_models["model"] = loaded_data["model"]
    ml_models["target_names"] = loaded_data["target_names"]
    print(f"成功载入模型,支持预测类别: {ml_models['target_names']}")
    yield
    # 退出阶段:清理资源
    ml_models.clear()

# 3. 初始化 FastAPI 应用
app = FastAPI(
    title="机器学习模型推理 API 服务",
    description="基于 FastAPI 和 Scikit-Learn 的高吞吐预测服务",
    version="1.0.0",
    lifespan=lifespan
)

# 4. 健康检查与探针路由
@app.get("/health", status_code=status.HTTP_200_OK)
def health_check():
    if "model" not in ml_models:
        raise HTTPException(status_code=503, detail="模型未完成就绪加载")
    return {"status": "healthy", "model_ready": True}

# 5. 单样本预测路由 (采用 def 运行在线程池,防止阻塞事件循环)
@app.post("/predict", response_model=PredictionResponse)
def predict_single(payload: IrisFeatures):
    model = ml_models.get("model")
    target_names = ml_models.get("target_names")

    # 构造 2D NumPy 矩阵 (1, 4)
    input_vector = np.array([[
        payload.sepal_length,
        payload.sepal_width,
        payload.petal_length,
        payload.petal_width
    ]], dtype=np.float32)

    # 推理计算
    try:
        class_idx = int(model.predict(input_vector)[0])
        proba_list = model.predict_proba(input_vector)[0]
    except Exception as exc:
        raise HTTPException(status_code=500, detail=f"模型计算异常: {str(exc)}")

    # 封装概率字典
    prob_dict = {target_names[i]: float(proba_list[i]) for i in range(len(target_names))}
    confidence = float(proba_list[class_idx])

    return PredictionResponse(
        predicted_class=target_names[class_idx],
        class_index=class_idx,
        confidence=confidence,
        probabilities=prob_dict
    )
请求处理与张量转换内部机制
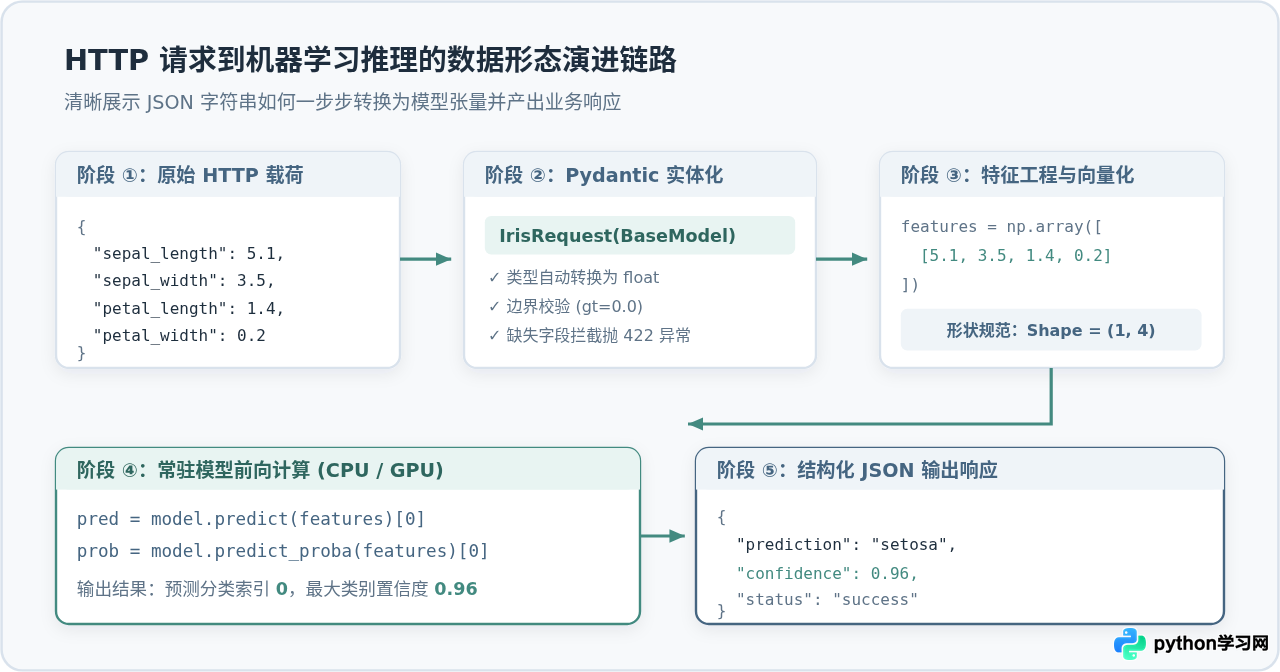
理解请求处理的核心在于弄清楚数据格式在不同环节的流转变化。网络传输层使用标准的 JSON 文本字符串;进入服务后由 Pydantic 反序列化并执行字段值验证;随后提取各特征值排列为模型期望的二维矩阵((N, 特征数));模型利用已学习到的树节点或权重完成矩阵相乘与决策逻辑,输出预测类别与各类别概率,最后被打包为响应模型转回 JSON 文本。
本地调试与接口验证
完成代码编写后,在终端中直接通过 uvicorn 命令启动本地测试服务器:
# 启动开发服务器(支持热重载)
uvicorn main:app --host 0.0.0.0 --port 8000 --reload
启动成功后,可在终端通过 curl 命令发送包含特征的 POST 请求,观察返回结果:
# 示例发送请求
curl -X POST "http://127.0.0.1:8000/predict"      -H "Content-Type: application/json"      -d '{"sepal_length": 5.1, "sepal_width": 3.5, "petal_length": 1.4, "petal_width": 0.2}'
终端返回的典型预测响应示例如下(明确标为示例输出):
# 示例返回结果
{
  "predicted_class": "setosa",
  "class_index": 0,
  "confidence": 1.0,
  "probabilities": {
    "setosa": 1.0,
    "versicolor": 0.0,
    "virginica": 0.0
  }
}
此外,FastAPI 会在后台自动生成符合 OpenAPI 标准的交互式文档。在浏览器中打开 http://127.0.0.1:8000/docs,即可直接在页面中测试参数填写与在线推理。
生产环境部署与并发性能调优
在生产环境中直接运行单个 uvicorn 进程难以充分压榨多核服务器的硬件性能,同时单个进程崩溃会导致服务中断。标准的生产部署方案是使用 Gunicorn 作为进程管理器(Master Process),搭配多个 Uvicorn Worker 处理具体请求。
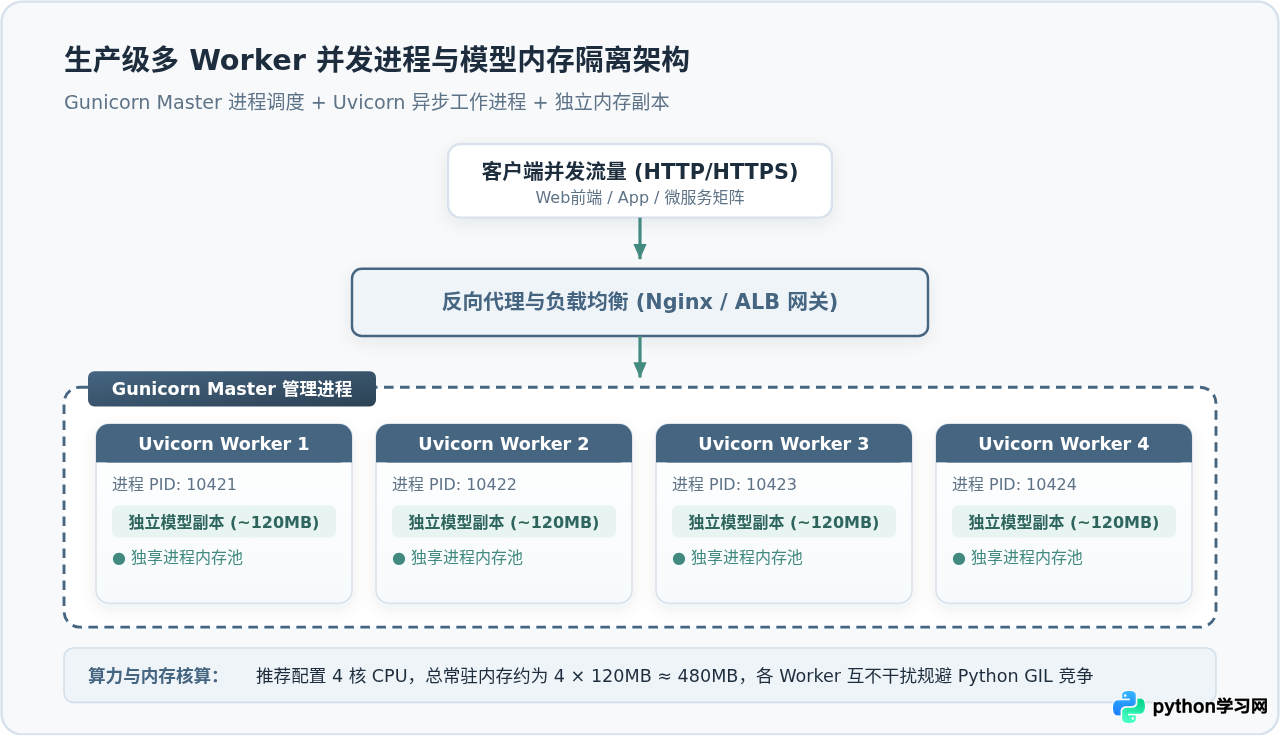
在服务器中执行如下生产启动命令:
# 生产启动命令:使用 4 个 Uvicorn 工作进程绑定到 8000 端口
gunicorn main:app     --workers 4     --worker-class uvicorn.workers.UvicornWorker     --bind 0.0.0.0:8000     --timeout 60     --access-logfile -     --error-logfile -
生产部署中的关键资源控制
- 内存占用预算:当启动
N个 Worker 时,操作系统会创建N个独立的 Python 进程。由于模型在各进程启动时均加载一次,总模型常驻内存等于单模型体积 × Worker 数量。在规划服务器配置时,必须预留至少 1.5 至 2 倍的模型内存余量,防止 Linux OOM Killer 杀掉工作进程。 - Worker 进程数设定:对于 CPU 密集型的模型推理,Worker 进程数建议设为服务器物理核心数的
1 到 2 倍(例如 4 核服务器设置 4 到 8 个 Worker)。过多的 Worker 会导致 CPU 频繁进行上下文切换,反而降低单次请求响应速度。 - 批量推理接口(Batching):当业务场景涉及高并发大量数据评估时,应提供接收特征列表的 Batch 接口。NumPy 对矩阵批量乘法(例如批量传入 64 条样本)拥有优异的 SIMD 向量化指令加速,吞吐量可达逐条单次推理的 5 到 10 倍。
生产就绪度检查清单与总结
完成编码与部署配置后,在正式接入生产流量前,可以通过以下 4 维检查矩阵进行逐项确认:
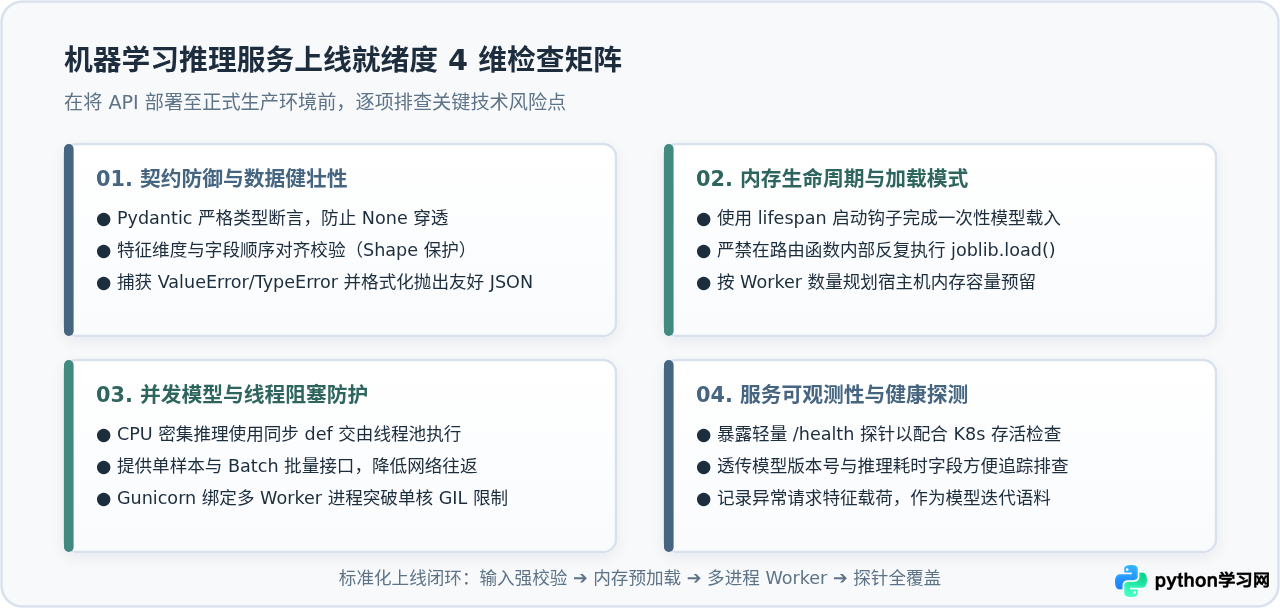
| 检查维度 | 核心规范要求 | 未达标潜在风险 |
|---|---|---|
| 数据输入 | 必须使用 Pydantic 显式校验字段类型、缺失值与数值界限 | 脏数据引发底层 C 库断言失败或服务静默崩溃 |
| 模型加载 | 必须使用 FastAPI lifespan 机制在启动时一次性加载模型 | 若在每个请求中重复读盘加载,单次延迟将骤增数百毫秒 |
| 并发模型 | CPU 推理代码采用同步 def,避免堵塞 asyncio 事件循环 |
长耗时预测任务导致健康检查、其他 I/O 路由全面超时卡死 |
| 探针观测 | 暴露轻量级 /health 接口,只校验模型是否就绪,不执行计算 |
网关轮询健康检查消耗过多模型算力,干扰正常在线预测流量 |
搭建机器学习模型推理 API 服务的本质,是在确定性的数据契约、高效的常驻内存结构与可靠的多进程调度之间建立平稳的协作管道。通过标准化模型持久化、规范输入校验并在生产环境中配置合理的多进程 Worker,即可低成本、高可靠地交付满足工业级生产要求的机器学习在线预测服务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









