

非程序员怎么用Python实现办公自动化和文件批量处理
面向非技术背景职场人士的实用指南:不需要从零死磕完整编程语法,重点掌握路径遍历、模式替换与表格合并三组操作原语,安全高效地实现文件批量处理与办公自动化。
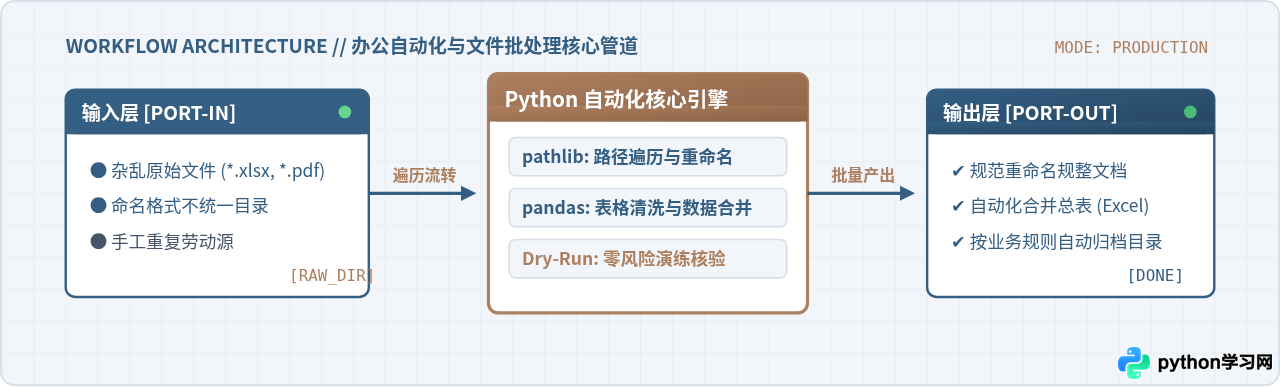
一、极简环境准备与运行方式
许多初学者往往被厚重的技术书籍吓退,误以为要先学面向对象、数据结构和复杂框架。实际上,完成日常文件批量操作与报表汇总,只需在电脑上完成两件事:安装Python运行环境,并学会让脚本读取指定文件夹。
1. 官方运行环境安装关键点
前往Python官方网站(python.org)下载最新的稳定版本安装包。在Windows系统运行安装程序时,第一界面底部有一项至关重要的复选框:Add python.exe to PATH(将Python添加到系统环境变量)。务必勾选该项后再点击“Install Now”。如果在安装时遗漏了此勾选,后续在命令提示符中直接输入指令将无法被操作系统识别。
安装完成后,打开系统的终端工具(Windows按Win+R输入cmd,macOS按Command+空格输入Terminal),输入以下命令检查是否安装成功:
python --version如果看到输出对应的版本号,说明环境已准备就绪。对于代码编写工具,初学者完全不需要配置复杂的技术插件,使用Python安装时自带的IDLE编辑器,或者轻量级的VS Code,新建一个后缀为.py的文本文件即可开始编写。
2. 安装处理表格所需的扩展库
Python标准库中自带了强大的文件与路径管理工具pathlib,不需要额外下载;而如果涉及Excel多表格合并,推荐使用数据处理领域广泛使用的pandas和openpyxl。在终端中执行以下命令进行安装:
pip install pandas openpyxl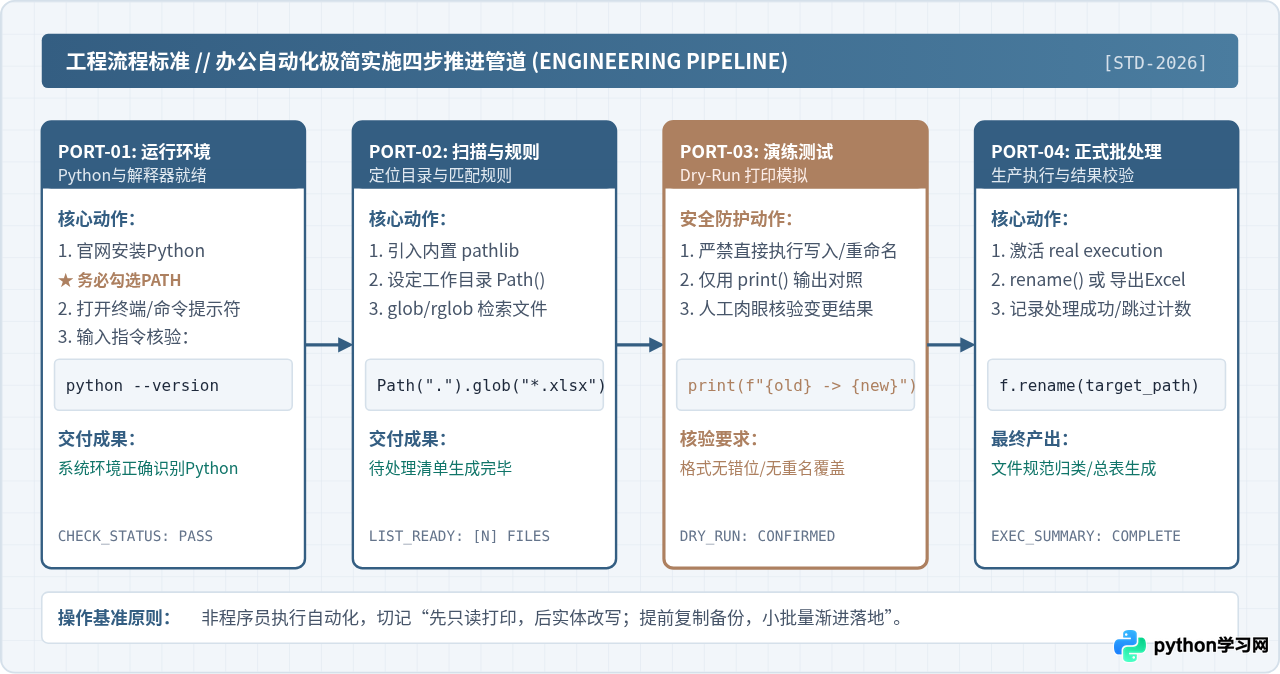
二、文件的批量查找、重命名与分类归档
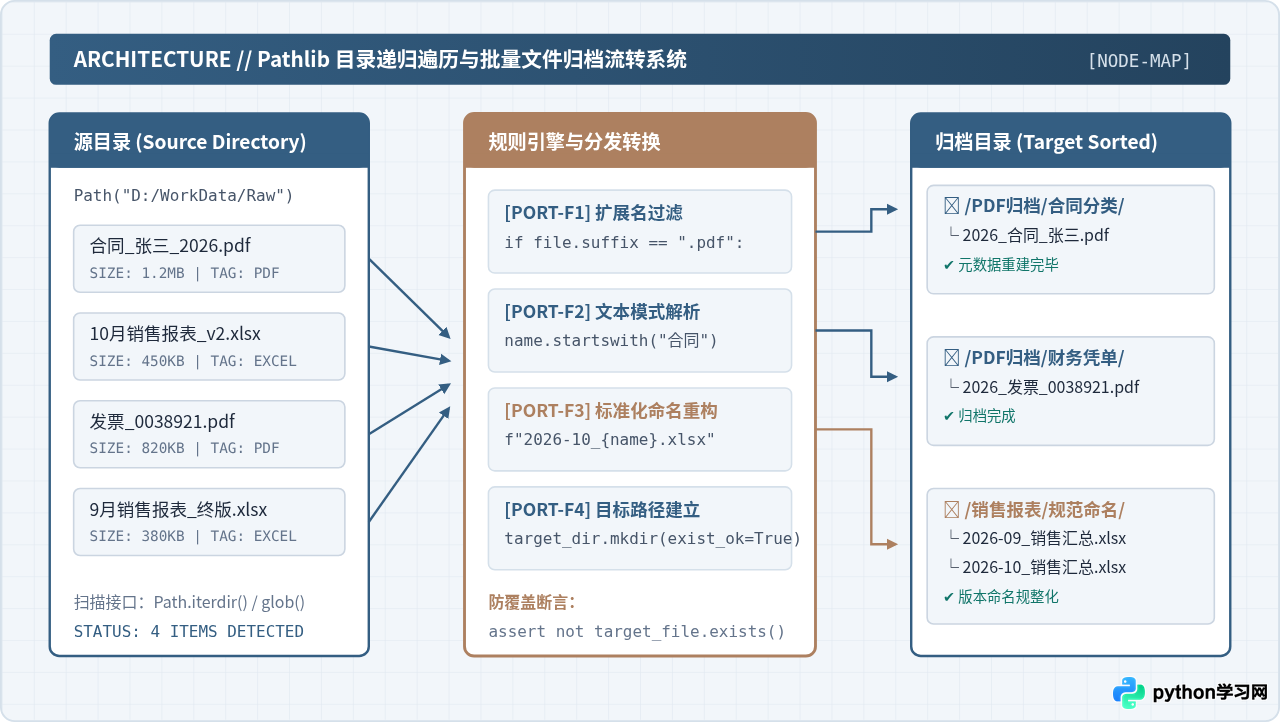
日常办公中最常见的重复劳动,是将不同人员提交的文件统一按照日期或规则重命名,或者把杂乱堆积在桌面、下载文件夹里的合同、票据、报表按类别分别存入对应的子文件夹中。利用Python内置的pathlib模块,代码可以精准表达“在哪个文件夹下找哪些文件,并改成什么名字”。
1. 文件遍历与规则替换的核心逻辑
pathlib.Path能将操作系统中的路径变成一个可以操作的对象。例如通过Path.glob()方法匹配特定格式的扩展名,通过循环逐一提取文件名、扩展名并拼接出目标名称。
下面是一份完整的批量给指定文件夹中所有Excel文件加上当前年份前缀的示例脚本:
from pathlib import Path

# 1. 指定待处理的目标文件夹(可使用相对路径或绝对路径)
work_dir = Path("D:/工作任务/2026年待整理报表")

# 2. 检查目录是否存在
if not work_dir.exists():
    print(f"错误:指定目录不存在 -> {work_dir}")
else:
    # 3. 使用 glob 筛选出所有 .xlsx 文件
    excel_files = list(work_dir.glob("*.xlsx"))
    print(f"共发现 {len(excel_files)} 个待处理的 Excel 文件。\n")

    # 4. 遍历并执行预演(Dry-Run)
    for file_path in excel_files:
        old_name = file_path.name

        # 如果文件名已经包含前缀,则跳过,避免重复添加
        if old_name.startswith("2026_"):
            continue

        new_name = f"2026_{old_name}"
        target_path = file_path.with_name(new_name)

        # 演练输出验证
        print(f"[演练匹配] 原文件名: {old_name}  -->  目标文件名: {new_name}")

        # 5. 正式执行重命名(确认打印无误后,解除下面这行代码的注释)
        # file_path.rename(target_path)

print("\n批处理演练完毕。")[演练匹配] 原文件名: 10月销售明细.xlsx --> 目标文件名: 2026_10月销售明细.xlsx
[演练匹配] 原文件名: 华东区盘点表.xlsx --> 目标文件名: 2026_华东区盘点表.xlsx
[演练匹配] 原文件名: 供应商对账单.xlsx --> 目标文件名: 2026_供应商对账单.xlsx
批处理演练完毕。
2. 自动创建文件夹并归类转移
如果需要把文件移动到归档文件夹中,只需使用target_dir.mkdir(parents=True, exist_ok=True)创建目录,随后将目标路径作为参数传给rename()即可完成跨目录剪切移动。exist_ok=True参数的作用是:如果目标目录已经存在,程序不会报错中断,而是直接继续执行。
三、多表格(Excel/CSV)数据自动读取与合并
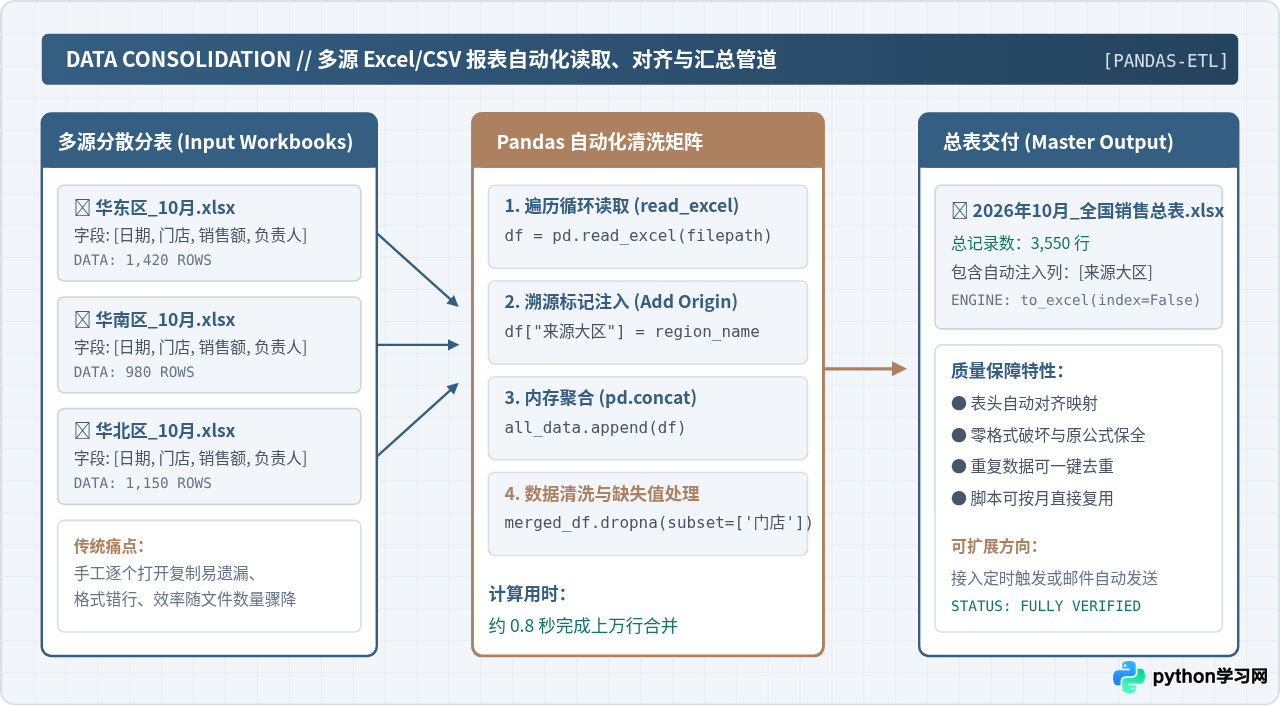
在汇总月度、季度或各分公司上报的数据时,人工操作通常需要:逐个双击打开文件、按快捷键全选复制、切换到汇总总表、向下滚动到空白行粘贴,重复几十次极易疲劳且容易遗漏某一行。用Python完成这项任务,耗时通常只需数秒钟。
1. 批量合并表格的关键条件
脚本要能将多个表格拼成一个总表,要求各个分表具有相同或兼容的表头字段(例如每张表的第一行都有“日期”、“门店名称”、“销售额”、“负责人”)。Pandas在读取表格时会自动把第一行识别为列名,并在内存中进行列对齐。
2. 完整合并代码实现
下面的脚本会自动扫描指定文件夹下的所有分表,将每张表的数据读取为内存数据块(DataFrame),同时自动添加一列“数据来源文件”,最后统一拼成一张总表并保存到新文件中:
from pathlib import Path
import pandas as pd

folder_path = Path("D:/工作任务/各区10月上报分表")
output_file = folder_path / "2026年10月_全国销售汇总总表.xlsx"

all_data = []

# 遍历目录下所有 .xlsx 文件,排除可能已经生成的汇总总表
for file_path in folder_path.glob("*.xlsx"):
    if file_path.name == output_file.name:
        continue

    print(f"正在读取并校验: {file_path.name}")
    try:
        # 读取当前表格的第一张工作表
        df = pd.read_excel(file_path)

        # 注入来源列,方便后续核对数据来源
        df["数据来源分表"] = file_path.name

        all_data.append(df)
    except Exception as e:
        print(f"读取 {file_path.name} 失败,错误原因: {e}")

if all_data:
    # 纵向拼接所有分表数据
    merged_df = pd.concat(all_data, ignore_index=True)

    # 导出到总表,不保留自动生成的数字索引列
    merged_df.to_excel(output_file, index=False)
    print(f"\n汇总完成!总行数: {len(merged_df)} 行,已保存至: {output_file.name}")
else:
print("未找到任何有效表格文件。")正在读取并校验: 华南区_10月.xlsx
正在读取并校验: 华北区_10月.xlsx
汇总完成!总行数: 3550 行,已保存至: 2026年10月_全国销售汇总总表.xlsx
通过这段代码,无论文件夹中有3个分表还是300个分表,执行时间均只在几秒到十几秒之间,彻底免去了机械复制粘贴的繁琐过程。
四、Word与PDF等日常文档的批量辅助处理
除了Excel表格外,办公场景中还经常遇到两类批量文档需求:一是根据Excel名单批量生成带名字的Word通知书或合同(套红发文);二是把几十份分散的PDF扫描件合并为一个完整的PDF文件。
1. 批量生成Word文档思路
使用第三方库python-docx,可以预先制作一份Word模板,将需要变化的内容标记为占位符(例如{姓名}、{金额})。脚本通过Pandas读取员工名单Excel表,循环读取每一行数据,替换模板中的占位符并以对应员工姓名另存为新的Word文件。100份个性化证明文件的生成通常在1分钟内即可完成。
2. PDF批量合并基础
借助开源库pypdf,通过循环把每个PDF文件的所有页面追加到同一个PdfWriter对象中,最后写出为一个完整文件。这对于报销发票装订、归档材料合订非常实用。
五、非程序员避免翻车的四项安全守则
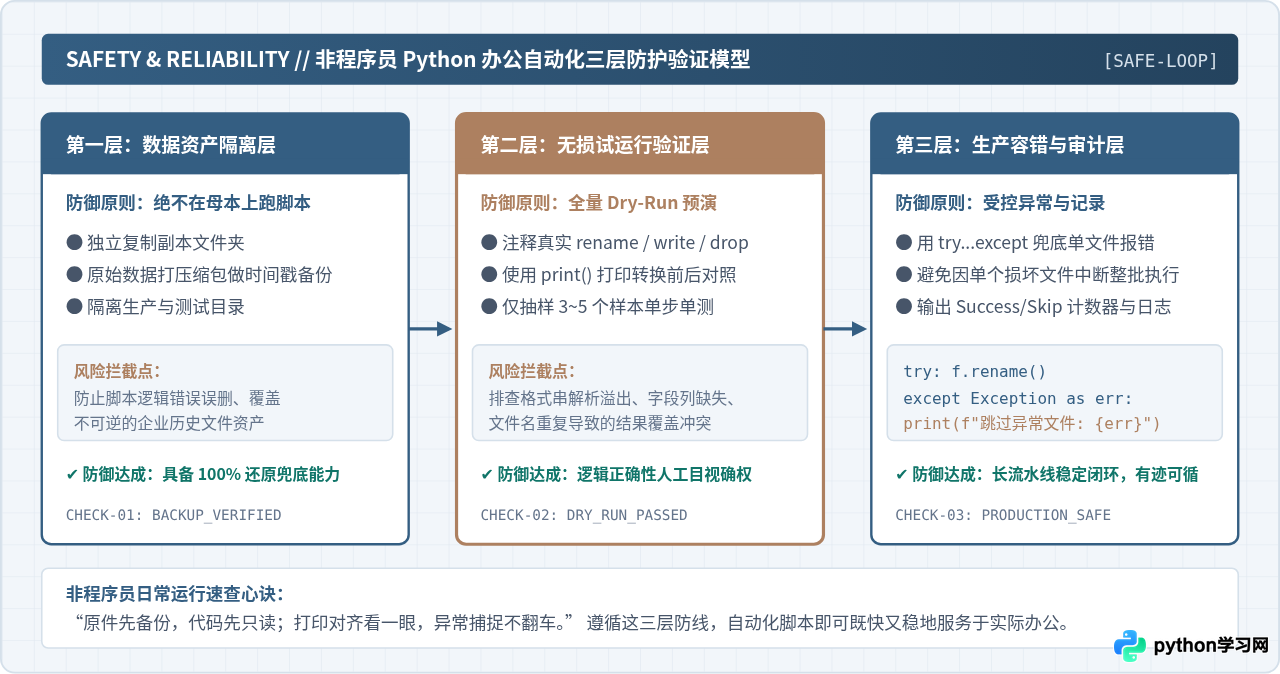
编程脚本与手动操作最大的不同在于“执行速度极快”。手动操作哪怕做错了,改两三个文件就能察觉;而错误的脚本一秒钟可能已经修改或覆盖了数百个文件。为了杜绝风险,必须牢记以下四项操作守则:
- 操作前建立备份隔离区:永远不要直接在唯一的原始业务文件夹上运行脚本。操作前,先把整个文件夹按“Ctrl+C、Ctrl+V”复制一份作为备份,或者将原始文件归档为压缩包。
- 坚持“先只读打印,后实体改写”:在涉及
rename()(重命名)、unlink()(删除文件)等写操作前,先用print()把拟修改的内容打印到控制台,逐行检查是否有乱码、空值或格式错位。 - 目标路径防冲突检查:在移动或重命名时,如果目标文件名已经存在,直接覆盖会导致旧文件丢失。可以使用
if target_path.exists():先行判断,若存在则跳过或自动追加序号后缀。 - 使用异常捕获(try...except):在遍历大量文件的循环中,个别文件可能因损坏、被其他软件打开占用(如Excel提示只读锁定)而引发异常。用
try...except包裹核心操作,确保单个文件的异常只记录错误日志,而不中断整批自动化流程的执行。
六、总结与循序渐进的落地路径
非程序员学习Python办公自动化,切忌把精力分散在脱离实际业务的抽象语法上。最高效的学习路径是以具体任务为导向:今天需要批量改名,就只查Pathlib的重命名语法;明天需要多表拼接,就只掌握Pandas的concat方法。随着一个个具体繁琐问题的解决,脚本不仅能够即刻节省大量工时,还能通过代码沉淀出一套稳定、可重复调用的个人办公工具箱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









