

Python读取Excel文件:pandas与openpyxl库的选择及基础用法

在 Python 中读取和处理 Excel 文件,最常用的两个第三方库是 pandas 和 openpyxl。许多初学者常对这两个库产生混淆,不清楚在何种业务场景下该使用哪一个。本文将直接切入两者的核心分工与设计机制,给出明确的技术选型决策树,并详细演示各自的标准基础语法、常用参数与高频避坑要点,帮助读者在实际项目中做出合理高效的选择。
一、核心定位与技术选型:如何做决定
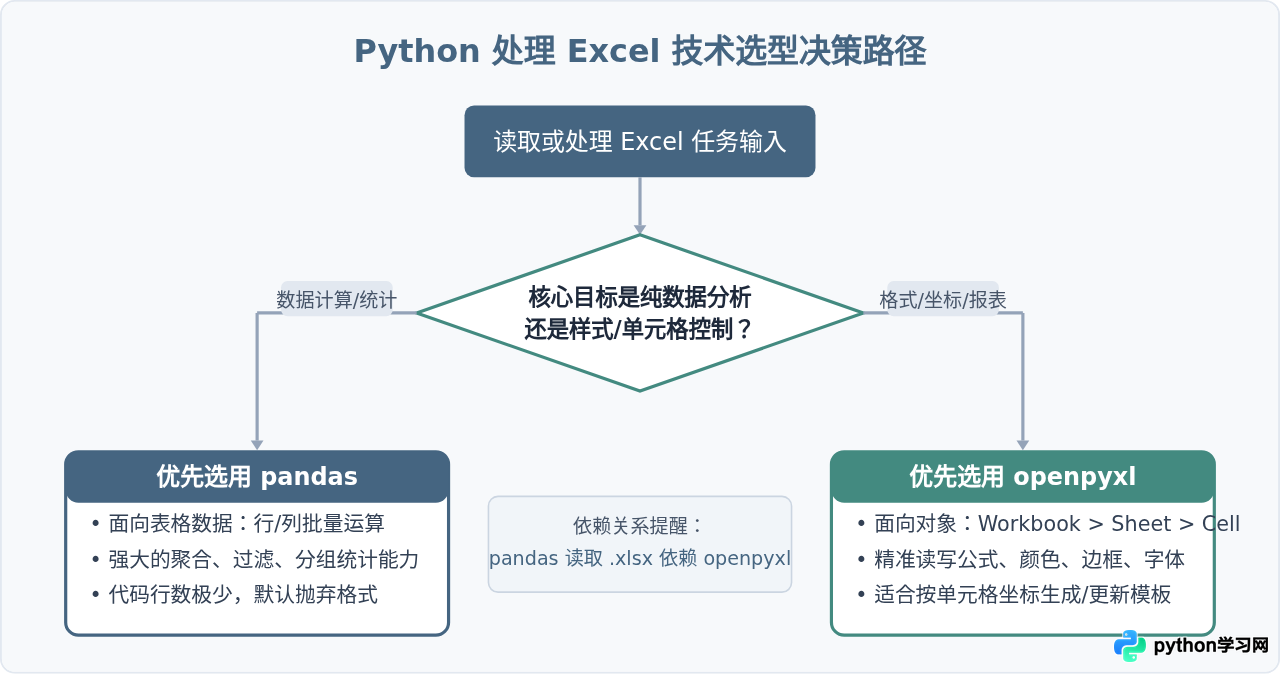
选择库的关键在于明确你的业务目标是“分析表格中的结构化数据”,还是“控制 Excel 文件本身的模型与样式”。
- pandas 的核心定位:数据清洗与统计分析。它将 Excel 视作二维表格数据源,读取后直接转化为高性能的 DataFrame 对象。如果你需要进行统计聚合、缺失值填充、过滤筛选、数据合并或与 SQL/CSV 互通,pandas 是最高效的选择。需要注意的是,pandas 底层读取
.xlsx文件时并不直接解析二进制流,而是默认调用openpyxl等解析引擎作为后端依赖。 - openpyxl 的核心定位:Excel 文档对象模型(DOM)的精细控制。它忠实映射了工作簿(Workbook)、工作表(Worksheet)、单元格(Cell)以及对应的样式、字体、边框、公式和图表等属性。如果你的任务涉及保留单元格格式、按具体行列坐标修改、处理单元格合并,或是生成带定制样式的业务报表,openpyxl 是唯一合适的选择。
二、环境安装与基础依赖准备
在开始编写代码前,需要在当前的 Python 环境中安装对应的依赖包。推荐通过 pip 统一安装:
# 仅使用 openpyxl
pip install openpyxl

# 使用 pandas 读取 Excel(需一并安装 openpyxl 作为引擎)
pip install pandas openpyxl
如果使用的是老旧的 .xls 格式(Excel 97-2003),需要额外安装 xlrd 库。但在现代工作流中,绝大多数文件都是基于 OpenXML 标准的 .xlsx 格式,安装 pandas 和 openpyxl 即可覆盖全部主流需求。
三、pandas 读取 Excel 的基础用法与高频参数
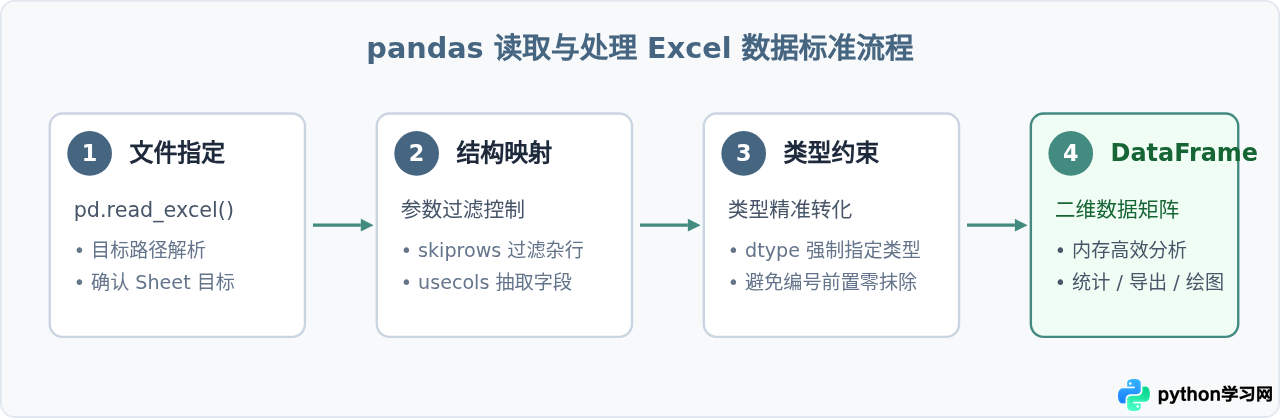
pandas 读取 Excel 最核心的入口函数是 pd.read_excel()。它默认将第一行作为列标题(表头),将其余内容构造为 DataFrame。
1. 基础读取与指定工作表
在默认情况下,函数会读取工作簿中的第一个工作表:
import pandas as pd

# 读取第一个工作表
df = pd.read_excel("sales_data.xlsx")

# 打印前 5 行及基本数据结构
print("数据概览:")
print(df.head())
print("\n各列字段类型:")
print(df.dtypes)
如果 Excel 中包含多个 Sheet,可以使用 sheet_name 参数精确定位:
# 按工作表名称读取
df_dept = pd.read_excel("sales_data.xlsx", sheet_name="部门汇总")

# 按工作表索引读取(0 表示第一个表)
df_first = pd.read_excel("sales_data.xlsx", sheet_name=0)

# 读取多个工作表,返回字典(键为表名,值为对应 DataFrame)
all_sheets = pd.read_excel("sales_data.xlsx", sheet_name=["2025年", "2026年"])
df_2026 = all_sheets["2026年"]

# 传入 None 读取所有工作表
all_sheets_dict = pd.read_excel("sales_data.xlsx", sheet_name=None)
2. 常用筛选与优化参数
面对非标准版式的表格(例如前两行是标题装饰文字、只需要特定列或需要保留长文本格式),可以通过以下参数精确调整读取过程:
df_custom = pd.read_excel(
    "sales_data.xlsx",
    sheet_name="订单明细",
    skiprows=2,           # 跳过前 2 行无效标题
    nrows=1000,           # 仅读取前 1000 行
    usecols=["订单号", "销售额", "下单时间", "客户电话"], # 仅载入指定列
    dtype={"客户电话": str, "订单号": str}            # 强制指定类型,防止电话号码前置 0 丢失
)
四、openpyxl 读取 Excel 的基础用法与单元格控制
openpyxl 不会将数据直接打包为扁平的二维表,而是将文档展开为三层对象体系:Workbook(工作簿) > Worksheet(工作表) > Cell(单元格)。
1. 加载工作簿与获取工作表
from openpyxl import load_workbook

# 加载现有的 Excel 工作簿
wb = load_workbook("sales_data.xlsx")

# 获取工作簿内所有工作表名称列表
sheet_names = wb.sheetnames
print("工作表列表:", sheet_names)

# 获取活跃的工作表(用户保存时停留的那个表)
ws_active = wb.active

# 按照名称获取指定工作表
ws = wb["订单明细"]
2. 访问单个单元格及其属性
在 openpyxl 中,可以通过类似 Excel 坐标的字符串(如 A1)或行列数值索引(行和列索引均从 1 开始)定位单元格:
# 方式一:坐标索引法
cell_a1 = ws["A1"]
print("A1 的值:", cell_a1.value)

# 方式二:行列数字索引法(row=1, column=2 对应 B1)
cell_b1 = ws.cell(row=1, column=2)
print("B1 的值:", cell_b1.value)

# 读取单元格元数据信息(不仅是值)
print("数据类型:", cell_a1.data_type)
print("坐标:", cell_a1.coordinate)
if cell_a1.font:
    print("字体名称:", cell_a1.font.name)
    print("是否加粗:", cell_a1.font.bold)
3. 遍历读取数据区域(iter_rows)
读取多行数据时,推荐使用 iter_rows() 方法。设置 values_only=True 可以跳过单元格对象的构建开销,直接返回纯数据元组:
# 遍历第 2 行到第 10 行、第 1 列到第 4 列的数据
for row in ws.iter_rows(min_row=2, max_row=10, min_col=1, max_col=4, values_only=True):
    order_id, amount, date_val, customer = row
    print(f"订单: {order_id}, 金额: {amount}, 客户: {customer}")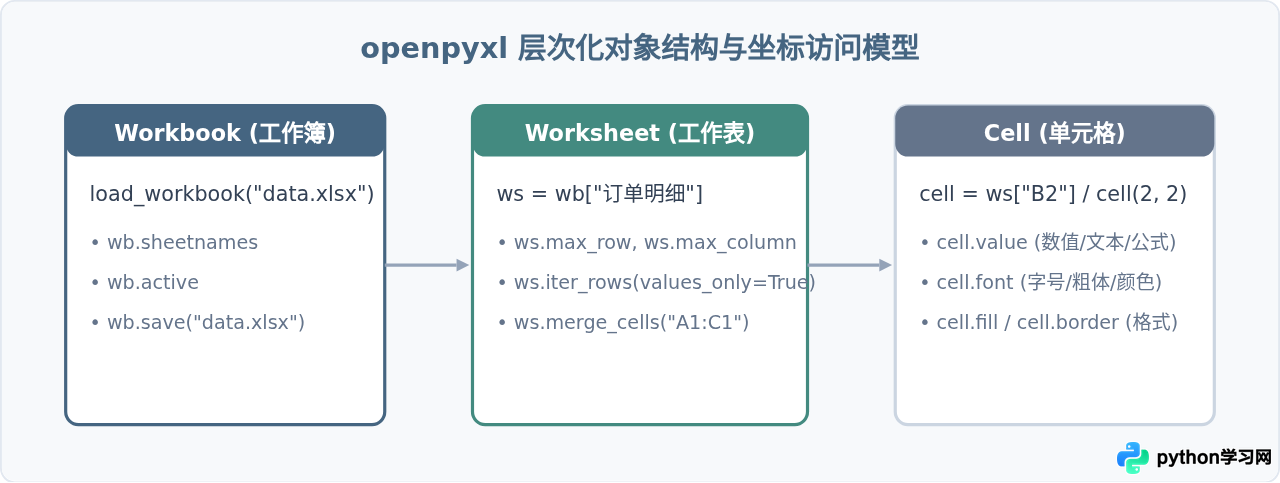
五、实战避坑指南与常见问题解析
1. 公式计算结果为 None 或返回公式字符串
在 openpyxl 中,默认加载文件时只会读取公式的字面表达式(例如 =SUM(A1:A10)),而不是其计算结果。如果你需要读取 Excel 计算出的具体数值,需要在加载时显式传入 data_only=True:
# 取得公式计算结果而非公式文本
wb_val = load_workbook("sales_data.xlsx", data_only=True)
ws_val = wb_val["订单明细"]
print("总计结果:", ws_val["E10"].value)Excel 本身在保存文件时会将计算结果缓存到 XML 中。如果是第三方程序生成的 Excel 或未经真实 Excel 打开并保存过的带公式文件,data_only=True 读取出的结果可能会是 None。如果必须通过 Python 自动计算未知公式,需要借助 Windows 本地 COM 接口(如 pywin32)或第三方公式引擎。
2. 大文件读取引发的内存耗尽问题
当 Excel 文件达到几十万行或上百兆时,将整个文档完整加载到内存中极易发生内存溢出(OOM)。针对大文件,两个库各有应对方案:
- openpyxl 只读模式:在
load_workbook()中开启read_only=True。此时库会采用流式生成器逐行解析 XML,不会将所有单元格对象保存在内存中,内存占用稳定且极低:
# 开启流式只读,适合几十万行大文件
wb_stream = load_workbook("huge_data.xlsx", read_only=True)
ws_stream = wb_stream.active
for row in ws_stream.iter_rows(values_only=True):
    pass # 逐行流式消费数据
wb_stream.close() # 只读模式使用后建议显式关闭- pandas 分块策略或列裁剪:利用
usecols只加载目标列,或者先在数据入库阶段转为 CSV/Parquet 格式。对于超大型纯数据计算,直接使用 Parquet 文件相比 Excel 无论在体积还是加载速度上都有数十倍优势。
3. 数字精度与前置零丢失
Excel 中存储的员工工号、身份证号、订单号(如 001234)如果被识别为浮点数或整数,开头的 0 会被自动截断。在 pandas 中,必须在 read_excel 时利用 dtype 参数明确将该列设为 str 或是 object;在 openpyxl 中读取时,如果原始单元格未在 Excel 中设为文本格式,则需要通过代码进行补零格式化。
六、综合总结与速查对比
通过下表可以快速回顾两者的关键特性与技术指标:
| 对比维度 | pandas | openpyxl |
|---|---|---|
| 核心侧重点 | 数据清洗、矩阵变换、统计分析、聚合运算 | 工作簿/工作表结构操作、单元格级精细控制、样式定制 |
| 内存数据结构 | DataFrame(基于 NumPy 数组的高性能二维矩阵) | 嵌套的 Python 对象树(Workbook > Worksheet > Cell) |
| 样式与格式支持 | 默认完全忽略样式,只提取纯净二维数据 | 全面支持字体、填充色、边框、对齐、条件格式与图表 |
| 公式处理机制 | 仅获取缓存结果或字符串,不维护公式模型 | 支持读取/写入公式表达式,或通过 data_only 模式读取计算缓存 |
| 典型适用场景 | 报表数据入库、特征工程、业务指标统计、批量转 CSV/SQL | 按模板填充带样式的定制凭证、修改指定单元格、自动化生成报表 |
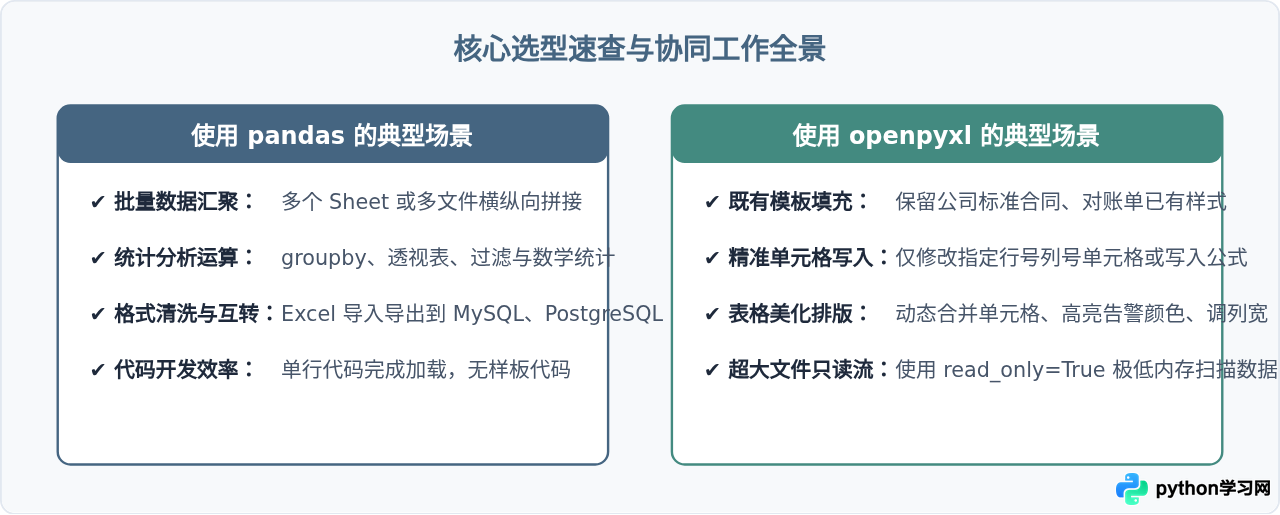
简而言之:需要“算数据、洗数据”时找 pandas;需要“做格式、填模板、控坐标”时用 openpyxl。在复杂的自动化工作流中,二者往往搭配使用——先用 pandas 完成高密度的过滤清洗与聚合,再通过 openpyxl 将统计结果按精美样式写入标准模板中交付客户。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









