

Python面试必刷100题:高频算法与数据结构实战详解
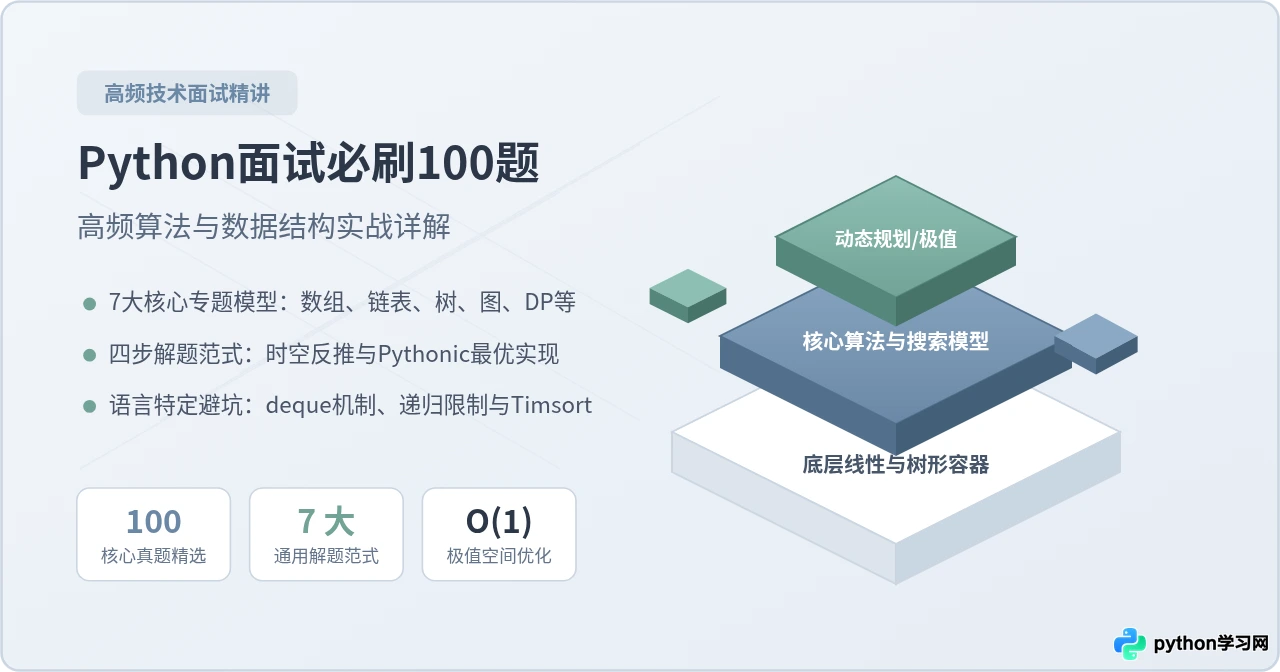
针对Python技术面试中的100道高频算法与数据结构题目,系统拆解数组、链表、树、图、双指针、动态规划等核心题型的求解模型、Pythonic实现技巧与复杂度优化边界。
一、高频100题的命题分布与四步解题范式
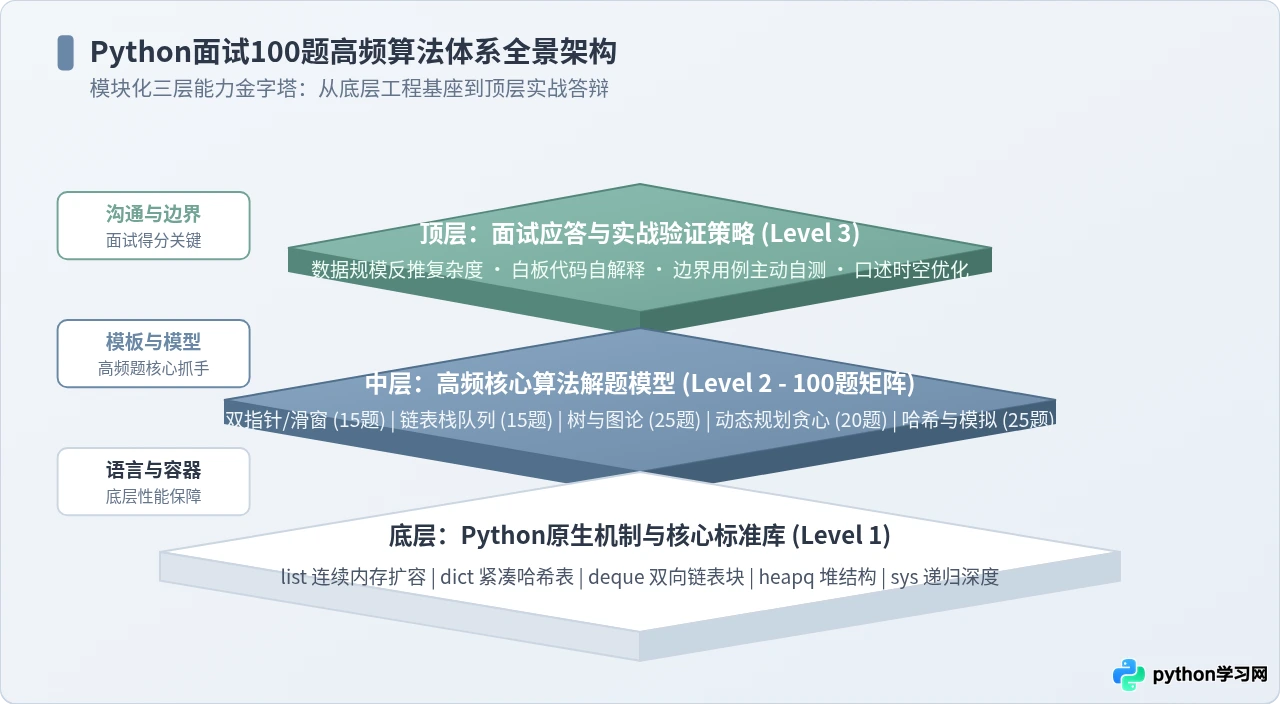
在主流互联网大厂及技术团队的Python面试中,题目并非随机分布,而是高度集中在可模板化、可考察工程编码习惯的题型上。对100道最高频真题的统计显示,其结构主要分布如下:
- 数组与哈希表(25题):前缀和、差分、双散列查找、原数组哈希(如缺失的第一个正数)。
- 双指针与滑动窗口(15题):快慢指针、对撞指针、单调滑动窗口与不定长滑动窗口。
- 链表、栈与优先队列(15题):哑节点操作、链表反转、单调栈极值、Top-K堆维护。
- 二叉树与图论(25题):前中后序递归与迭代、LCA公共祖先、BST性质、层序BFS、拓扑排序与并查集。
- 动态规划与贪心(20题):子序列与子数组、背包模型、区间调度、状态机DP。
很多候选人在面试中容易犯的错误是“一看到题目立即敲代码”,导致漏掉临界条件或选用复杂度过高的方法。高效通过面试的关键是执行严格的“四步解题范式”:
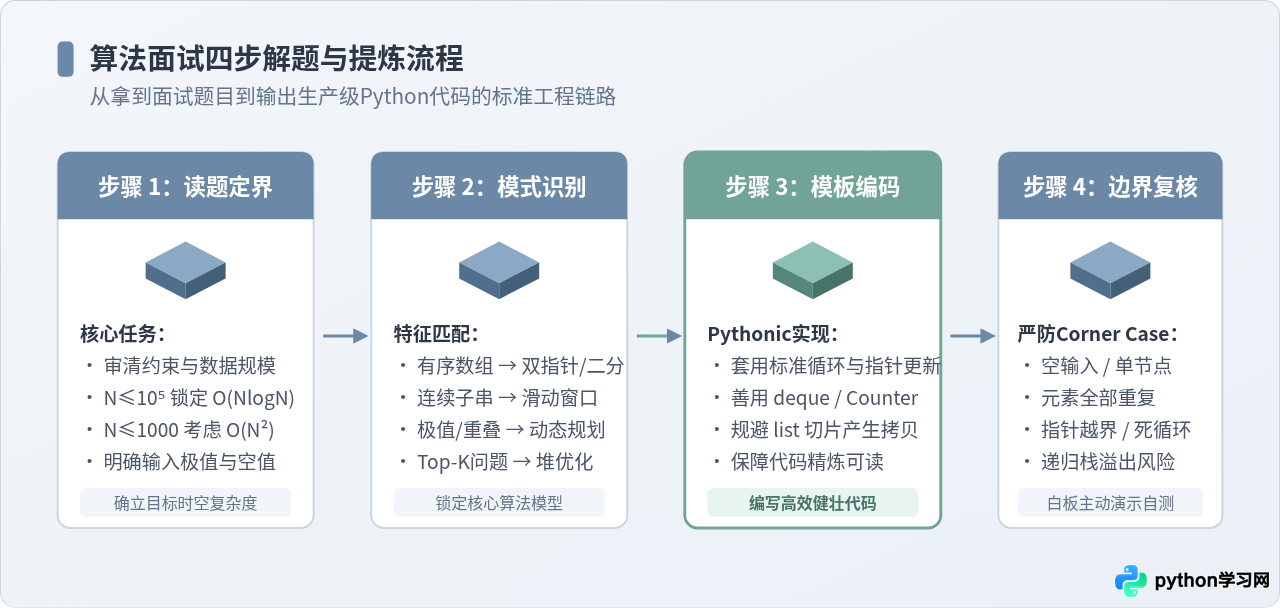
1. 读题定界:从数据规模反推时间复杂度
面试题目中给出的输入规模 $N$ 是推导最优算法的最强提示。在Python执行环境下,通常单测试用例的操作步数应控制在 $10^7$ 以内避免超时(TLE):
| 数据规模 $N$ | 允许的最大时间复杂度 | 对应的高频算法模型 |
|---|---|---|
| $N \le 20$ | $O(2^N)$ 或 $O(N!)$ | 全排列、回溯剪枝、状态压缩DP |
| $N \le 10^3$ | $O(N^2)$ | 双重循环枚举、矩阵DP、二维区间遍历 |
| $N \le 10^5$ | $O(N \log N)$ 或 $O(N)$ | 排序、分治、二分查找、堆排序、树状数组 |
| $N \le 10^7$ | $O(N)$ 或 $O(\log N)$ | 单遍历双指针、滑动窗口、哈希查表、数学公式 |
二、线性结构与滑动窗口/双指针实战详解
双指针(Two Pointers)与滑动窗口(Sliding Window)是面试中出现频次最高且性价比极高的技巧。核心思想在于利用序列的单调性或连续性,将原本需要两层嵌套循环 $O(N^2)$ 的暴力搜索优化至均摊 $O(N)$。
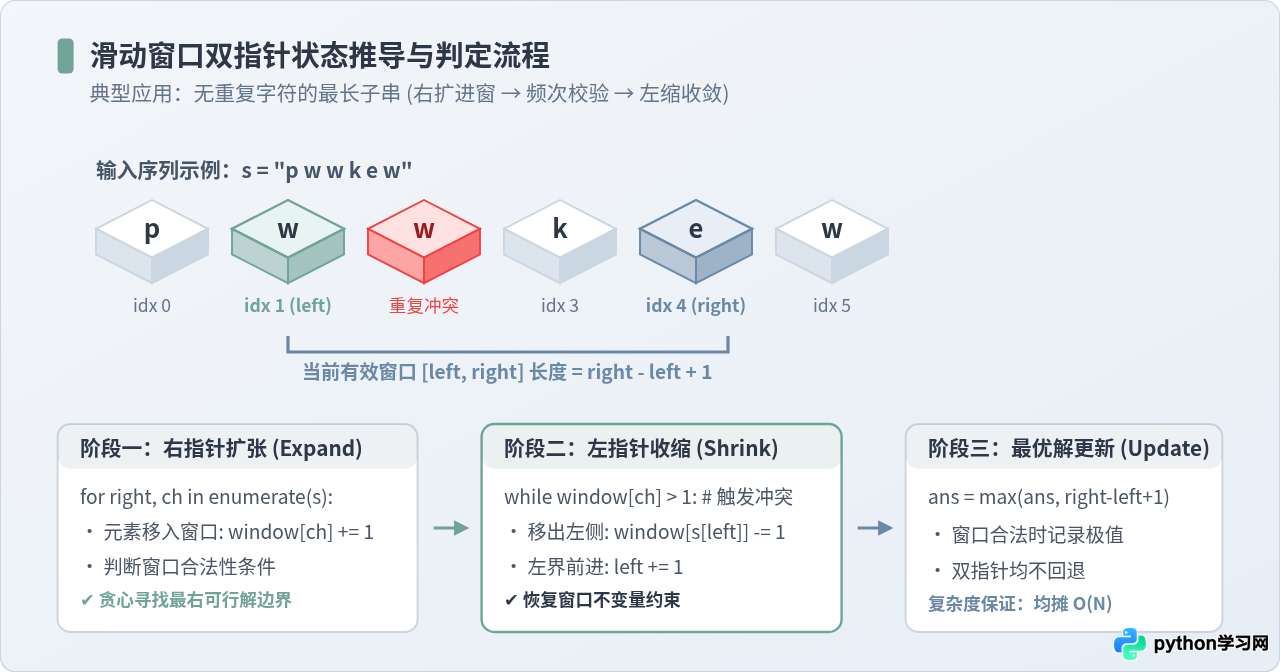
高频代表题:无重复字符的最长子串
题目定义:给定一个字符串 s,请你找出其中不含有重复字符的最长子串的长度。
解题推导:维护一个滑动窗口 [left, right] 与字符索引字典。当右指针遇到重复字符且该字符上次出现的下标在当前窗口内时,将左指针直接跳跃至重复字符上次出现位置的下一位,跳过无效收缩步骤。
def lengthOfLongestSubstring(s: str) -> int:
    # char_index 记录每个字符最新出现的下标
    char_index = {}
    left = 0
    max_len = 0

    for right, ch in enumerate(s):
        # 如果字符在字典中且在当前窗口内部,收缩左边界
        if ch in char_index and char_index[ch] >= left:
            left = char_index[ch] + 1

        char_index[ch] = right
        current_len = right - left + 1
        if current_len > max_len:
            max_len = current_len

return max_len三、链表、栈与优先队列的高频考点
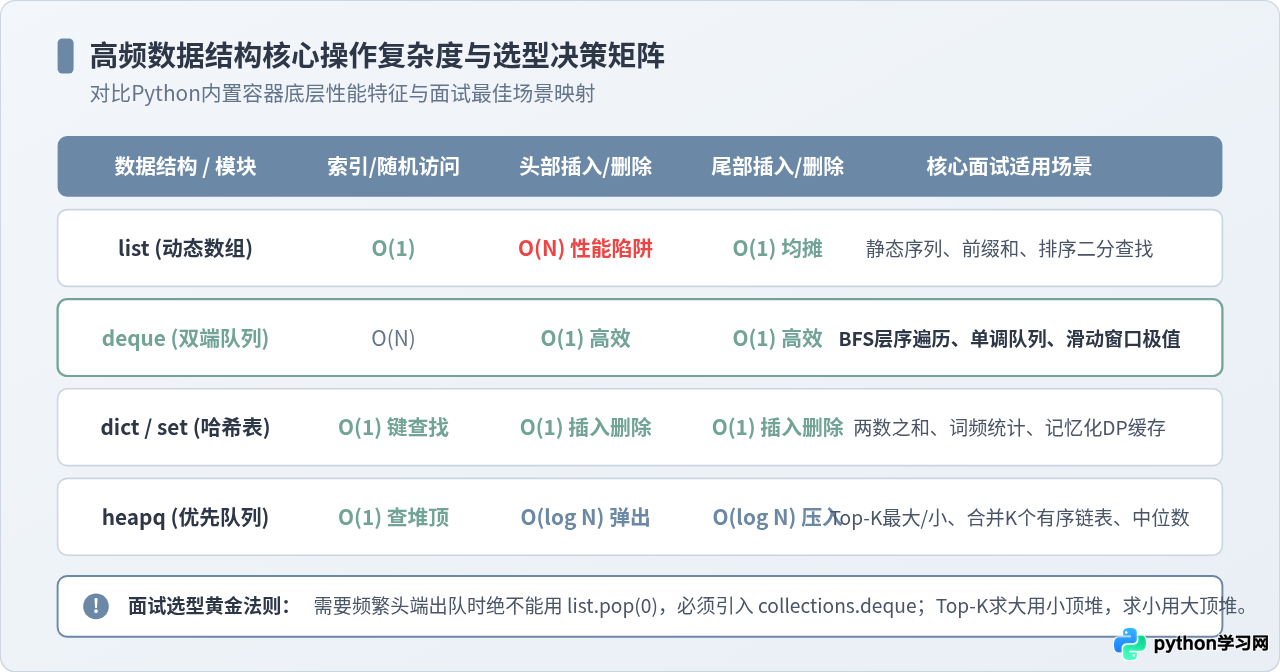
线性数据结构在Python中的实现机制各不相同。面试中经常考察候选人是否了解不同容器在底层内存分配上的差异:
1. 链表的核心利器:哑节点(Dummy Node)
在处理“合并两个有序链表”、“删除链表的倒数第N个结点”或“K个一组翻转链表”时,头节点极易发生变动。使用 dummy = ListNode(0) 并令 dummy.next = head,可以完全消除头节点为空或被删除时的特殊条件分支判断,使代码整洁且不易出错。
2. 单调栈与单调队列的应用
单调栈专门用于解决“寻找数组中元素左侧/右侧第一个更大/更小元素”的问题(时间复杂度 $O(N)$)。在接雨水、每日温度或柱状图中最大的矩形问题中,维护一个栈内元素保持单调递增或递减的栈,遇到破坏单调性的元素时连续出栈计算答案。
3. Python优先队列 heapq 的正确使用
Python标准库中的 heapq 模块实现的是小顶堆。当需要维护“前K个最大元素”(Top-K Largest)时,应维护一个大小为 $K$ 的小顶堆;遍历数组,当新元素大于堆顶时,替换堆顶并下沉。最终堆内留存的即为前 $K$ 大元素,时间复杂度为 $O(N \log K)$。
import heapq
from typing import List

def findKthLargest(nums: List[int], k: int) -> int:
    # 建立大小为 k 的小顶堆
    min_heap = []
    for num in nums:
        if len(min_heap) < k:
            heapq.heappush(min_heap, num)
        elif num > min_heap[0]:
            heapq.heappushpop(min_heap, num)
    return min_heap[0]
四、树结构与图搜索算法的递归与迭代转化
树与图的题目在100题中占据了四分之一的体量。面试官在考察树结构时,往往不仅要求候选人写出优雅的DFS递归,还会追问如何用迭代避免递归栈溢出。
1. 二叉树的层序遍历与最短路(BFS模板)
树的层序遍历和图的最短路径问题统一使用队列解决。在Python中必须使用 collections.deque,利用其 $O(1)$ 的 popleft() 实现出队操作。
from collections import deque
from typing import Optional, List

class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

def levelOrder(root: Optional[TreeNode]) -> List[List[int]]:
    if not root:
        return []

    result = []
    queue = deque([root])

    while queue:
        level_size = len(queue)
        current_level = []
        for _ in range(level_size):
            node = queue.popleft()
            current_level.append(node.val)
            if node.left:
                queue.append(node.left)
            if node.right:
                queue.append(node.right)
        result.append(current_level)

    return result
2. 最近公共祖先(LCA)的后序递归思维
寻找二叉树中两个节点 p 和 q 的最近公共祖先,本质是自底向上的后序遍历信息收集。当左子树和右子树各找到一个目标节点时,当前根节点必然是最近公共祖先。
五、动态规划(DP)的状态建模与空间压缩
动态规划是很多应聘者的难点。在面试环境下,解决动态规划问题的最快路径不是凭空推导一维压缩数组,而是遵循: 明确状态定义 → 找出转移方程 → 确定初始基准值 → 压缩空间维度。
典型题解:零钱兑换(完全背包模型)
状态定义:设 dp[i] 表示凑齐金额 i 所需的最少硬币枚数。
转移方程:dp[i] = min(dp[i], dp[i - coin] + 1),其中 coin ≤ i。
def coinChange(coins: List[int], amount: int) -> int:
    # 初始化 dp 数组,无穷大表示无法凑成
    dp = [float('inf')] * (amount + 1)
    dp[0] = 0

    for coin in coins:
        for x in range(coin, amount + 1):
            if dp[x - coin] + 1 < dp[x]:
                dp[x] = dp[x - coin] + 1

    return dp[amount] if dp[amount] != float('inf') else -1
六、Python特有语言陷阱与性能优化注意事项
面试官经常通过细节判断候选人是真正具备Python实战经验,还是仅仅将C++/Java语法直译为Python。以下几处细节极易导致被扣分甚至判错:
list 是基于连续内存块的动态数组。调用 list.pop(0) 会触发整个数组后续所有元素的内存移动,单次复杂度为 $O(N)$。如果在BFS或滑动窗口中循环调用,算法整体时间复杂度将直接从 $O(N)$ 退化为 $O(N^2)$,引发超时。必须使用 collections.deque。
RecursionError。在面试中如需使用深层递归,应在开头主动声明:
import sys
sys.setrecursionlimit(200000)dp = [[0] * n] * m。这种方式创建出的每一行实际上引用了同一个内存列表对象,修改其中一个元素会导致所有行同步变更。正确写法是使用列表推导式:
dp = [[0] * n for _ in range(m)]七、100题体系分层架构与复习通关策略
将100道题目转化为肌肉记忆,应当分层构建认知。底层是Python原生容器的底层复杂度特征,中层是7大算法模式的对应模板,顶层是面试现场的表达与自测策略:
4阶段冲刺建议
- 第一阶段(按专题分类突破,用时50%):不要按题目编号随机刷,集中攻破数组/双指针、链表、树、图、DP各个模块的典型模板题。
- 第二阶段(一题多解与复杂度深挖,用时20%):针对经典题(如两数之和、接雨水、三数之和、LCA)对比暴力法、哈希法、双指针法和单调栈法的空间换时间权衡。
- 第三阶段(限时无提示白板编码,用时20%):关闭IDE的自动补全功能,在纯文本编辑器中限时25分钟内手写完整代码,并主动设计包含边界用例(空序列、单个元素、全重复元素)的测试流程。
- 第四阶段(查漏补缺与语言特性串讲,用时10%):复习生成器、装饰器、垃圾回收(引用计数与标记清除)、以及GIL对多线程算法的影响,打通算法与Python工程基础的联系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









