

哪里可以找到可靠的Python编程基础题库与答案解析?
系统盘点经过实践检验的可靠Python基础题库与答案解析资源,剖析低质量题解与优质解析的本质差异,并提供涵盖自动化测试、解法重构与学习路径的完整实操指南。
一、什么是“可靠”的 Python 基础题库与答案解析?
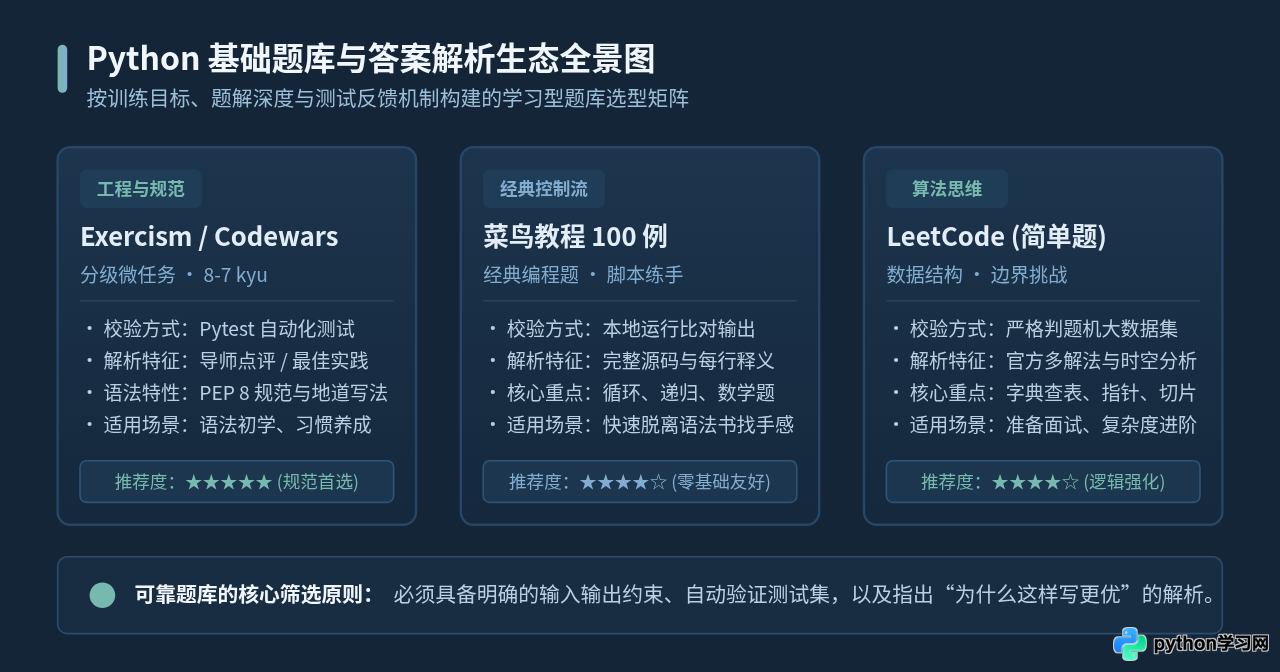
很多初学者把刷题当成“找题目抄代码”,在搜索引擎中随便点开一篇“Python 练习 100 题”,按照题目敲一遍 print 输出就认为掌握了知识点。这种方式很容易养成糟糕的编码习惯。一个真正可靠的 Python 基础题库与解析体系,应当在以下四个关键维度提供扎实支持:
-
现代语法与工程规范(PEP 8):可靠题库的代码必须全面支持 Python 3.8+ 标准。题目与解析中不应出现无括号的
print "text"、raw_input()等 Python 2 残留,而应展示现代f-string格式化、snake_case函数命名以及清晰的类型注解(Type Hints)。 - 输入输出约束与完备的测试用例:低质量题目常常只说“写一个函数计算某值”,却不定义入参边界。可靠的题库会明确列出输入类型、范围与返回值,并配套测试用例,覆盖空字符串、空列表、极端负数等边界条件,确保代码逻辑在严苛测试下依然健壮。
-
多解法演进与复杂度分析:可靠的答案解析不会仅仅给出一个生硬的最终结果,而是先展示基础的朴素实现,再解释如何利用 Python 标准库(如
collections、itertools)或列表推导式进行重构,并附带时间复杂度(如 \(O(N)\))与空间复杂度(如 \(O(1)\))的权衡解释。 - 错因归纳与社区反馈机制:初学者写基础题最常犯的错误包括变量作用域混淆、在遍历列表的同时修改列表、可变默认参数陷阱等。优质解析会明确指出“初学者容易写成怎样的错误形态”,并借助活跃的讨论区呈现不同开发者的解法对比。
二、主流可靠的 Python 基础题库深度盘点
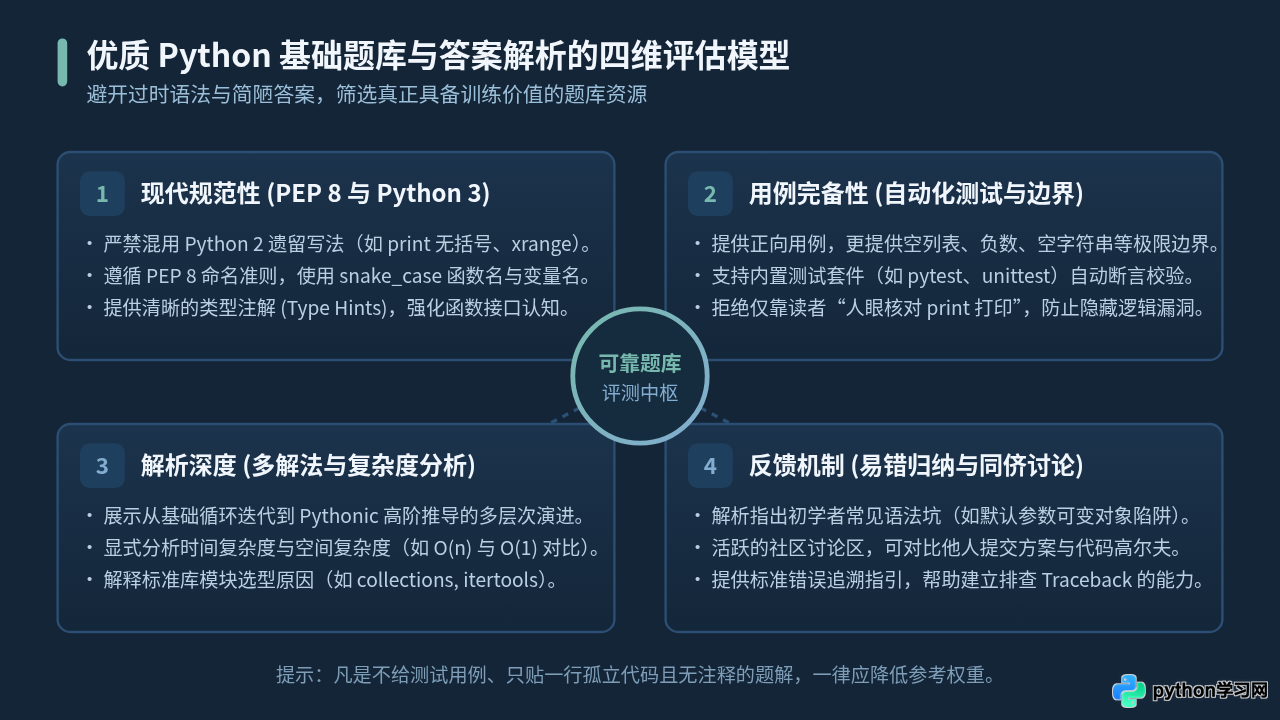
根据学习阶段与训练目标的不同,当前互联网上经过时间检验、维护良好的 Python 基础题库主要分为以下四类平台:
1. Exercism(Python Track)——工程规范与导师批改首选
平台定位与特点:Exercism 是完全开源免费的编程练习平台。它的 Python 语言轨道由资深社区维护,设计理念高度注重“代码质量与测试驱动开发”。
题目与解析形式:题目从基础的“字符串处理”、“列表过滤”到“类与异常设计”循序渐进。每道题都提供一个完整的代码仓库模板,内含写好的 pytest 单元测试文件。用户可以在网页端在线编写,也可以使用官方命令行工具下载到本地编辑器中运行测试。
答案解析优势:当你的代码通过全部单元测试并提交后,平台不仅允许你查看数万名全球开发者提交的“社区最佳解法(Community Solutions)”,更提供免费的社区导师人工审查(Mentor Review)。导师会针对你的变量命名、Pythonic 表达习惯和冗余代码提出具体的修改建议。
适用人群:刚学完基础语法、希望摆脱语法玩具代码、培养专业工程习惯与规范测试思维的学习者。
2. Codewars(8 kyu 至 6 kyu)——专项语法微练习与解法对比
平台定位与特点:Codewars 采用段位机制(8 kyu 为最低入门级,1 kyu 为最高),其 8 kyu 和 7 kyu 题目非常适合用来巩固 Python 核心内置函数与数据结构用法。
题目与解析形式:题目侧重于短小、具体的问题,例如“反转单词顺序”、“过滤列表中的非整数”、“统计元音字母数量”。在线编辑器右侧直接集成测试运行器,允许读者随时点击“Test”查看即时反馈。
答案解析优势:一旦提交正确方案,系统会立刻解锁“Solutions”页面。所有解法按照社区投票的“Best Practices”(最佳工程实践)和“Clever”(巧妙技巧)进行分类排序。通过对比别人的高赞代码,你可以极其直观地看到一行精简的字典推导式与你自己写的八行循环之间的结构差距。
注意事项:部分高赞“Clever”解法属于极度压缩的可读性较差的单行代码(One-liner),学习时应优先吸收“Best Practices”维度的清晰解法,切勿盲目模仿炫技式代码。
3. 经典中文开源题库(如菜鸟教程 100 例 / Python 核心题集)
平台定位与特点:国内经典的“Python 100 题”源自传统编程教学题集,涵盖水仙花数、素数筛选、杨辉三角、字符频次统计、斐波那契数列等经典逻辑题目。
题目与解析形式:以网页或 Markdown 单页文档形式呈现。每道题分为“题目描述”、“解题分析”与“完整源码”三部分。
甄别与使用建议:此类题库非常适合在本地 PyCharm 或 VS Code 中单步断点调试,适合建立循环和分支的执行感觉。但在使用时务必注意甄别:必须选择标注为 Python 3 版本的题集;若遇到使用 raw_input()、print ... 不加括号或未缩进代码的页面,建议立即切换到正规更新维护的现代镜像站点。
4. LeetCode(力扣)简单题专区与“学习探索”模块
平台定位与特点:LeetCode 虽以算法面试著称,但其“探索(Explore)”专栏中的“初级算法”、“Python 基础卡片”以及标签为“简单(Easy)”的题目(如“两数之和”、“有效的括号”、“罗马数字转整数”),是训练代码鲁棒性的绝佳试金石。
答案解析优势:官方题解通常提供从“暴力穷举”到“哈希表优化”的完整思维演进路径,并配有时空复杂度严格推导与动画图解。高赞题解区还有大量资深工程师分享 Pythonic 写法与工业级防御细节。
注意事项:初学者切勿盲目进入随机选题或刷中等(Medium)题目,否则极易因算法深度(如动态规划、深度优先搜索)过高而挫败基础学习信心。应将目标牢牢锚定在“数组遍历”、“哈希表查找”和“字符串切片”等基础标签上。
| 平台名称 | 主要题目类型 | 测试验证方式 | 答案解析核心特点 | 最适合学习阶段 |
|---|---|---|---|---|
| Exercism | 工程函数设计、标准库应用 | 本地 / 在线 Pytest 单元测试 | 社区方案按可读性排序,可申请人工导师评审 | 学完语法,培养工程规范期 |
| Codewars | 语法微任务、数据变换 | 在线测试断言(内置 Test 框架) | Best Practice 与 Clever 双维度投票展示 | 专项突破列表、字典与高阶函数 |
| 菜鸟 100 例 | 经典数学逻辑、控制流 | 本地运行手工比对输出 | 单文件逐行注释,适合本地单步断点调试 | 零基础新手建立代码敲击手感 |
| LeetCode (Easy) | 基础数据结构、算法启蒙 | 判题机大数据集自动回归 | 官方多解法推导,严格时间与空间复杂度分析 | 进阶面试准备、强化复杂度意识 |
三、从做题到内化:答案解析的高效实操四步法
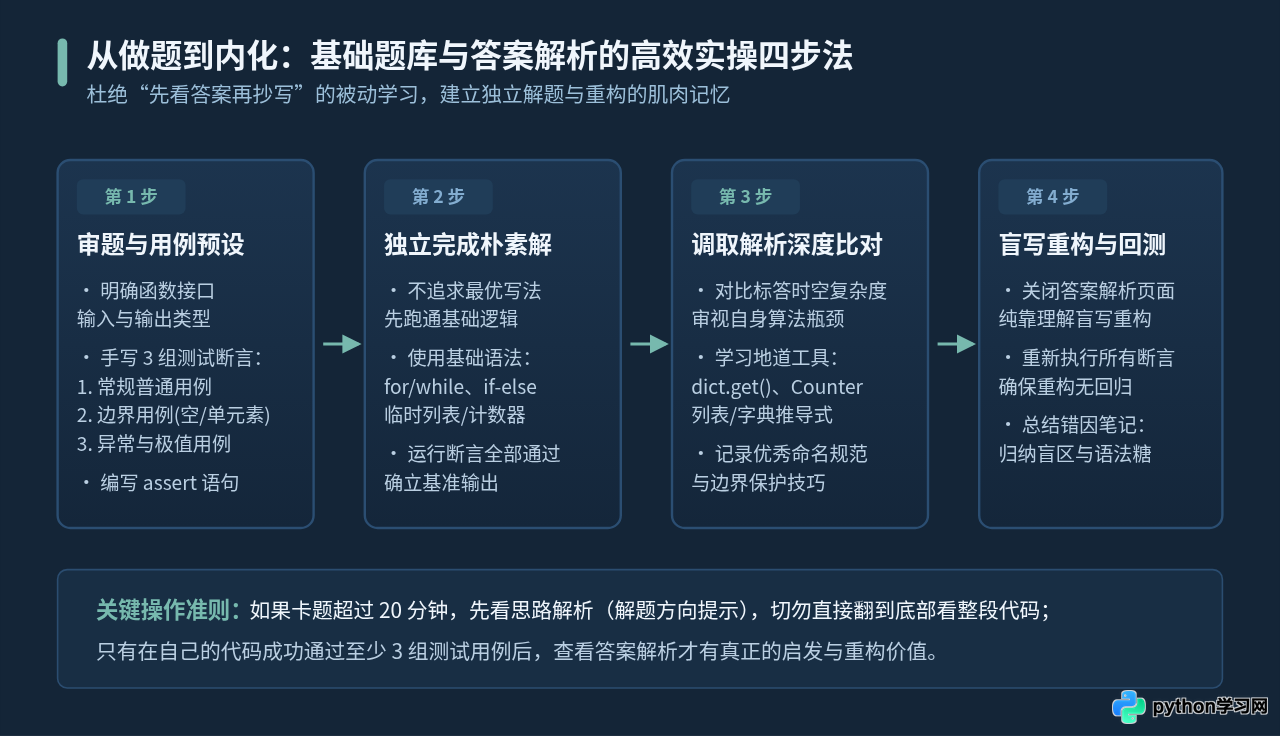
很多读者常抱怨“做题时看解析全懂,关上页面自己写又报错”。这种现象的根源在于被动接受了代码结果,却没有经历大脑对解题路径的主动重构。要真正把题库与答案解析转化为自己的编程能力,应严格遵循以下四步闭环流程:
实战演示:以“查找字符串中首个不重复字符”为例
题目要求:编写一个函数 first_uniq_char(s: str) -> int,接收一个字符串 s,找到它的第一个不重复的字符,并返回它的索引。如果不存在,则返回 -1。
第一步:编写明确的本地测试断言
在动笔写核心逻辑前,先在代码下方写好针对常规、边界与特殊情况的测试用例:
# 测试环境:Python 3.8+
# 准备阶段:在本地建立测试断言,防御边界
def first_uniq_char(s: str) -> int:
    pass  # 待实现

# 运行测试集(必须包含普通场景、重复场景与空值场景)
assert first_uniq_char("leetcode") == 0      # 'l' 是首个唯一字符,索引为 0
assert first_uniq_char("loveleetcode") == 2  # 'v' 是首个唯一字符,索引为 2
assert first_uniq_char("aabb") == -1          # 不存在唯一字符,返回 -1
assert first_uniq_char("") == -1              # 空字符串边界
第二步:独立实现朴素可行解
初学者最自然的思路是使用字符串自带的 count() 方法逐个判断:
# 朴素解法:直接循环利用 str.count()
def first_uniq_char_naive(s: str) -> int:
    for index, char in enumerate(s):
        if s.count(char) == 1:
            return index
    return -1
运行断言,测试完全通过。此时如果不看解析,很多人会认为任务已完成。但如果去查看优质题库的答案解析,就会发现深层次的性能问题。
第三步:比对优质答案解析,发现瓶颈
可靠题库的解析会清晰指出:s.count(char) 本身是一个 \(O(N)\) 的扫描操作,嵌套在 for 循环中,整体时间复杂度飙升至 \(O(N^2)\)。如果字符串长度达到 100,000,代码将直接超时。优质解析会给出采用哈希计数表(散列表)的线性 \(O(N)\) 解法:
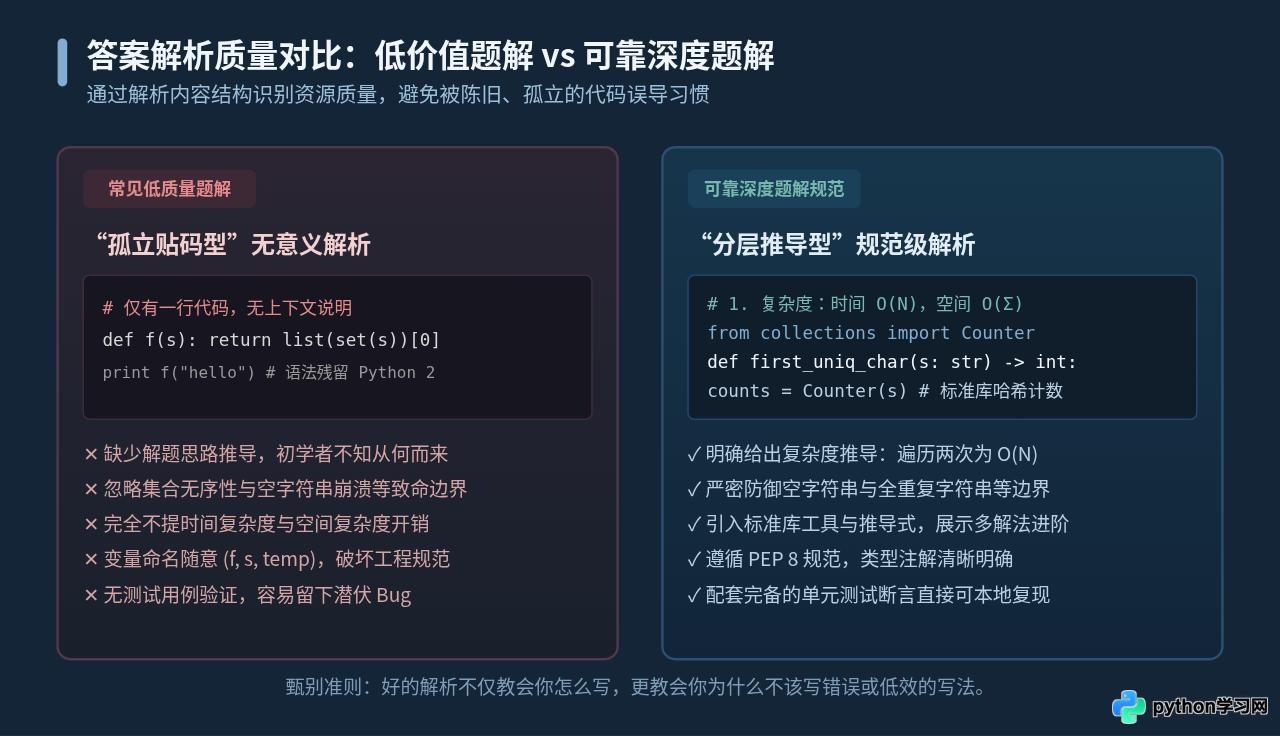
第四步:关闭解析窗口,重构代码并验证
理解了哈希频次统计的原理后,关闭题解,重新编写符合现代工程规范的解法,引入标准库 collections.Counter:
# 重构优化解:利用哈希计数器实现 O(N) 时间复杂度
from collections import Counter

def first_uniq_char(s: str) -> int:
    # 1. 第一遍扫描:统计各字符频次,耗时 O(N),空间复杂度 O(字符集大小)
    char_counts = Counter(s)

    # 2. 第二遍扫描:依照原始顺序找到第一个频次为 1 的字符索引
    for index, char in enumerate(s):
        if char_counts[char] == 1:
            return index

    return -1

# 执行全量自动化断言验证
assert first_uniq_char("leetcode") == 0
assert first_uniq_char("loveleetcode") == 2
assert first_uniq_char("aabb") == -1
assert first_uniq_char("") == -1
print("[示例输出] 全部测试断言通过,重构完成!")[示例输出] 全部测试断言通过,重构完成!四、初学者使用题库与答案解析的常见陷阱
- 陷阱一:看懂等于会写。阅读解析中的巧妙代码会带来“即时多巴胺”,但这种理解是脆弱的。只要不脱离解析自己从空白文件写一遍,遇到类似题目依然会无从下手。必须坚持“盲写重构”。
- 陷阱二:盲目追求“一行流(One-liner)”。许多初学者误以为代码越短水平越高,把多层嵌套循环和推导式硬塞进一行。在工业界中,清晰可维护、符合 PEP 8 规范的代码远比晦涩难懂的一行神仙代码更有价值。
-
陷阱三:依赖本地 print 人肉检查。很多网络题目只要求读者
print(result),读者用肉眼扫一眼没报错就跳过。这种习惯会掩盖空列表、极端值和数据类型不匹配的问题。应尽早习惯使用assert或pytest进行程序化断言。 - 陷阱四:题海战术与偏离基础。未打牢文件读写、异常处理、字典与列表基础,就急于挑战复杂的动态规划或图算法。基础阶段应以“常用数据结构与内置函数熟练度”为第一优先级。
五、总结:Python 基础刷题阶段化选型指南
为了帮助读者根据当前学习进度精准选择题库,下方的路线指南总结了不同周期的推荐路径与阶段目标:
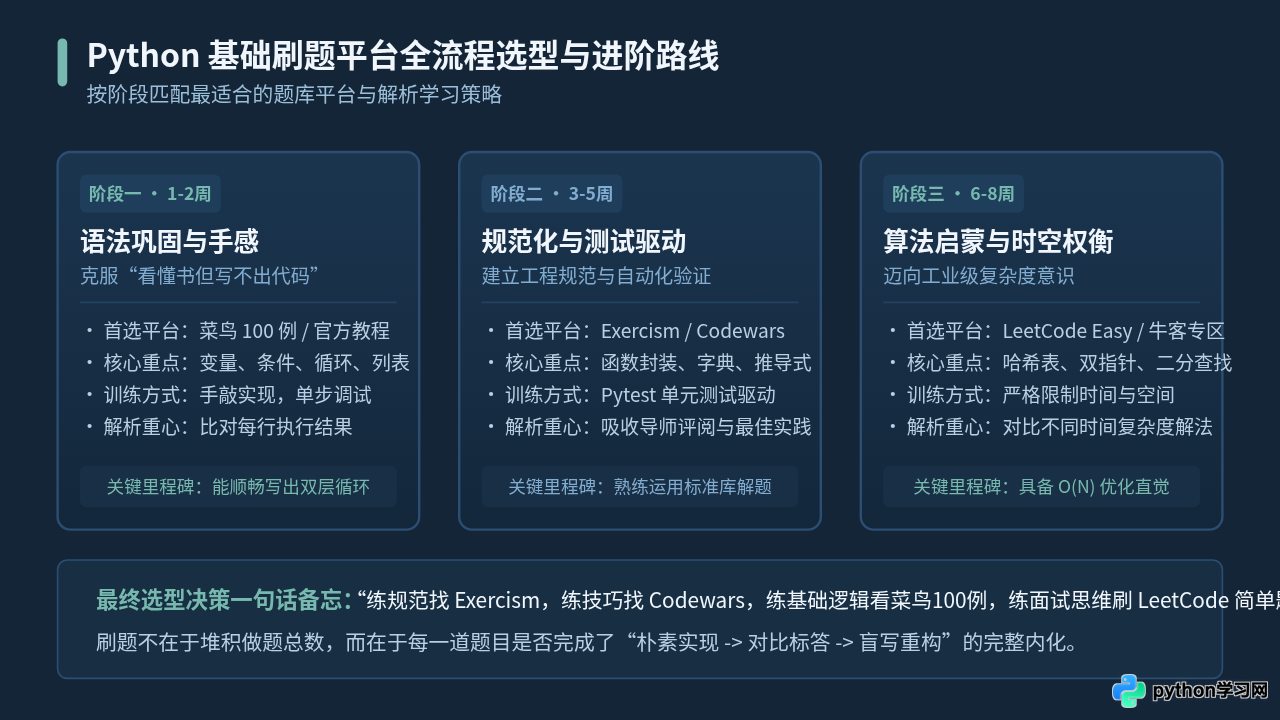
寻找可靠题库的关键,在于让每一道练习题都成为一次“独立思考 -> 自动化测试验证 -> 标答思路重构”的完整训练。建议初学者按照以下原则行动:
- 入门前两周:以菜鸟 100 例等经典控制流题目为骨架,在本地 IDE 中亲手敲打每一行代码,观察循环与判断的运行过程;
- 进入规范期:全面接入 Exercism Python Track,使用
pytest习惯工程化测试,通过阅读高赞解答和导师反馈,规范自己的函数与变量命名; - 专项突破期:在 Codewars 刷 8 kyu 和 7 kyu 题目,熟练运用列表推导式、
dict.get()和collections等地道工具; - 算法启蒙期:挑选 LeetCode 简单题中的数组与字符串标签,学习 \(O(N)\) 与 \(O(N^2)\) 的开销差异,建立性能直觉。
踏实完成上述闭环,你不仅能找到可靠的题目与解析,更能建立起经得起实际项目考验的扎实 Python 编程底座。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









