

非程序员靠Python做副业靠谱吗?数据清洗与爬虫接单分析
针对非程序员群体,系统分析利用Python进行数据清洗和网络爬虫副业接单的真实可行性、技术与合规门槛、实际投入产出比,并给出务实的技能运用路径。
对于没有计算机专业背景的普通学习者而言,单纯指望在公开兼职平台上靠 Python 爬虫和数据清洗接单做副业,整体靠谱程度较低,性价比通常不尽如人意。网络上盛传的“零基础学一个月、兼职月入数千上万”几乎全部属于商业培训课程的营销夸大。但在熟人业务合作、特定小微机构的报表日常整理等特定场景下,Python 确实具备实用价值。本文将围绕爬虫与数据清洗两项核心技能,从技术门槛、合规风险、市场竞价生态以及真实投入产出比四个维度展开深入分析,帮助读者建立客观理性的预期。
一、爬虫接单分析:为何远不如想象中靠谱
很多非程序员在入门 Python 时,首先接触的就是爬虫脚本。网络教程往往演示如何用几十行代码抓取静态网页标题或豆瓣电影排行榜,让人误以为只要依样画葫芦就能承接商业抓取需求。然而,商业爬虫接单与业余练习之间存在着巨大的断层。
1. 技术对抗门槛不断升级
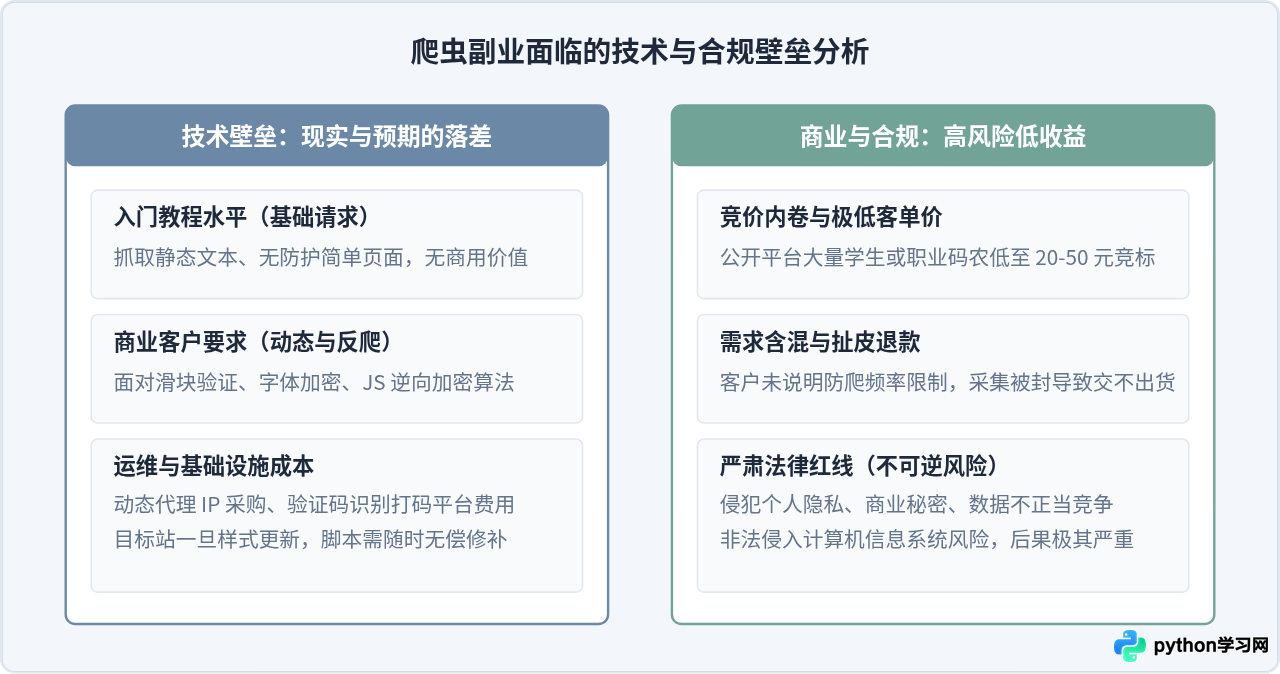
商业客户需要抓取的目标网站,往往具有严密的反爬防护体系。常见的技术壁垒包括:
- 动态数据加载与加密反爬:现代网站大多采用前后端分离架构,核心数据通过加密 API 异步传输,常包含复杂的 JavaScript 混淆(JS 逆向)、动态签名与时间戳验证,这对未受过系统前端工程训练的非程序员是一道极高的门槛。
- 高频风控与验证码拦截:行为滑块、点选验证码、字体反爬映射(CSS 混淆加密),以及严格的 IP 请求频次限制。要稳定抓取海量数据,往往需要购买付费代理 IP 池并搭建验证码解析服务,这些隐性成本会直接吃掉微薄的佣金。
- 网站频繁改版导致的持续维护负担:目标网站页面结构一旦微调,原有解析规则即刻失效。客户往往要求“保证长期稳定运行”,接单者常常陷入无休止且无额外报酬的后期维护之中。
2. 难以规避的法律与合规红线
爬虫接单最大的隐患不是技术难度,而是法律风险。商业抓取极易踩中以下法律红线:
- 侵犯个人信息:抓取包含用户姓名、手机号、社交动态等敏感个人信息,触犯《个人信息保护法》相关条款。
- 不正当竞争纠纷:抓取竞品平台的核心商品价格、库存或行业报告,涉嫌违反《反不正当竞争法》,甚至引发平台民事索赔。
- 刑事风险:绕过反爬机制强行抓取未公开接口或破坏服务器防护,可能构成《刑法》第二百八十五条规定的“非法获取计算机信息系统数据罪”。非程序员缺乏企业法务支持,极易因几十元或几百元的报酬承担不可承受的法律责任。
二、数据清洗接单分析:相对安全但性价比有限
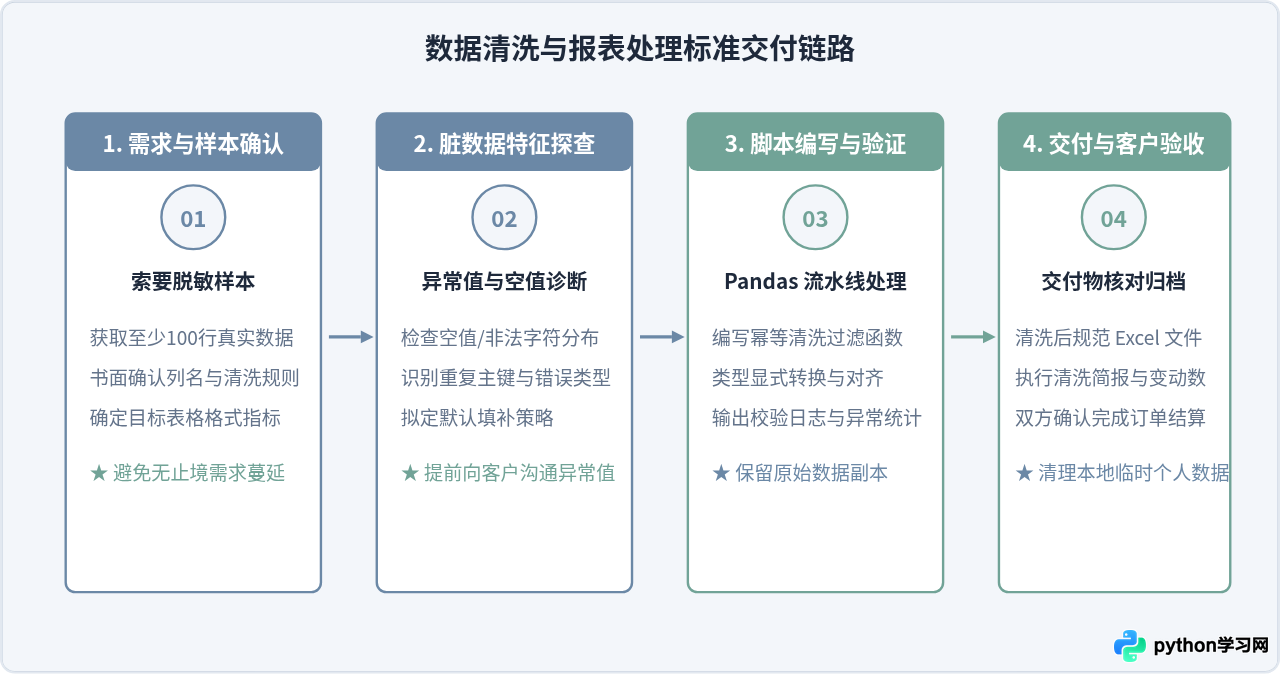
相比于爬虫的高法律风险,数据清洗与表格自动化处理属于合规、安全的技术方向。数据来源通常由客户自行提供,主要任务是对混乱、重复或格式不统一的 Excel、CSV 或文本数据进行规范化整理。
1. 真实需求形态分析
中小微商户、研究生毕业课题、电商小卖家等群体确实存在数据处理痛点,主要形式包括:
- 多表格自动合并与拆分:数十个格式相似的分店销售月报合并为一张总表,或按特定部门拆分为独立文件。
- 数据清洗与格式规整:剔除重复订单、修剪前后空格、统一日期时间格式(如将“2023/5/1”、“2023-05-01 10:20”统一为“2023-05-01”)。
- 缺失值填补与规则校准:依据关联字典填充空缺的商品类目、规范化手机号与身份证文本属性。
2. 为什么在公开平台依然很难赚钱?
虽然需求真实存在,但公开平台的竞争环境对非程序员并不友好:
- 替代门槛低:随着各类低代码工具、Excel Power Query 以及现代大语言模型(如 ChatGPT、Claude)的普及,普通用户借助 AI 工具往往几分钟内就能自行生成清洗脚本或在 Excel 内部完成公式处理。
- 沟通成本远超开发成本:客户提供的数据往往充满各种异常值(例如数字列中夹杂文字注释、同一列出现多种日期标准)。非程序员由于缺乏数据校验规范经验,写出的脚本一旦遗漏边界条件,返工修改的沟通耗时极长。
三、实用代码示例:常见订单表格的清洗脚本
为了让读者对数据清洗的实际工作量有具体感知,以下提供一段使用 Python 经典库 pandas 处理真实脏数据的完整代码。该场景模拟了客户提供的常见杂乱销售订单表,涵盖去除空白字符、按主键去重、手机号正规化、金额缺失处理和日期标准化等核心步骤。
运行环境准备:推荐在本地虚拟环境中使用 Python 3.8 及以上版本。需通过终端安装依赖:
pip install pandas openpyxl
import pandas as pd
import re

def clean_order_dataset(input_excel_path: str, output_excel_path: str):
    """
    通用销售数据清洗流水线示例
    :param input_excel_path: 客户提供的原始杂乱 Excel 路径
    :param output_excel_path: 清洗规整后输出的标准 Excel 路径
    """
    print(f"[*] 开始读取原始数据: {input_excel_path}")
    df = pd.read_excel(input_excel_path)

    # 1. 规范化列名:清除首尾多余空格与不可见字符
    df.columns = df.columns.astype(str).str.strip()

    # 2. 剔除核心信息缺失的无效记录(如缺失订单号或客户名称)
    initial_count = len(df)
    df = df.dropna(subset=['订单号', '客户名称'])
    print(f"[-] 过滤空订单记录: 剔除 {initial_count - len(df)} 条无效数据")

    # 3. 按订单号去重,保留最新一次出现的记录
    before_dedup = len(df)
    df = df.drop_duplicates(subset=['订单号'], keep='last')
    print(f"[-] 订单去重处理: 移除 {before_dedup - len(df)} 条重复订单")

    # 4. 客户手机号清洗:剥离所有非数字字符,统一为 11 位纯文本格式
    def normalize_phone(phone_val):
        if pd.isna(phone_val):
            return "未提供"
        clean_digits = re.sub(r'\D', '', str(phone_val))
        # 兼容包含国家代码 86 的情形
        if clean_digits.startswith('86') and len(clean_digits) == 13:
            clean_digits = clean_digits[2:]
        return clean_digits if len(clean_digits) == 11 else "号码格式异常"

    df['联系电话'] = df['联系电话'].apply(normalize_phone)

    # 5. 金额字段处理:转换为浮点数,非法字符转为 0.0,保留两位小数
    df['交易金额'] = pd.to_numeric(df['交易金额'], errors='coerce').fillna(0.0).round(2)

    # 6. 日期格式统一:支持解析多种格式并统一输出为 YYYY-MM-DD
    df['下单时间'] = pd.to_datetime(df['下单时间'], errors='coerce').dt.strftime('%Y-%m-%d')
    df['下单时间'] = df['下单时间'].fillna('日期无法识别')

    # 7. 导出至目标文件,关闭索引列
    df.to_excel(output_excel_path, index=False, engine='openpyxl')
    print(f"[+] 数据清洗成功完成,已写入目标文件: {output_excel_path} (剩余有效数据: {len(df)} 行)")

if __name__ == "__main__":
    # 示例调用
    # clean_order_dataset("raw_customer_orders.xlsx", "cleaned_orders_standard.xlsx")
    pass
四、非程序员轻量级数据处理工具链推荐
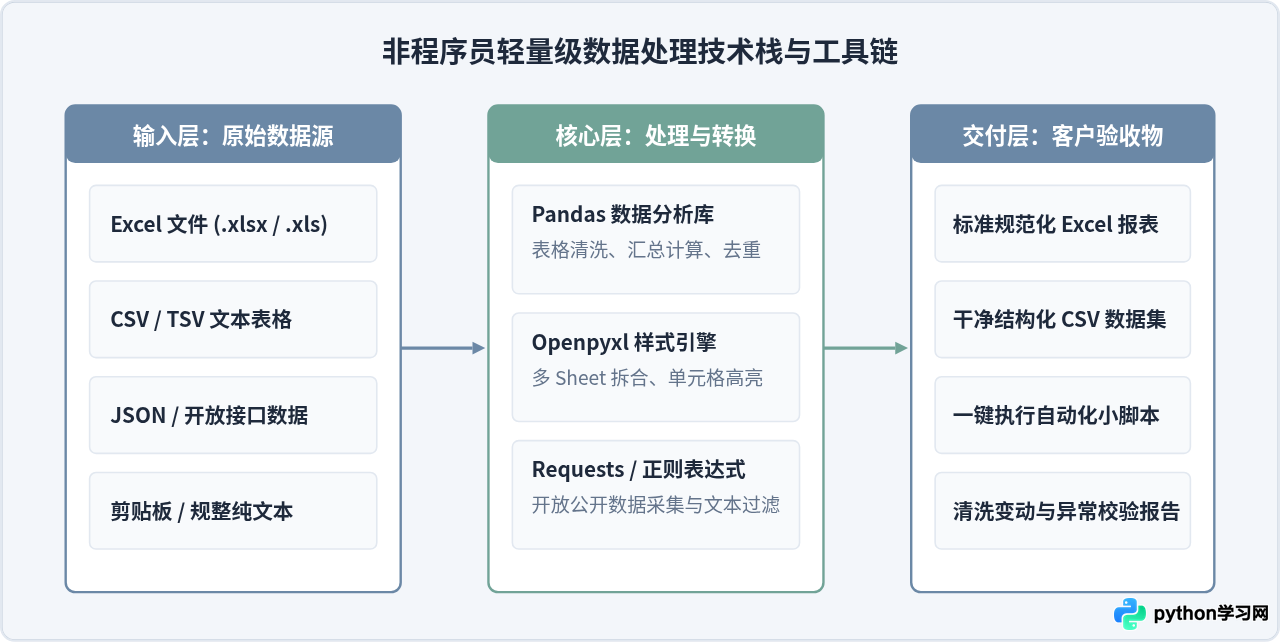
对于非全职开发人员,技术选型应以“易上手、生态稳定、无需复杂基础设施”为核心标准。避免过早引入分布式计算(如 Spark)或复杂数据库管理系统,以下三件套足以覆盖 95% 以上的中小型副业需求:
五、投入产出比核算与更合理的变现路径
很多初学者只计算“接一单赚了 100 元”,却没有计算背后的“真实时薪”:
| 工作环节 | 平均耗时 | 实际价值与风险说明 |
|---|---|---|
| 前期平台抢单与竞价沟通 | 1.0 - 2.5 小时 | 平台竞价激烈,大量时间消耗在无效打招呼与报价拉锯中。 |
| 数据样例摸底与需求反复确认 | 1.0 - 2.0 小时 | 非标数据中隐藏未知字段或格式陷阱,需要反复向客户确认规则。 |
| 核心脚本编写与调试 | 1.5 - 3.0 小时 | 实际编码时间,因缺乏工程经验容易在异常值处理上卡壳。 |
| 客户验收、反馈修改与扯皮 | 1.0 - 3.0 小时 | 客户临时追加要求、不认同过滤掉的数据,可能面临退款纠纷。 |
| 综合折算总耗时 | 4.5 - 10.5 小时 | 若单笔成交额为 50-150 元,实际时薪仅约 10-25 元,远低于多数体力兼职。 |
真正靠谱的技能变现路径
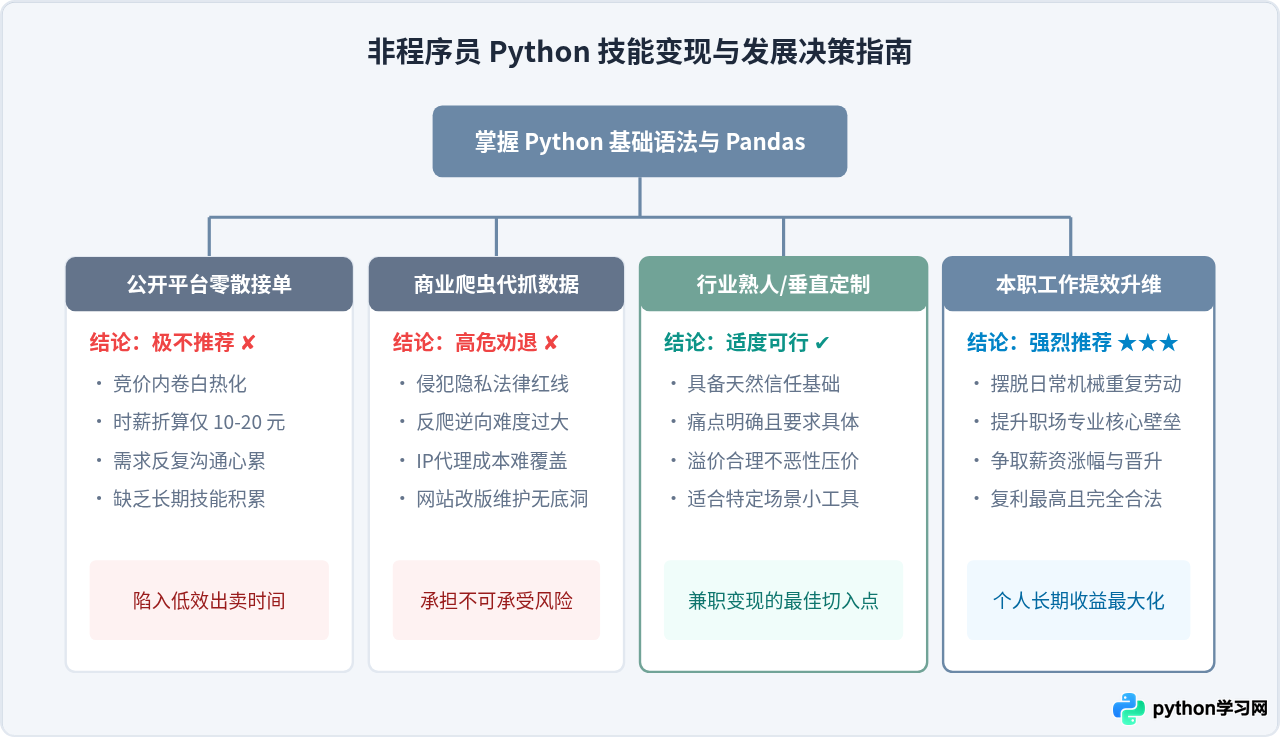
如果学习 Python 的初衷是提升收入,相比于在公开兼职平台上出卖廉价劳动力,以下路径更具可持续性:
- 赋能主业工作(ROI 最高的路径):将 Python 用在自己的日常工作中。财务自动化对账、电商运营批量生成报表、人力资源核算考勤绩效等,能直接将数天的枯燥机械劳动缩减到几分钟。通过提高本职工作效率、展现自动化技能,争取升职加薪或转岗机会,收益远高于几百元的兼职单。
- 深耕行业垂直场景的熟人定制:依托自己熟悉的行业(如外贸、房产、教育、自媒体),为同行或熟悉的朋友开发解决具体痛点的自动化小脚本。熟人业务信任度高、需求明确、客单价更合理,且无需面对公开平台的恶性压价。
- 沉淀行业自动化内容与知识分享:将自己在特定专业领域用 Python 提效的真实案例整理成教程、图文或视频。比起在接单平台与低价代码打工者竞争,打造个人专业影响力更具长远复利。
总结与建议
非程序员学习 Python 本身是一件极具价值的事,它能极大地开拓数据思维、消除办公中无意义的低效重复劳动。然而,如果仅仅把学习目标锚定在“网上接单做副业”,往往会因为遇到残酷的市场竞价、苛刻的商业反爬要求以及潜在的法律合规风险而倍感挫败。
摆脱“副业速成接单”的幻想,转而把 Python 当作自己专属的“效率杠杆”,先解决自己身边和本职工作中的繁琐数据问题,再在熟悉的圈子中探索轻量化定制,才是非程序员利用 Python 获得可持续回报的正道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









