

Python新手误区:修改类变量为何会影响所有实例
深入解析Python中修改类变量影响所有实例的底层机制,剖析属性查找顺序、原地修改与变量遮蔽的本质差异,并给出清晰的重构与排查方案。
一、现象重现:令人费解的“幽灵数据”
为了直观展示该问题,我们来看一个模拟电商用户购物车的简单类。许多初学者在定义类时,会顺手将商品列表作为属性直接写在 class 块内:
class ShoppingCart:
    # 错误写法:在类主体中声明可变容器
    items = []

    def add_item(self, item_name):
        self.items.append(item_name)

# 实例化第一个用户的购物车
user1_cart = ShoppingCart()
user1_cart.add_item("机械键盘")
print("用户1购物车:", user1_cart.items)
# 示例输出:用户1购物车: ['机械键盘']

# 实例化第二个用户的全新购物车
user2_cart = ShoppingCart()
print("用户2初始购物车:", user2_cart.items)
# 示例输出:用户2初始购物车: ['机械键盘']
程序运行后,user2_cart 刚被实例化出来,里面竟然已经存在了 user1_cart 添加的商品。如果不清楚底层原理,开发者很容易误以为这是 Python 运行时的缓存异常或垃圾回收机制缺陷。但事实上,Python 的执行逻辑完全符合语言规范。
二、核心机制:Python 的命名空间与属性查找机制
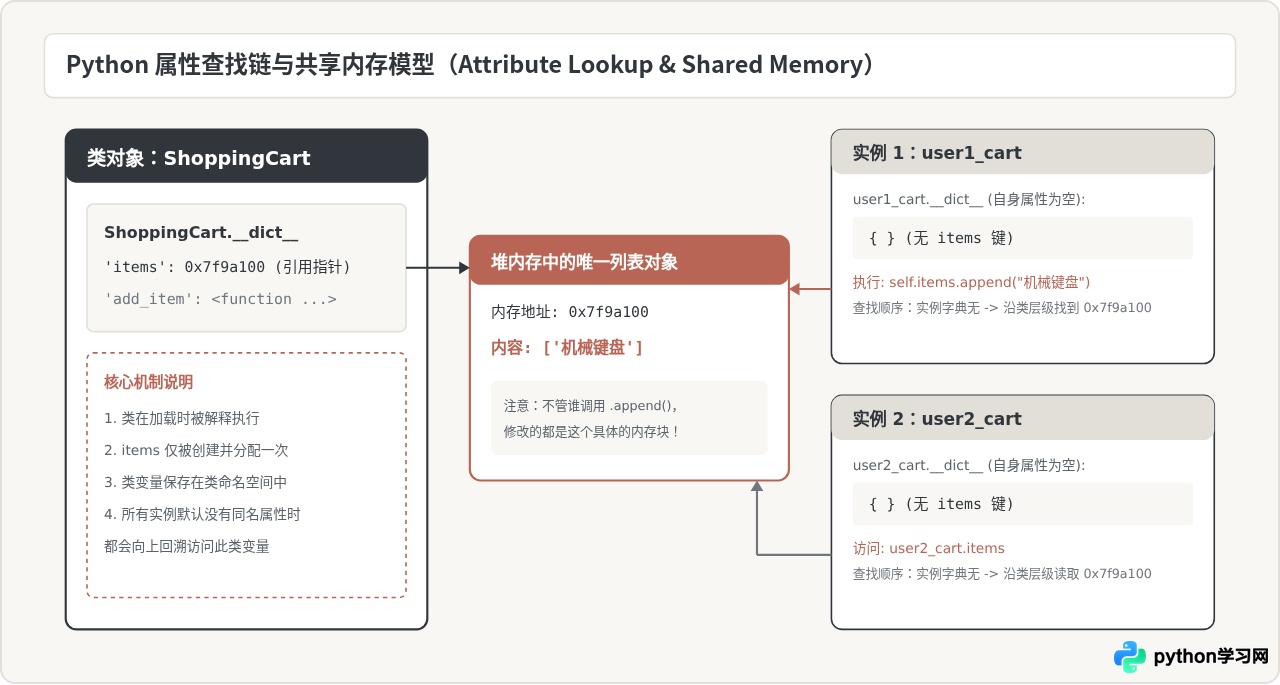
要彻底理解这个问题,必须拆解 Python 是如何存储和查找对象属性的。在 Python 中,类和实例各自拥有独立的命名空间,其底层通常表现为一个名为 __dict__ 的字典。
当代码在类定义内部(外部函数之外)直接书写赋值语句时,例如 items = [],这个变量被放入了 类的命名空间 中,即 ShoppingCart.__dict__['items']。该语句仅在 Python 解释器首次加载这个类时执行一次。
当通过实例访问属性(如 self.items)时,Python 会遵循一套标准的回溯查找流程:
- 首先在当前实例的命名空间
self.__dict__中查找是否有名为items的键; - 如果实例字典中不存在,则沿着继承链向上到该实例所属的类字典
ShoppingCart.__dict__中查找; - 如果在类字典中找到,就返回这个对象引用;若类及其父类均未找到,最终抛出
AttributeError。
在上面的示例中,user1_cart 内部并没有属于自己的 items。当执行 self.items.append("机械键盘") 时,系统分成了两步执行:
- 第一步(查找):读取
self.items。由于实例字典为空,Python 找到了ShoppingCart.items,获得列表的内存引用; - 第二步(操作):对该内存引用执行
.append()方法。这属于原地修改(In-Place Mutation),并不会改变变量的指向,而是直接修改了堆内存里的列表。
因此,当 user2_cart 再次读取 items 时,查找到的仍是这个已被改动的共享列表。
三、关键区别:原地修改与赋值的遮蔽效应
为了进一步验证属性查找与赋值的区别,我们可以查看以下代码中三种不同的操作方式:
class Demo:
    shared_list = []
    count = 0

d1 = Demo()
d2 = Demo()

# 方式 1:通过实例重新赋值 (Assignment)
d1.count = 10
print(d1.count)        # 示例输出: 10 (来自 d1.__dict__)
print(d2.count)        # 示例输出: 0  (回溯来自 Demo.__dict__)
print(Demo.count)      # 示例输出: 0

# 方式 2:通过类名重新赋值
Demo.count = 99
print(d2.count)        # 示例输出: 99 (d2 未遮蔽,跟随类变量改变)
print(d1.count)        # 示例输出: 10 (d1 已遮蔽 count,不受类变量影响)

# 方式 3:通过实例进行原地修改 (In-Place Mutation)
d1.shared_list.append("Alpha")
print(d2.shared_list)  # 示例输出: ['Alpha'] (两者访问同一个列表)
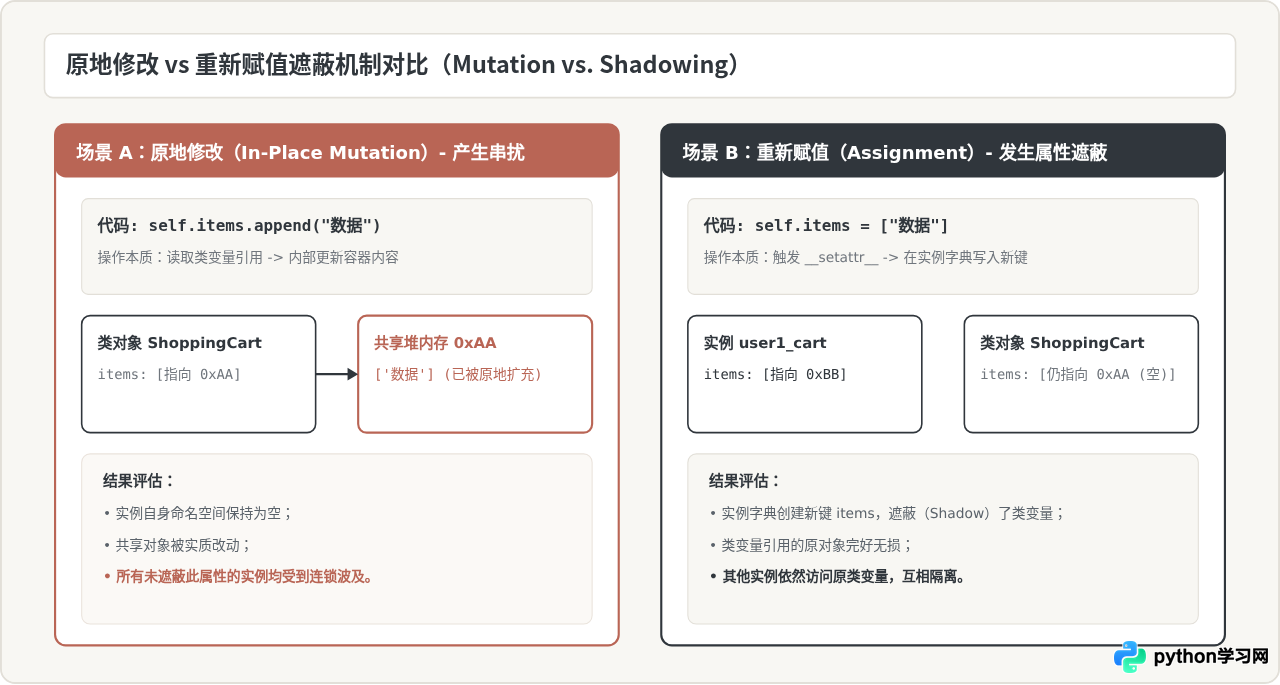
当执行 d1.count = 10 时,Python 解释器调用的是实例的属性设置逻辑,直接将 count: 10 写入 d1.__dict__。这种行为被称为属性遮蔽(Attribute Shadowing)。之后任何针对 d1.count 的访问都会优先命中该实例字典,不再查找类变量。
然而,在调用 d1.shared_list.append("Alpha") 时,等号左边并没有变量绑定操作。它仅仅是提取了引用的对象并执行其方法。因此不会触发实例字典的新增,所有对象依然共享对底层容器的访问。
四、正确做法与工程重构规范
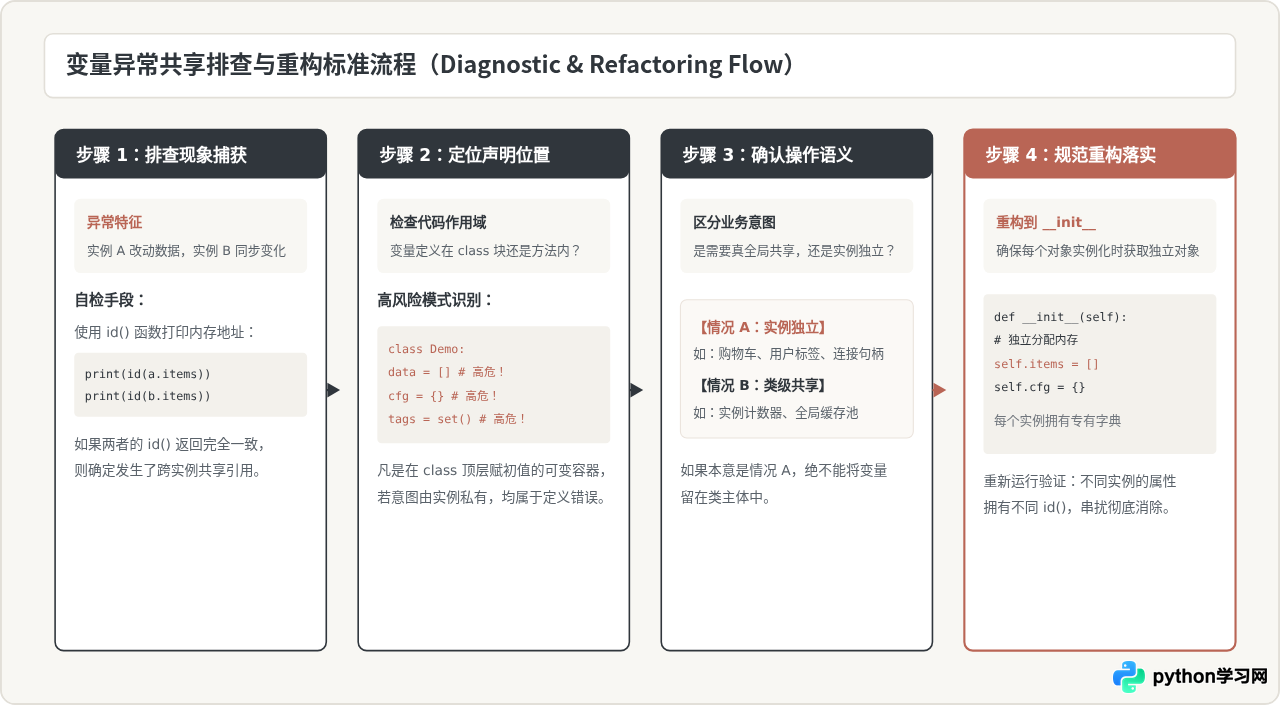
理解了上述原理后,解决该误区的方法便十分明确。根据实际应用场景的不同,通常有以下三种标准重构规范:
1. 实例私有数据:在 __init__ 中显式初始化
只要某个属性的数据生命周期属于单个实例,就必须将其声明在构造函数 __init__ 之中,并通过 self.属性名 绑定:
class ShoppingCart:
    def __init__(self):
        # 正确规范:每次实例化都会创建一个全新的独立空列表
        self.items = []

    def add_item(self, item_name):
        self.items.append(item_name)

user1_cart = ShoppingCart()
user1_cart.add_item("机械键盘")

user2_cart = ShoppingCart()
print("用户1购物车:", user1_cart.items)  # 示例输出: ['机械键盘']
print("用户2购物车:", user2_cart.items)  # 示例输出: [] (相互隔离,互不干扰)
2. 参数可选初始化:使用 None 作为哨兵默认值
如果希望允许在初始化时传入初始容器,千万不要直接将 def __init__(self, items=[]) 设为可变默认参数。这会引发另一个类似的经典陷阱(函数默认参数在定义期被绑定)。推荐的做法是使用 None 作为哨兵值并在内部浅拷贝:
class ShoppingCart:
    def __init__(self, items=None):
        # 避免默认参数陷阱,并对外部传入的列表建立独立副本
        if items is None:
            self.items = []
        else:
            self.items = list(items)
3. 真正的类级共享:显式使用类名读写
如果业务场景确实需要跨所有实例共享数据(例如统计总创建实例数、全局缓存或服务注册表),应该保留类变量,但在操作时统一使用类名访问,避免使用 self 进行容易产生歧义的读写:
class ServiceTracker:
    # 真正的类变量:全局计数器
    total_instances = 0

    def __init__(self, service_name):
        self.service_name = service_name
        # 规范:显式通过类名更新,消除歧义
        ServiceTracker.total_instances += 1

s1 = ServiceTracker("AuthService")
s2 = ServiceTracker("PaymentService")
print("全局活跃实例总数:", ServiceTracker.total_instances)  # 示例输出: 2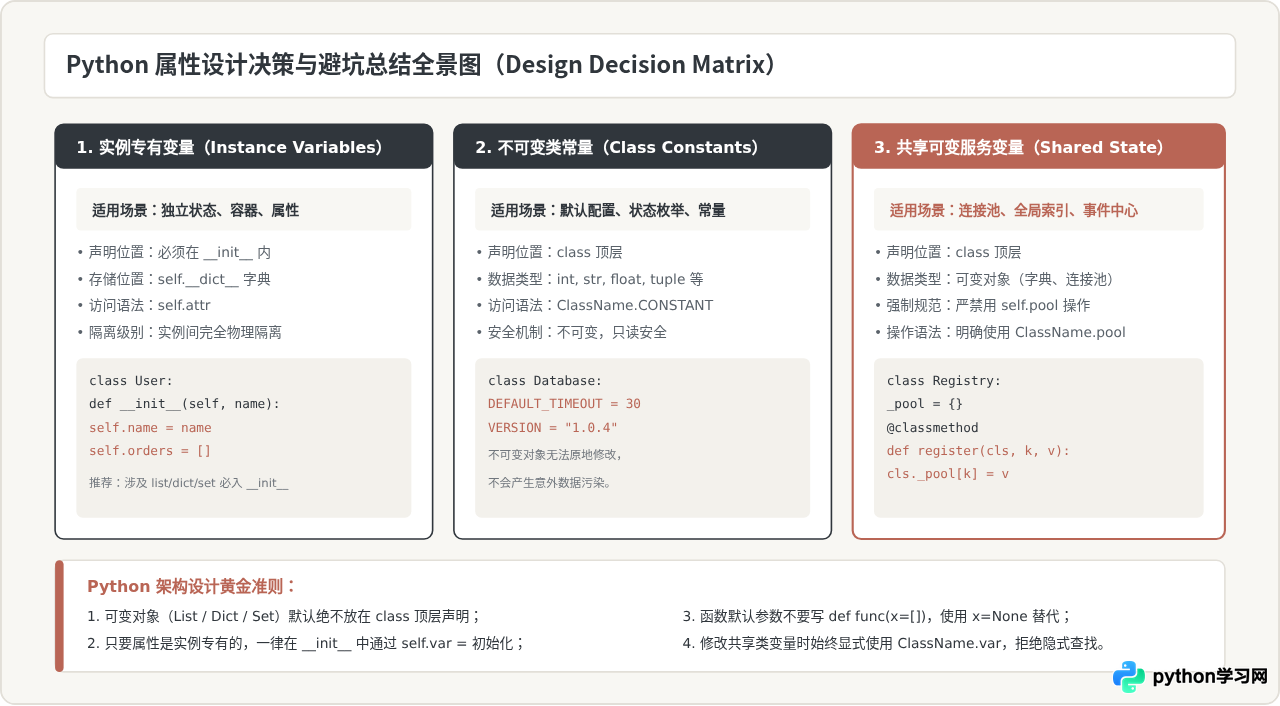
五、总结与自查清单
速记口诀:“类中声明皆共享,原地修改牵连广;独立属性入 Init,类名访问意图朗。”
“修改类变量影响所有实例”这一现象,本质上是由 类命名空间共享、自底向上的属性查找机制 以及 可变对象的原地修改特性 共同决定的。在日常开发与代码审查中,可通过以下清单快速自查:
- 检查类顶层属性:是否存在
[]、{}或set()等可变对象字面量?如果有,且该属性预期随实例独立,应立即将其迁移至__init__。 - 检查修改方式:业务逻辑中调用的是
.append()、.update()还是重新赋值=?前者操作的是原有内存对象,后者才会创建实例私有遮蔽。 - 检查意图表达:对于合法的类级变量,是否在所有读写处都规范地使用了
ClassName.variable?显式引用能有效阻断误解,并保证代码可读性与健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









