

Python多进程与多线程详解:原理、实现与性能对比

本文深入解析Python中进程与线程的核心概念,对比单核与多核CPU下的并发与并行机制。详细演示如何使用multiprocessing模块的Pool类进行多进程开发,以及threading模块处理多线程时的GIL锁限制与数据竞争问题,帮助开发者根据CPU密集或IO密集场景选择最优方案。
一、什么是进程和线程
进程被视为操作系统分配资源的最小单位,而线程则是系统调度执行的最小单位。
当应用程序启动时,至少会创建一个进程,操作系统会为该进程分配独立的内存空间。不同进程之间拥有隔离的内存空间,互不干扰。由于单个CPU核心在同一时刻只能执行一个进程,其他进程必须处于等待状态,直到获得CPU时间片。
一个进程内部可以包含一个或多个线程,这些线程共享该进程所分配的内存空间和其他系统资源。这相当于将一个大的任务分解为多个子任务,每个线程负责执行其中一个子任务,从而实现资源的共享与任务的细分。
二、多进程和多线程
对于单个CPU核心而言,同一时刻只能运行一个进程或线程。单核CPU通常通过快速切换进程或线程来执行任务,每个进程或线程分配一定的CPU时间片。由于切换速度极快,用户感知上似乎是多个任务在“并行”执行,但实际上它们是“并发”执行的,即一段时间内交替执行多个任务。
单核CPU下的并发主要涉及进程或线程的上下文切换,其中进程切换比线程切换消耗更多的时间和系统资源。在单核CPU环境下,对于CPU密集型任务,使用多进程或多线程通常无法提升性能;然而,对于IO密集型任务,由于IO操作会导致CPU空闲,此时使用多进程或多线程可以有效提升整体执行效率。
多核CPU则具备同时执行多个进程或线程的能力,即实现真正的并行运算。在拥有多个CPU核心的系统中,通常采用多进程或多线程模式来并行处理多个任务,以充分利用硬件资源。
三、python中的多进程和多线程
1、多进程
def Test(pid):
    print("当前进程{}:{}".format(pid, os.getpid()))
    for i in range(1000000000):
        pass
if __name__ == '__main__':
    #单进程
    start = time.time()
    for i in range(2):
        Test(i)
    end = time.time()
    print((end - start))
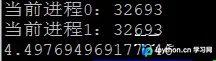
单进程输出结果如图:
def Test(pid):
    print("当前子进程{}:{}".format(pid, os.getpid()))
    for i in range(100000000):
        pass
if __name__ == '__main__':
    #多进程
    print("父进程:{}".format(os.getpid()))
    start = time.time()
    pool = Pool(processes=2)
    pid = [i for i in range(2)]
    pool.map(Test, pid)
    pool.close()
    pool.join()
    end = time.time()
    print((end - start))
多进程输出结果如图:
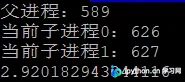
从输出结果可以看出,两个场景均执行了两次for循环。对比发现,使用两个进程的多进程方式比单进程方式减少了近乎一半的执行时间,且通过查看CPU使用情况可知,多进程成功利用了多个CPU核心进行计算。
在Python中,多进程可以通过mulitiprocess模块的Pool类来创建,并利用Pool提供的map方法来调度子进程执行任务。
一般多进程的执行流程如下代码所示:
def Test(pid):
    print("当前子进程{}:{}".format(pid, os.getpid()))
    for i in range(100000000):
        pass
if __name__ == '__main__':
    #多进程
    print("父进程:{}".format(os.getpid()))
    pool = Pool(processes=2)
    pid = [i for i in range(4)]
    pool.map(Test, pid)
    pool.close()
pool.join()1、利用Pool类创建一个进程池,通过processes参数声明进程池中最多允许运行的子进程数量。若不指定该参数,系统会自动根据CPU核心数量进行设定。原则上,进程池容量不应超过CPU核心数,出于资源节约考虑,避免创建过多的进程。
2、声明一个可迭代变量,该变量的长度决定了需要执行的子进程数量。
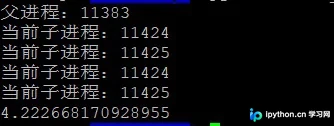
3、利用map()方法执行多进程任务。map方法接收两个参数:第一个参数是执行任务的函数名,第二个参数是第二步声明的可迭代变量,其中的每个元素作为函数所需的参数传入。这里需要注意几个关键点:1)当进程池满时,新请求会进入等待队列。以上述代码为例,若声明了一个容量为2的进程池,但可迭代变量包含4个元素,则执行时会先创建两个子进程。此时进程池已满,后续请求需等待已有子进程执行完毕后,才能继续处理。
2)子进程处理完一个请求后,会被复用继续处理新的请求,而不会重新创建新的进程,从而节省资源。
从图3可以看出上述两个点,如果同时处理4个进程,那么只需要2秒钟,这里是分成两次处理,花费了4秒,并且两次处理使用的子进程号都相同。
3)map方法会将每个子进程的返回值汇总成一个列表返回给主进程。
4、在所有请求处理结束后,使用close()方法关闭进程池,此后不再接受新的任务提交。
5、使用join()方法使主进程阻塞,等待所有子进程退出。join()方法必须放在close()方法之后调用,以防止主进程在子进程结束之前提前退出。
2、多线程
Python的多线程模块使用threading类进行创建和管理。
import time
import threading
import os
count = 0
def change(n):
    global count
    count = count + n
    count = count - n
def run(n):
    print("当前子线程:{}".format(threading.current_thread().name))
    for i in range(10000000):
        change(n)
if __name__ == '__main__':
    print("主线程:{}".format(threading.current_thread().name))
    thread_1 = threading.Thread(target=run, args=(3,))
    thread_2 = threading.Thread(target=run, args=(10,))
    thread_1.start()
    thread_2.start()
    thread_1.join()
    thread_2.join()
    print(count)
程序执行时会创建一个主进程,该进程默认启动一个主线程。使用threading.Thread()可以创建子线程;其中target参数指定要执行的函数,args参数传入函数所需的参数。调用start()启动子线程,调用join()使主线程阻塞,优先运行子线程。由于变量由多个线程共享,任何一个线程都可以修改变量,如果多个线程同时修改变量,就会出现数据竞争错误。
上面的程序在理论上的结果应该为0,但运行结果如图:
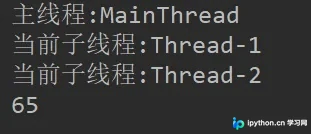
出现这个结果的原因就是多个线程同时对于变量修改,在赋值时出现错误,具体解释见多线程
解决这个问题就是在修改变量的时候加锁,这样就可以避免出现多个线程同时修改变量。
import time
import threading
import os
count = 0
lock = threading.Lock()
def change(n):
    global count
    count = count + n
    count = count - n
def run(n):
    print("当前子线程:{}".format(threading.current_thread().name))
    for i in range(10000000):
        # lock.acquire()
        # try:
            change(n)
        # finally:
        #     lock.release()
if __name__ == '__main__':
    print("主线程:{}".format(threading.current_thread().name))
    thread_1 = threading.Thread(target=run, args=(3,))
    thread_2 = threading.Thread(target=run, args=(10,))
    thread_1.start()
    thread_2.start()
    thread_1.join()
    thread_2.join()
    print(count)
Python中的线程需要先获取GIL(Global Interpreter Lock,全局解释器锁)才能继续运行。每一个进程仅有一个GIL,线程在获取到GIL之后执行100字节码或者遇到IO中断时才会释放GIL。这样在CPU密集的任务中,即使有多个CPU,多线程也是不能够利用多个CPU来提高速率,甚至可能会因为竞争GIL导致速率慢于单线程。所以对于CPU密集任务往往使用多进程,IO密集任务使用多线程。
到此这篇关于python多进程和多线程介绍的文章就介绍到这了,更多相关python多进程和多线程内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









