

Python中import模块与subprocess调用脚本的区别
深入对比Python中通过import导入模块与使用subprocess调用脚本的核心区别,从内存隔离、执行时延、通信机制与故障边界等维度提供清晰的技术解析与选型指南。
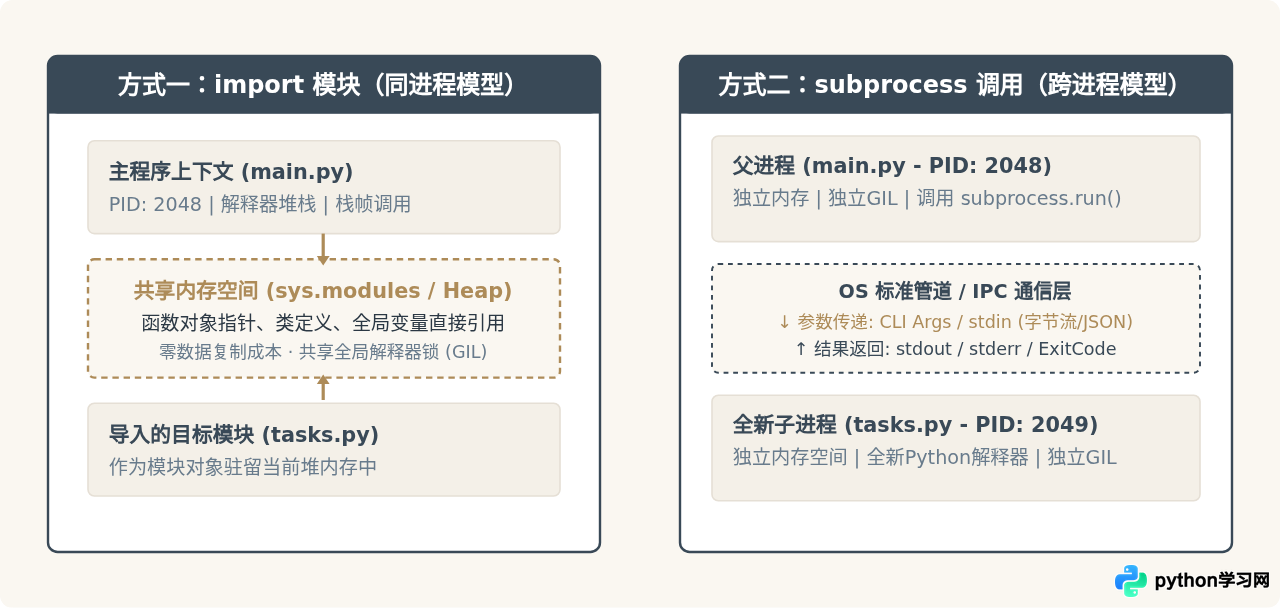
在Python开发中,当我们需要复用或执行另一个脚本的代码时,最常见的两种手段是通过 import 导入模块以及通过 subprocess 模块启动子进程。两者的核心区别在于运行边界:import 是同进程内部的代码加载与内存共享,函数直接在当前Python解释器中以微秒乃至纳秒级完成调用;而 subprocess 则是操作系统级别的跨进程调用,主程序会启动一个相互独立的外部进程并借助标准管道进行数据通信,具备天然的进程隔离与环境解耦能力。
一、底层架构与内存模型的本质差异
理解这两种方式的适用场景,首先需要剖析它们在操作系统和解释器层面的底层执行模型。
当执行 import my_module 时,Python解释器会先在 sys.modules 字典中检索该模块是否已加载。若未加载,解释器会读取并编译目标源码,在当前进程堆内存中开辟命名空间,并创建对应的模块对象。此后,所有对该模块的属性访问和函数调用,本质上都是在同一个进程的地址空间内查找内存指针。这意味着模块与主程序共享同一份全局解释器锁(GIL)、垃圾回收系统和全局变量状态。
相比之下,当调用 subprocess.run([sys.executable, "my_script.py"]) 时,Python会调用操作系统的底层系统调用(在Linux上通常为 clone 或 fork/exec,在Windows上为 CreateProcess),从操作系统内核层面创建一个独立的子进程。该子进程拥有完全独立的虚拟内存空间、独立的Python解释器实例以及专属的GIL。父进程与子进程之间无法直接通过内存指针交换数据,所有入参和返回值必须经过字符流或字节流的序列化(如CLI参数、标准输入输出管道),完成跨进程通信(IPC)。
二、调用实现步骤与代码示例
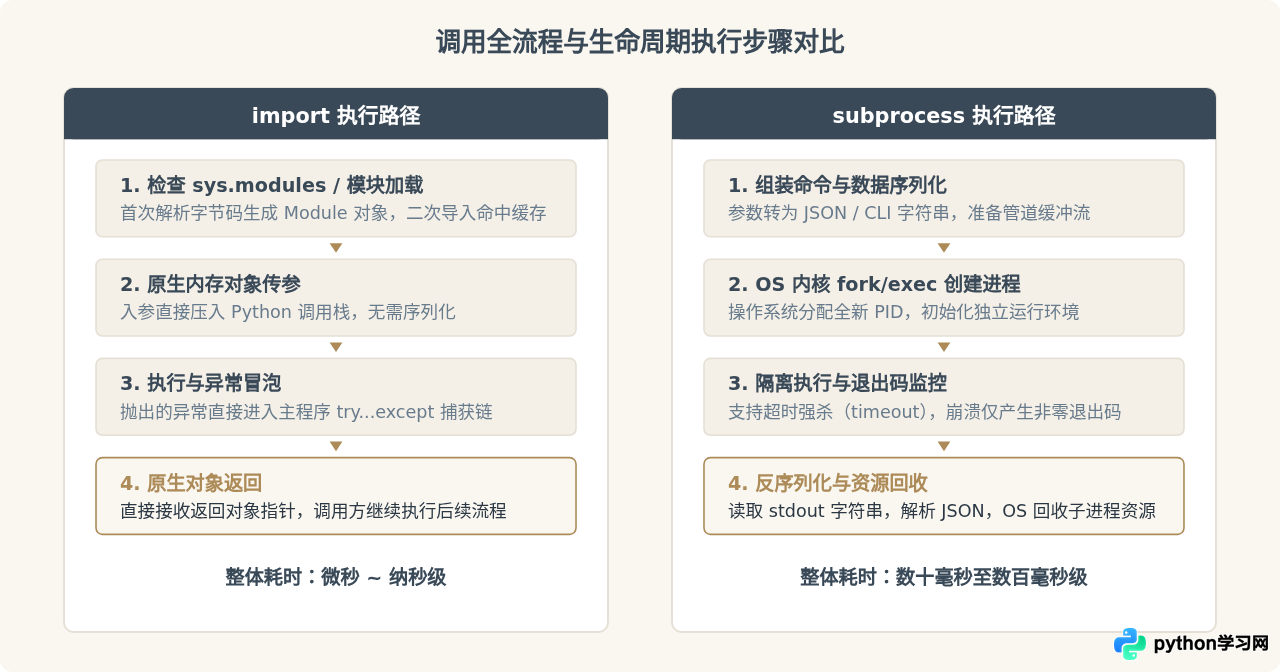
在实际编码中,两种方式的调用逻辑、参数传递方式及异常捕获路径有显著不同。
1. import 模式:函数式直接调用
编写可复用模块时,通常将逻辑封装为函数或类,主脚本直接引入并传递Python原生对象:
# tasks.py - 模块文件
def process_data(user_id: int, payload: dict) -> dict:
    """内部模块函数:处理并返回字典结果"""
    if not isinstance(user_id, int):
        raise ValueError("user_id 必须为整数")
    return {"status": "ok", "result": f"processed_{user_id}", "count": len(payload)}

# main.py - 主程序文件
import tasks

try:
    # 直接传递原生字典,返回原生字典对象
    result = tasks.process_data(101, {"item": "apple", "quantity": 5})
    print("处理结果:", result["result"])
except ValueError as e:
    print("参数异常捕获:", e)
2. subprocess 模式:CLI 与标准流调用
使用 subprocess 时,被调用的脚本应当具备独立运行入口(通常带有命令行参数解析)。主程序通过序列化格式(如JSON)输入数据并捕获退出状态码与输出流:
# tasks.py - 独立可执行脚本
import sys
import json

def main():
    try:
        # 从标准输入读取参数 JSON 字符串
        input_data = json.loads(sys.stdin.read())
        user_id = input_data["user_id"]
        payload = input_data["payload"]

        output = {"status": "ok", "result": f"processed_{user_id}", "count": len(payload)}
        # 将结果输出到 stdout
        sys.stdout.write(json.dumps(output))
        sys.exit(0)
    except Exception as err:
        sys.stderr.write(str(err))
        sys.exit(1)

if __name__ == "__main__":
    main()

# main.py - 主程序调用
import sys
import json
import subprocess

request_payload = json.dumps({"user_id": 101, "payload": {"item": "apple", "quantity": 5}})

try:
    # 明确使用 sys.executable 保持解释器环境一致
    completed = subprocess.run(
        [sys.executable, "tasks.py"],
        input=request_payload,
        capture_output=True,
        text=True,
        timeout=10,
        check=True
    )
    response = json.loads(completed.stdout)
    print("子进程执行成功:", response["result"])
except subprocess.CalledProcessError as e:
    print(f"脚本执行失败,返回码: {e.returncode},错误详情: {e.stderr}")
except subprocess.TimeoutExpired:
    print("脚本执行超时,已被安全终止")
三、核心维度的深度对比与性能开销
在设计系统架构时,必须充分评估两种方式在性能、隔离性、数据传递和运行环境等维度的客观成本。
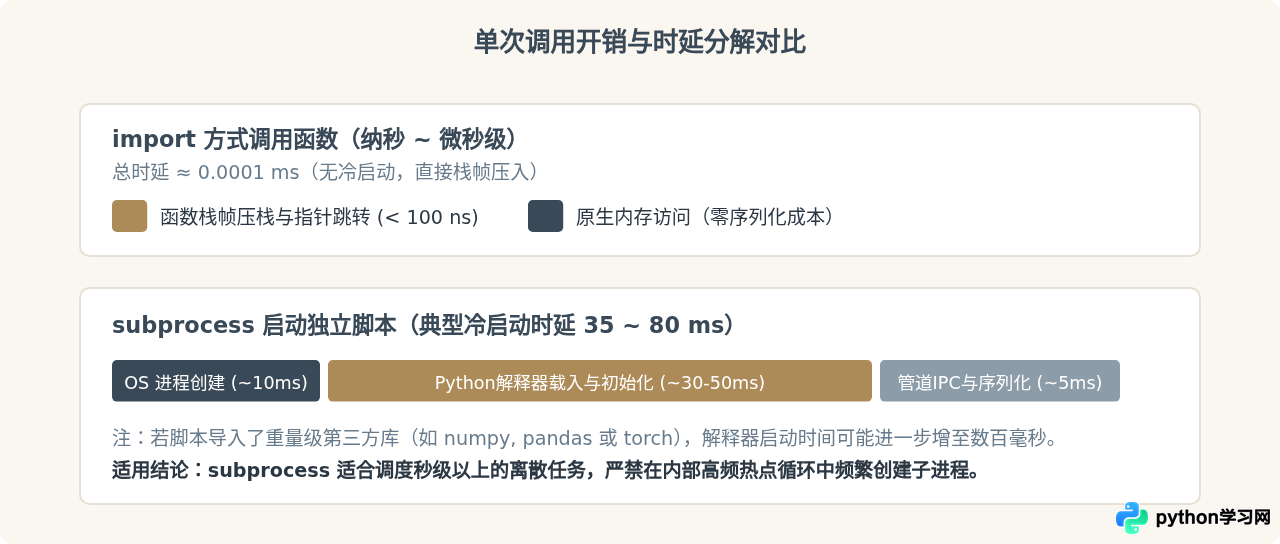
1. 执行开销与延迟构成
import 后的函数调用是纳秒级别的CPU指令执行。即使首次 import 需要读写磁盘编译模块,后续调用也是直接复用内存对象。而 subprocess 每次调用脚本,都会经历完整的“解释器冷启动”周期:操作系统开辟进程空间(约 5~15ms)、Python解释器加载基础内置模块(约 20~50ms)、加载脚本代码、最后跨管道读写数据(约 1~5ms)。如果在一个循环中高频启动子进程,系统开销将呈指数级增加。
2. 故障隔离与容错边界
在健壮性要求极高的工程实践中,隔离能力往往是决定性考量:
- 内存泄漏与崩溃扩散:在
import模式下,如果调用的模块存在 C 扩展底层缺陷(如触发段错误 Segmentation Fault)或者占用过大内存触发系统 OOM Killer,整个主程序会连带直接闪退退出,普通的try...except根本无法拦截底层段错误。而在subprocess模式下,子进程崩溃退出仅会反映为returncode = -11或非零退出码,主进程依然安然无恙,能够记录日志、告警并执行故障恢复策略。 - 超时强杀能力:Python本身的线程不支持硬终止(由于GIL和锁状态安全限制)。如果通过
import调用的函数陷入了底层死循环,主线程很难强行杀死该逻辑。而subprocess.run()提供了完善的原生timeout选项,超时后会直接向子进程发送SIGKILL信号,干净利落地清理僵死逻辑。
3. 环境兼容性与依赖冲突解耦
同一个Python进程只能加载一套依赖版本。如果模块 A 依赖 requests==2.22.0,而模块 B 依赖 requests==2.31.0,使用 import 会发生不可避免的依赖冲突。此外,如果某个旧脚本必须运行在 Python 2.7 或特定的 Conda 虚拟环境中,同进程的 import 更是无法满足。而 subprocess 允许在命令行中自由指定可执行文件路径(如 /opt/env_py27/bin/python),实现多环境、多语言、甚至混合版本的解耦运行。
四、技术选型决策与全维度对比
为了帮助开发者在实际工程中快速做出明确决断,下表汇总了两者在核心工程维度的差异:
| 对比维度 | import 模块方式 | subprocess 调用方式 |
|---|---|---|
| 进程与内存空间 | 共享当前主进程内存与上下文 | 完全独立的虚拟内存空间与全新解释器 |
| 单次调用时延 | 纳秒 ~ 微秒级(极快) | 数十毫秒 ~ 数百毫秒(存在冷启动开销) |
| 数据传输机制 | 直接内存对象引用传递,零开销 | CLI 参数 / stdin / stdout 序列化(JSON/文本) |
| 复杂对象支持 | 支持数据库连接池、打开的文件句柄、自定义类 | 仅支持可序列化的原始数据流或文件路径 |
| 故障隔离级别 | 弱(底层段错误或 OOM 直接终止主程序) | 强(子进程崩溃不影响主进程,安全获取退出码) |
| 多核并行与 GIL | 纯Python计算受单个主进程 GIL 限制 | 天然由操作系统调度到多个 CPU 核心并行 |
| 运行环境灵活性 | 必须与主程序共用同一个 Python 解释器与依赖 | 可自由指定不同的虚拟环境、Python版本或外部程序 |
| 超时强行中断 | 困难(无法安全硬杀同进程内部线程) | 原生支持(timeout 参数直接发送 SIGKILL 终止) |
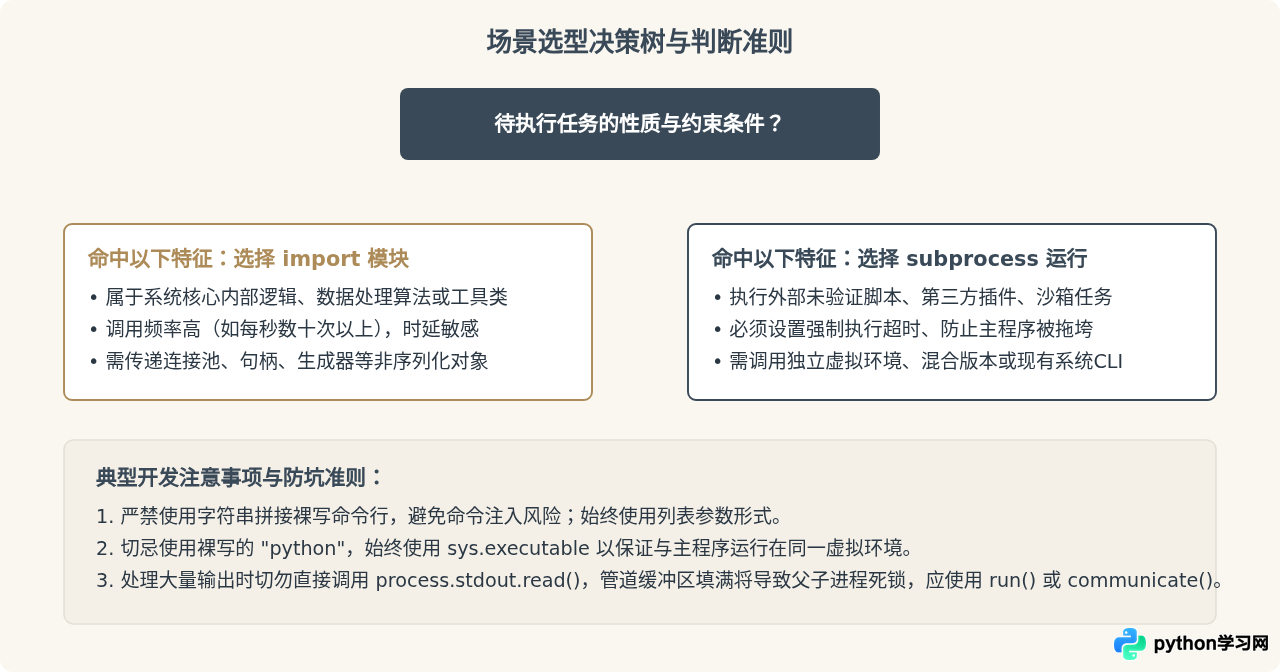
五、总结与建议
归结起来,import 与 subprocess 并非简单的替代关系,而是分管不同维度的工程工具:
当你的目标是构建内聚紧密、高频运转、对象直接复用的应用模块时,import 是第一选择,它带来最极致的性能与最自然的对象传递体验;而当你面对的是外部脚本调度、不信任代码隔离、异构环境集成、或需要防止崩溃波及核心服务的离散任务时,subprocess 则是保障系统高可用与容错隔离的坚固防线。在实际架构中,通常将内部核心业务写成模块通过 import 组织,而在调度平台、自动化脚本集成和任务工作流节点上,合理利用 subprocess 达成系统解耦。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









