

Python调用Node.js子进程执行复杂JavaScript代码
深入讲解如何通过Python的subprocess模块调用Node.js子进程执行复杂JavaScript代码,包含单次调用、常驻守护进程通信、打包与依赖管理以及死锁防范。
在数据抓取、跨语言集成和自动化任务中,我们经常遇到用纯Python难以直接处理的复杂JavaScript代码:经过高度混淆的签名算法、庞大的Webpack打包模块、包含复杂语法特性的现代前端脚本,或是深度依赖Node.js生态专有库的业务逻辑。通过Python标准库中的subprocess模块唤起Node.js作为子进程,将参数通过进程间通信传递给Node.js执行并取回结构化结果,是目前工程实践中最稳定、兼容性最高的技术路线。
一、核心选型:为什么选择子进程而非纯Python解析库
在面对JavaScript代码时,很多开发者首先会尝试使用纯Python实现的JS引擎,例如早已停止维护的PyExecJS或不支持ES6+特性的解析器。然而这类库在处理包含现代语法(箭头函数、Promise、解构赋值、BigInt)或依赖DOM/BOM全局环境的代码时,极易崩溃或报错。
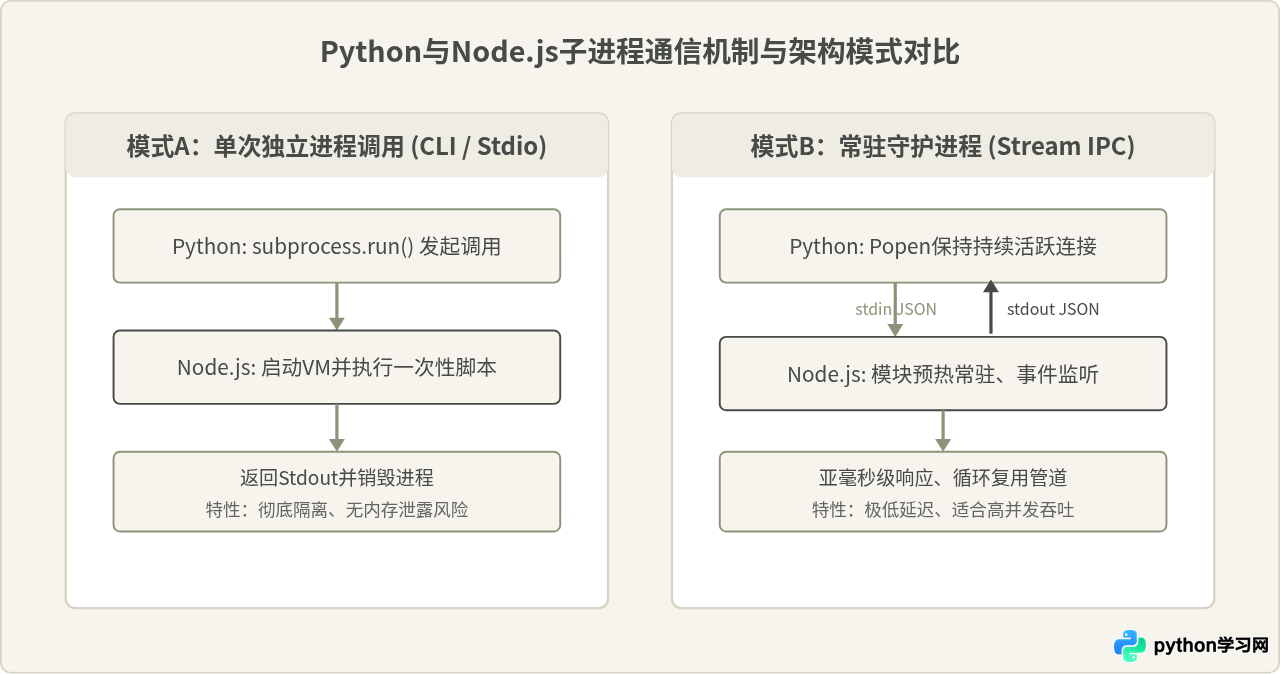
行业中常有“启动子进程开销过大,不适合生产环境”的说法。这种说法在每一次细粒度运算都重新冷启动一个Node.js进程时确实成立;但如果按任务特征划分策略——离线批处理采用单次隔离进程、高频实时服务采用常驻IPC长进程,子进程调用的稳定性和执行性能完全能够满足工业级生产需求。
二、标准实施流程:从JS封装到Python调用
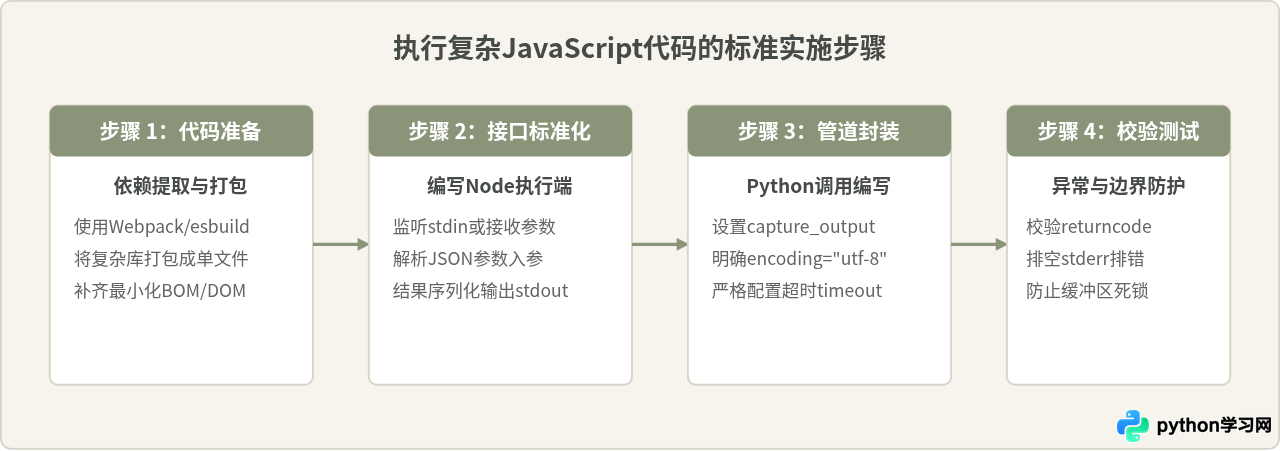
无论是简单的哈希解密还是复杂的AST分析,要让Python与Node.js顺畅协作,都遵循统一的实施路径。核心在于:不要让Python拼接裸代码给Node.js做eval,而应将JavaScript代码模块化包装,以标准输入输出(stdin/stdout)传递JSON数据。
三、方案实现一:单次调用的安全封装(subprocess.run)
单次调用适用于低频触发、批处理离线脚本或对环境隔离要求极高的任务。由于每次执行完毕操作系统会完全释放Node.js的内存,因此天然免疫内存泄漏问题。
1. Node.js端接口实现(worker.js)
建议将待处理的业务逻辑封装成一个独立文件,通过标准输入接收JSON字符串,计算后向标准输出打印结果:
// worker.js
const fs = require('fs');

function solveComplexTask(payload) {
    // 模拟复杂的JavaScript运算逻辑(如解密算法、数据处理)
    const { token, factor } = payload;
    const computed = Buffer.from(token).toString('base64');
    return {
        status: 'success',
        result: `${computed}_${factor * 2}`,
        timestamp: Date.now()
    };
}

function main() {
    try {
        // 一次性读取标准输入的全部数据
        const inputData = fs.readFileSync(0, 'utf-8');
        if (!inputData.trim()) {
            throw new Error('Empty payload received');
        }
        const payload = JSON.parse(inputData);
        const result = solveComplexTask(payload);
        process.stdout.write(JSON.stringify(result));
    } catch (err) {
        process.stderr.write(JSON.stringify({ error: err.message, stack: err.stack }));
        process.exit(1);
    }
}

main();
2. Python端安全调用实现
在Python端,严禁使用shell=True,应以列表形式指定可执行文件和参数,明确设定超时时间并指定UTF-8编码:
import json
import subprocess
from pathlib import Path
from typing import Any, Dict

def run_node_task(script_path: str, payload: Dict[str, Any], timeout_seconds: int = 10) -> Dict[str, Any]:
    """通过Node.js子进程执行单次复杂计算"""
    if not Path(script_path).exists():
        raise FileNotFoundError(f"Script file not found: {script_path}")

    serialized_input = json.dumps(payload, ensure_ascii=False)
    cmd = ["node", script_path]

    try:
        proc = subprocess.run(
            cmd,
            input=serialized_input,
            capture_output=True,
            text=True,
            encoding="utf-8",
            timeout=timeout_seconds,
            check=False  # 手动检查returncode以提供更详尽的诊断信息
        )
    except subprocess.TimeoutExpired as e:
        raise TimeoutError(f"Node.js sub-process timed out after {timeout_seconds}s") from e

    if proc.returncode != 0:
        error_msg = proc.stderr.strip() or f"Process exited with code {proc.returncode}"
        raise RuntimeError(f"Node.js execution failed: {error_msg}")

    try:
        return json.loads(proc.stdout)
    except json.JSONDecodeError as e:
        raise ValueError(f"Failed to parse Node.js output: {proc.stdout}") from e

# 示例调用
if __name__ == "__main__":
    test_payload = {"token": "hello_python_node", "factor": 21}
    result = run_node_task("worker.js", test_payload)
    print("Execution Result:", result)
四、方案实现二:高频长驻子进程管道(subprocess.Popen)
当面对Web后台服务或爬虫高频解密时,频繁启动Node.js会产生每秒数十次至上百次的V8虚拟机冷启动开销(每次约20ms~100ms)。通过保持一个长连接子进程,并使用基于换行符分隔的JSON(NDJSON)进行双向流式通信,可将单次调用延迟压缩至1毫秒以内。
1. 常驻Node.js服务端(daemon.js)
// daemon.js
const readline = require('readline');

// 初始化环境(加载复杂依赖库、预热V8)
const rl = readline.createInterface({
    input: process.stdin,
    output: process.stdout,
    terminal: false
});

rl.on('line', (line) => {
    if (!line.trim()) return;
    try {
        const { id, action, data } = JSON.parse(line);
        // 执行具体JS函数
        const output = {
            id,
            code: 0,
            data: `Processed [${action}]: ` + Object.keys(data).join(',')
        };
        // 关键:以单行JSON形式输出,末尾必须带换行符
        process.stdout.write(JSON.stringify(output) + '\n');
    } catch (err) {
        process.stdout.write(JSON.stringify({ code: -1, error: err.message }) + '\n');
    }
});
2. Python常驻管理器实现
import json
import subprocess
import threading
from typing import Any, Dict

class NodeDaemonClient:
    def __init__(self, script_path: str):
        self.proc = subprocess.Popen(
            ["node", script_path],
            stdin=subprocess.PIPE,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            encoding="utf-8",
            bufsize=1  # 行缓冲
        )
        self._lock = threading.Lock()

    def send_request(self, req_id: str, action: str, data: Dict[str, Any]) -> Dict[str, Any]:
        """向常驻Node.js写入一行请求并同步等待对应返回"""
        payload = json.dumps({"id": req_id, "action": action, "data": data}, ensure_ascii=False)
        with self._lock:
            if self.proc.poll() is not None:
                raise RuntimeError("Node.js daemon process is not running")

            # 写入单行请求
            self.proc.stdin.write(payload + "\n")
            self.proc.stdin.flush()

            # 读取单行响应
            response_line = self.proc.stdout.readline()
            if not response_line:
                raise RuntimeError("Node.js process closed stdout stream unexpectedly")
            return json.loads(response_line)

    def close(self):
        """优雅关闭子进程"""
        with self._lock:
            if self.proc.poll() is None:
                self.proc.stdin.close()
                self.proc.terminate()
                self.proc.wait(timeout=3)
五、深度避坑:管道缓冲区死锁与内存控制
在子进程交互中,最隐蔽、最致命的故障是操作系统管道缓冲区死锁(Pipe Buffer Deadlock)。在Linux和macOS等类Unix系统中,管道(Pipe)的默认缓冲区容量通常为64KB。
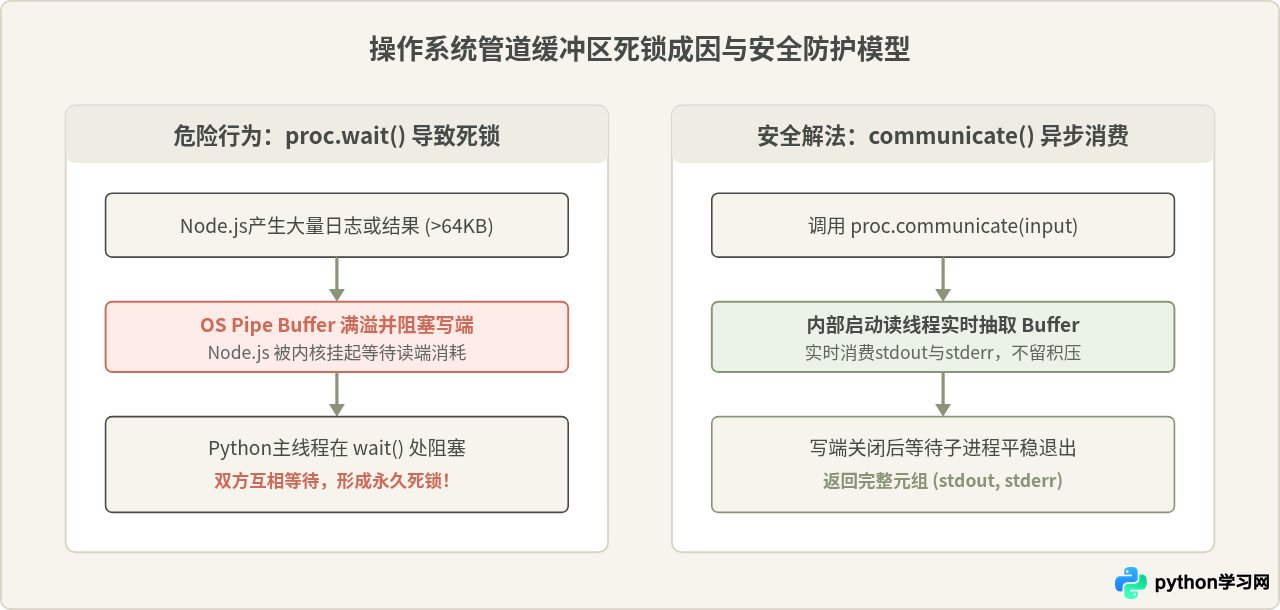
proc.wait()再去调用proc.stdout.read(),程序将100%永久卡死。对于一次性任务,始终优先使用封装好的subprocess.run()或底层proc.communicate(),它们内部会在多线程中同时排空输出流,杜绝缓冲区填满挂起。
六、复杂代码的打包与运行环境补齐
很多前端加密代码依赖了浏览器专有的全局对象(如window、document、navigator、location)。直接在Node.js中运行会抛出ReferenceError: window is not defined。解决该问题有两种常用做法:
- 最小化补齐(轻量级):在JS脚本顶部手工挂载必须的属性。例如:
global.window = global; global.navigator = { userAgent: "Mozilla/5.0..." };,对于大多数纯数学逆向计算已完全足够。 - 借助JSDOM(完备级):对于深度绑定DOM树操作的复杂逻辑,在本地通过
npm install jsdom安装,并在入口处注入虚拟DOM环境。 - 模块打包(工程化):当复杂JS包含多个NPM依赖包时,严禁让Python逐个拷贝node_modules。应在Node端使用
esbuild app.js --bundle --platform=node --outfile=dist.js输出单文件,Python直接调用打包后的dist.js即可。
七、总结与技术选型决策
在Python中执行JavaScript,并非只有“全盘改写为Python”和“直接引入笨重中间件”这两个极端。掌握基于子进程的调用方式,能在极小改造成本下获得原生Node.js引擎的全部能力。
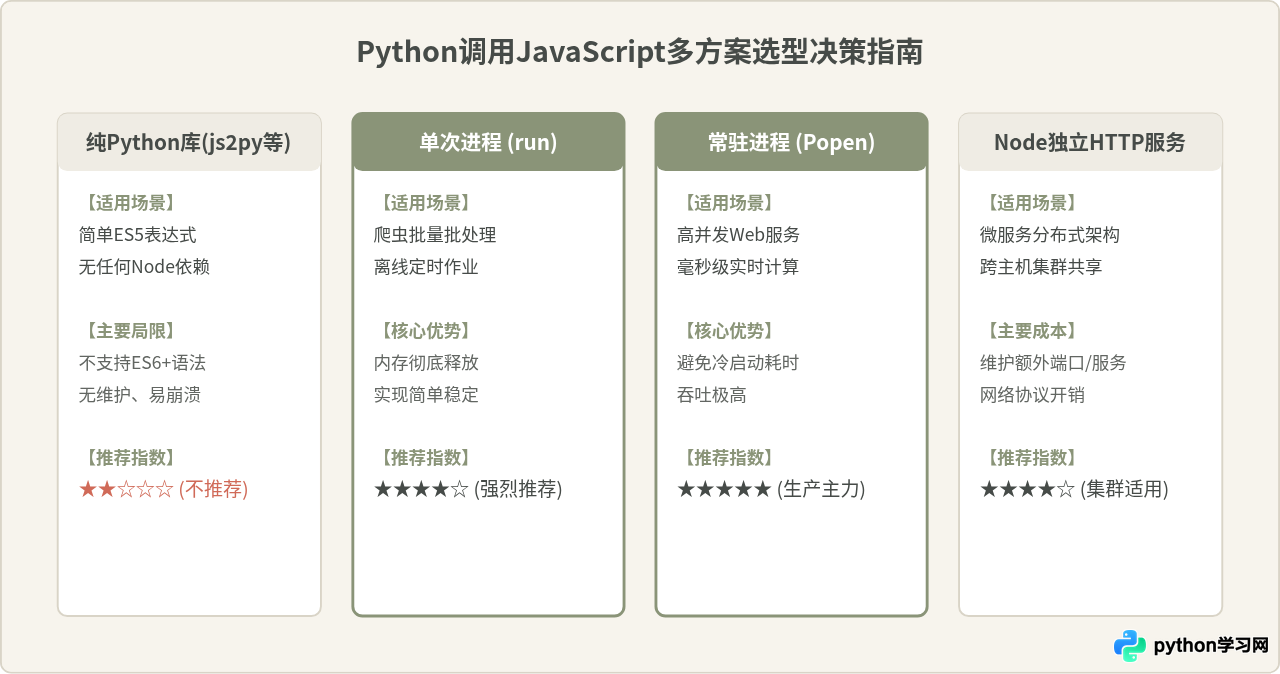
结合具体业务:如果任务属于日处理数万次的定时离线作业,直接使用subprocess.run()辅以严格的超时和捕获,是实现成本最低、运维最省心的方案;若接入在线API响应链条,构建常驻守护进程并配合输入输出单行JSON流,即可在单台机器上支撑高吞吐的复杂JavaScript执行需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









