

Python在线编译器怎么保存和分享代码链接?

在 Python 在线编译器中保存和分享代码,核心操作是点击界面工具栏的“Save”(保存)或“Share”(分享)按钮,由平台生成一个包含代码状态的独立网络地址(URL)。目前主流在线工具主要分为两类机制:轻量型编译器直接将源码经过压缩编码放入 URL 的哈希或查询参数中,无需登录即可复制链接分享;工程型云端编译器则将代码写入数据库并生成唯一项目 ID,通常支持多文件组织和权限管理。读者只要明确所用平台的类型,按照规范导出对应链接并在独立无痕窗口中完成打开验证,即可确保他人正常阅读与运行代码。
一、通用保存与分享标准步骤
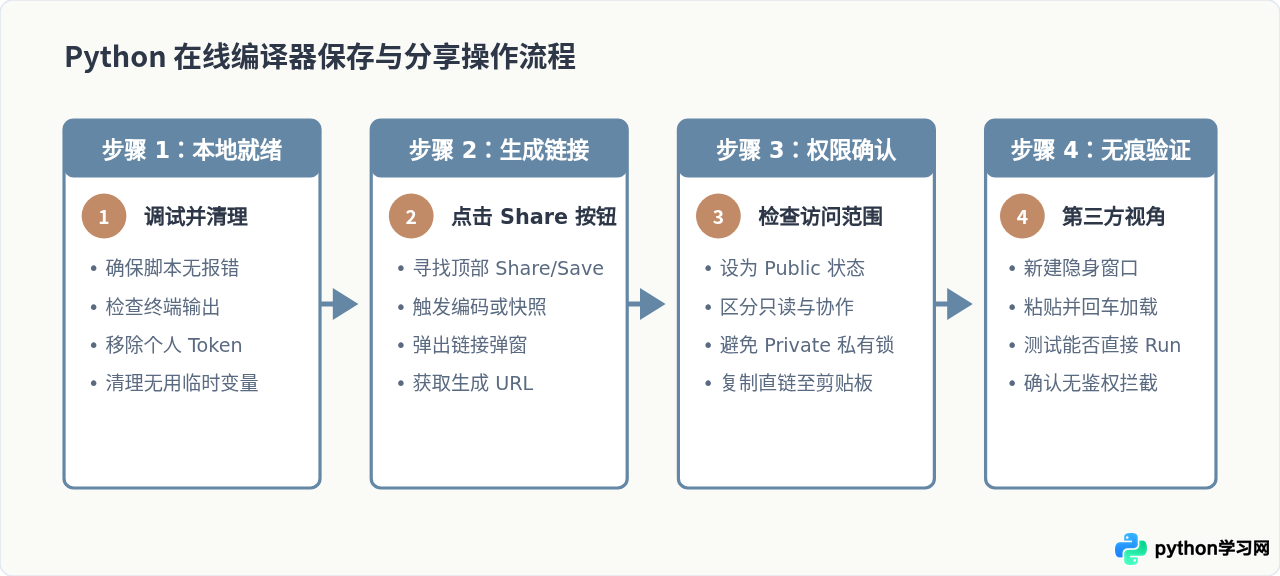
不论使用哪一个具体的在线 Python 平台,获取并验证有效分享链接的完整路径都遵循统一的标准操作流程:
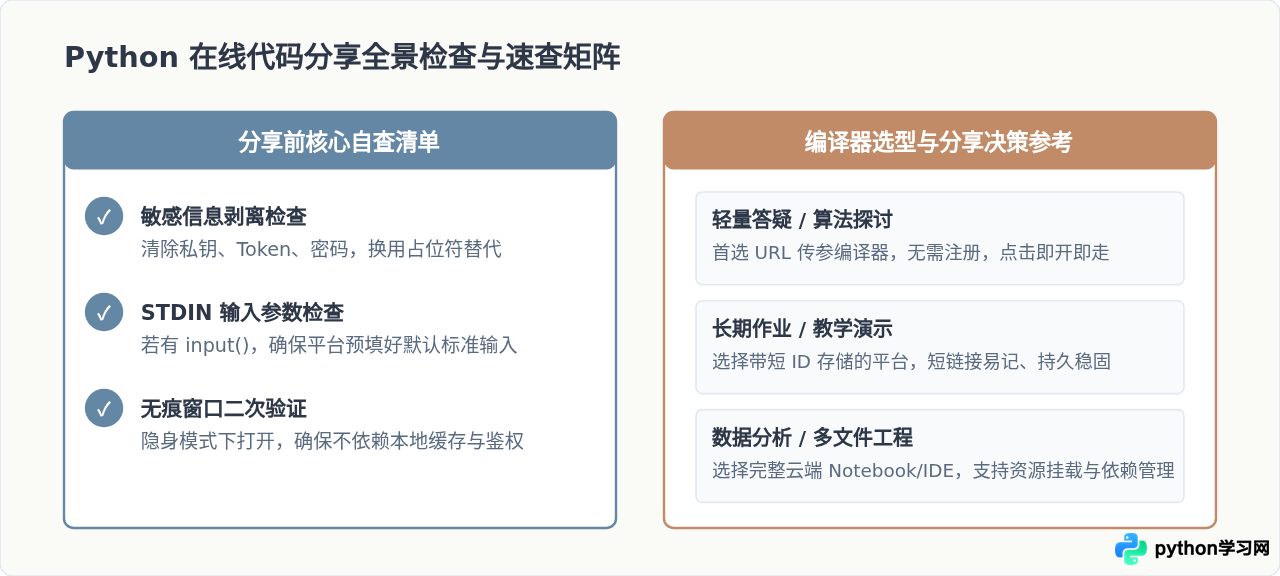
- 代码准备与调试:在主编辑器区域输入 Python 脚本,点击“Run”确认程序逻辑无误,控制台输出预期结果。在保存前务必检查并清除个人密码、API 密钥等机密信息。
- 触发保存或生成分享:找到编辑器顶栏或侧边栏的
Share、Save或Fork按钮。部分平台在未登录时会自动转为临时只读快照模式。 - 设置访问权限:如果平台支持权限管理,确认可见性处于“Public”(公开)或“Anyone with the link can view”(任何人凭链接可读)。
- 复制与外部验证:点击“Copy Link”获取完整 URL。随后在浏览器新开一个“无痕/隐身窗口”,将链接粘贴打开,确认无需作者账号登录也能正常加载代码并运行。
二、两种核心分享机制的底层原理
为什么有些在线编译器的分享链接特别长,而另一些则是一个简短的代号?这源于平台采取的底层存储策略不同。
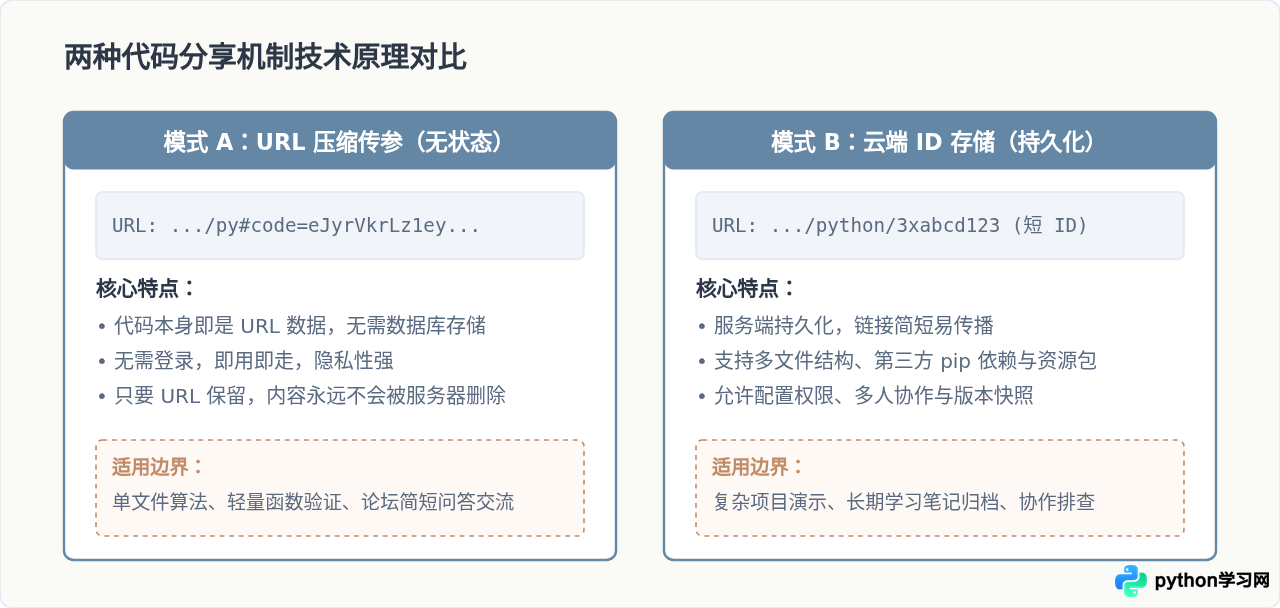
1. 客户端无状态模式(URL Hash / Query 参数编码)
在轻量型在线编译器(如 Python Tutor、部分轻量级 Pastebin 等)中,平台并不在服务器数据库中为你开辟持久化记录。当用户点击分享时,前端 JavaScript 会直接把编辑器里的 Python 代码提取出来,通过 Base64 编码、LZ 压缩算法或 URL 编码转换成一长串字符串,直接拼接到网址末尾:
# 典型的 URL 参数编码链接形态示意
https://example.com/python#code=eJyrVkrLz1eyUlBQqlWwVTBQcvRzVNC05lIAAhwGCA==
接收者在浏览器打开该链接时,前端脚本会读取 #code=... 后的参数,解压还原成原始代码并填入文本框。这种模式的显著优点是无需注册登录且永久有效(只要平台算法不改动),但缺点是URL 长度受限,不适合存放包含大量数据定义或多模块的长篇代码。
2. 服务端持久化模式(云端项目 ID 与短链接)
在完整云端 IDE(如 Replit、OneCompiler、Google Colab 等)中,点击 Save 或 Share 会触发一个向后端 API 发送的 HTTP POST 请求。服务器将代码内容、依赖环境配置和文件名存入数据库或对象存储,并分配一个全局唯一的短 ID:
# 典型的项目 ID 短链接形态示意
https://onecompiler.com/python/3xabcd123
访客访问此链接时,服务器根据 3xabcd123 查询数据库并将项目状态下发给访客。这种模式支持多文件项目、依赖包安装和协同编辑,但往往需要作者注册账号以便日后管理,并且链接的存活周期依赖平台的保留策略。
三、访客打开链接后的代码隔离与复刻(Fork)机制
很多初学者在分享链接时会担心一个问题:“他人打开我的代码并进行了修改或运行,会直接篡改或覆盖我原本写好的代码吗?”
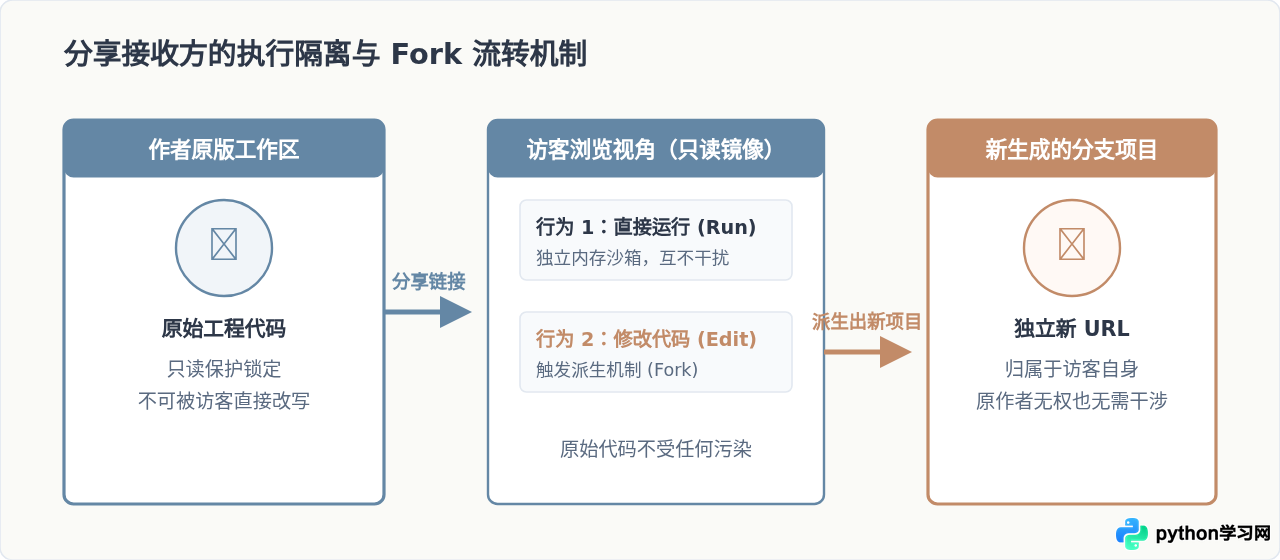
在合格的现代在线编译器中,答案是绝对不会。平台普遍遵循“快照只读 + 独立派生(Fork)”原则:
- 默认只读权限:通过分享链接进入页面的访客,看到的是你保存时刻的一个“静态镜像快照”。访客所按下的“Run”按钮,是在平台为该访客动态分配的独立临时容器或浏览器本地 WebAssembly 沙箱中执行,其运行结果和终端交互仅对访客本人可见。
- 编辑另存为分支:如果访客直接在编辑器中修改了代码并点击“Save”,平台会自动触发
Fork(复刻)逻辑,在访客的浏览器本地或其个人账号下生成一个新的代码分支与全新 URL,原作者的代码链接内容始终保持原样不变。
四、保存与分享常见问题与排查
在实际操作中,很多分享失败的场景并非编译器本身故障,而是由于疏忽了环境与状态依赖。以下是三项最关键的检查点:
1. 为什么把链接发给朋友后,对方看到的是空白或默认模板?
这是最常见的新手问题。原因通常有两个:
- 复制了浏览器地址栏的原生静态地址:很多平台在未点击“Save”前,地址栏只是通用的
.../compiler/python。必须先触发保存,待地址栏出现唯一的哈希参数或短 ID 后,再复制该新地址。 - 浏览器隐私清理策略:某些平台未登录状态下的草稿保存在浏览器的
LocalStorage或 Cookie 中。作者在自己浏览器里打开有代码,但换一台设备或无痕模式就没有。只有平台生成了带参数的专属 URL 才算完成云端存储。
2. 本地运行正常的代码,分享后在对方机器上报错?
这通常与“交互式输入”和“第三方扩展包”有关:
- 使用了
input()阻塞输入:许多轻量在线编译器不支持实时终端交互输入,或者需要预先在专门的“STDIN / Input”文本框中填入测试数据。若未预先配置,访客点击 Run 会提示 EOFError(例如EOF when reading a line)。 - 第三方第三方依赖库未声明:如果使用了
numpy、pandas或requests,轻量在线编译器可能未内置该库。若项目依赖特定库,建议使用支持包管理的完整在线 IDE 并确认已配置依赖。
安全警示:永远不要在公开分享的代码中保留任何敏感信息,例如数据库连接串、邮箱授权码、微信开放平台 Secret 或个人云服务器的 SSH 密钥。所有在线分享链接一旦公开在网络上,任何爬虫或人员均可读取其明文源码。若代码逻辑必须包含密钥,请统一使用环境变量或占位符提示替换(例如 API_KEY = "YOUR_KEY_HERE")。
五、总结
要在 Python 在线编译器中顺利保存和分享代码链接,关键在于认清当前编译器所依赖的技术方案:如果使用的是无状态的 URL 编码型编译器,保存的核心动作就是点击生成并复制带有完整 Hash 参数的完整网址;如果使用的是云端数据库存储型编译器,则需要先通过 Save/Share 生成持久化项目 ID 短链接,并确认项目权限处于公开可见状态。牢记“在无痕窗口中验证打开”这一操作习惯,并彻底清除代码中的敏感密钥与未配置的本地环境依赖,即可高效、安全地完成代码跨设备交流与技术协作。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









