

Python网络爬虫能做什么?合法采集公开数据的应用与限制
全面解析Python网络爬虫的核心能力、典型合法公开数据采集场景、合法性边界与技术限制,提供合规采集的实践步骤与代码示例。
Python网络爬虫本质上是一套自动发送网络请求并按规则解析页面内容的脚本程序。在日常互联网应用中,它能够代替繁琐重复的人工操作,高效获取网页上公开发布的价格、文章、公告和统计指标。然而,爬虫并不能无所顾忌地抓取一切数据,数据采集必须严格限制在公开可见、低频合理、符合协议与法律规范的边界之内。本文将详细讲解Python爬虫的核心能力、常见应用场景、标准实现步骤以及必须遵守的合规限制。
一、Python网络爬虫的核心能力与工作机制
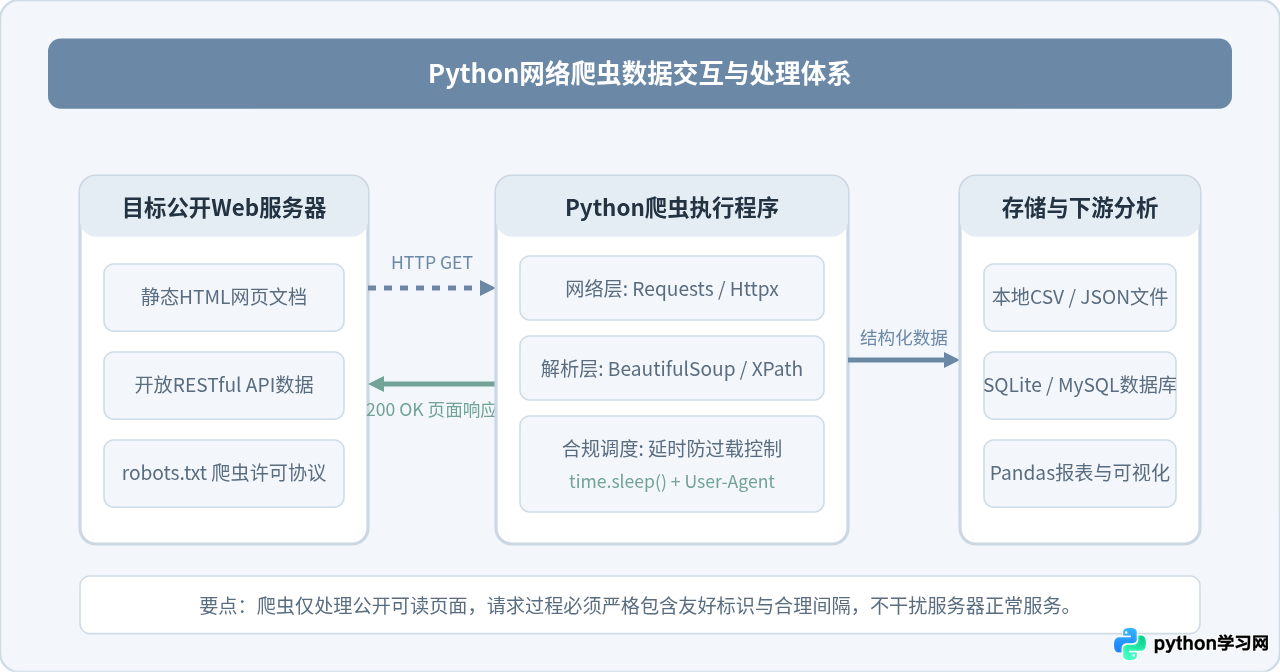
简单来说,网络爬虫完成的工作与普通用户在浏览器中浏览网页的过程在底层原理上是一致的。浏览器通过向目标Web服务器发送HTTP或HTTPS请求,获取HTML文档并渲染成可视化页面;而Python爬虫则是通过代码发起相同的网络请求,跳过图形界面渲染,直接对返回的网页源码或结构化数据进行定向过滤、匹配与提取。
在具体工程实现中,Python爬虫通常具备以下三项核心能力:
- 自动化网络通信:借助标准库或成熟的网络组件(如
requests、httpx、urllib),自动完成URL排队、会话维持、Cookie传递以及请求头伪装。 - 页面结构化解析:通过DOM树解析器(如
BeautifulSoup、lxml)或路径查询语法(XPath、CSS选择器),快速定位目标节点并提取标题、正文、发布时间、价格等字段。 - 批量持久化与管道流转:提取到的纯文本和结构化数据可以直接清洗格式,并无缝流转写入本地CSV表格、JSON文件或关系型数据库(如SQLite、MySQL)。
二、合法采集公开数据的典型应用场景
在遵守法律法规和目标平台服务条款的前提下,Python网络爬虫被广泛应用于多个正当行业场景中,主要体现在以下四个方向:
1. 公开商品价格跟踪与比价监控
很多电商平台与零售商会将商品名称、规格、现价以及促销标签直接公开在商品详情页中。个人用户或比价工具可以通过定时爬虫抓取目标公开商品页的价格,记录价格波动趋势,并在降价达到预期时向用户发送通知,帮助消费者做出更经济的购买决策。
2. 学术科研与公共统计数据分析
高校学者和科研机构在进行经济学、社会学或环境科学研究时,常常需要获取公开的宏观经济指标、历史天气记录、空气质量指数或各地统计年鉴。利用爬虫自动汇总这些原本分散在各部门门户网站上的公开表格,可以节省大量手工下载和整理的时间,保证科研样本的完整性。
3. 行业新闻与公开资讯聚合
科技资讯平台或垂直领域的研究团队需要实时跟进公开的技术动态与政策公告。通过定向爬虫定期抓取公开的官方博客、技术社区RSS源以及行业协会通知,可以在第一时间聚合行业资讯,建立内部知识库或每日动态简报。
4. 企业公开资质与招标信息检索
政府采购网、公共资源交易平台以及全国企业信用信息公示系统上公布了大量的公开招标和中标结果。企业可以通过合规爬虫筛选与自身主营业务相关的关键词,自动整理最新的投标机会与公示结果,提高市场调研与业务响应效率。
三、合规采集的技术实现:规范执行四步法
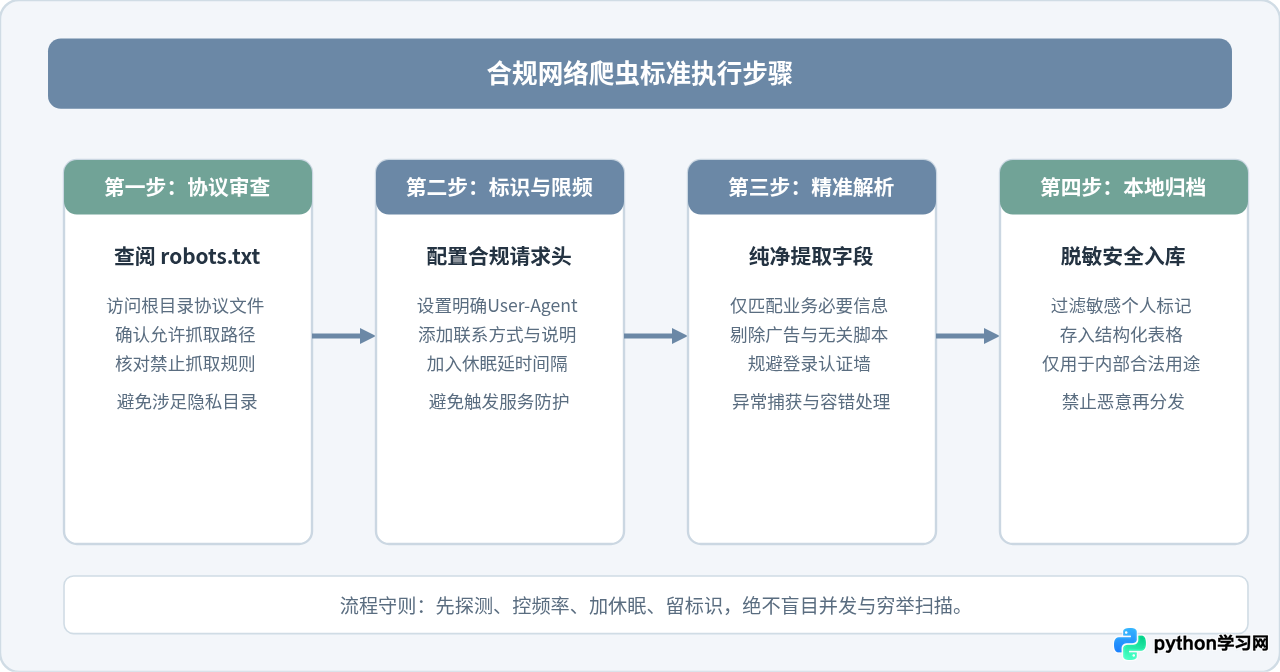
编写爬虫时,遵守合规标准不仅体现在法律层面,更直接体现在代码实现的细节中。一个合规且健康的爬虫应当遵循“先检查、明身份、控频率、存公开”的原则。以下是完整的操作步骤与示例代码:
规范采集代码示例
下面展示了一个使用 requests 和 BeautifulSoup 获取公开文章列表的完整范例。请注意代码中对请求头 User-Agent 的显式声明以及在循环中加入的 time.sleep(2) 间隔:
# -*- coding: utf-8 -*-
"""
规范的公开数据采集范例
运行环境:Python 3.8+
依赖库:pip install requests beautifulsoup4
"""

import time
import requests
from bs4 import BeautifulSoup

# 1. 目标地址:必须是已开放公开展示的页面
TARGET_URL = "https://example.com/public/news"

# 2. 规范定义请求头:明确标识客户端类型与联系用途,避免空白或默认的Python标识
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36 (Academic-Study-Bot/1.0)",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
}

def fetch_public_articles(page_count=3):
    """
    抓取公开文章标题与发布时间
    :param page_count: 抓取页数,严格受控,不可无限抓取
    """
    collected_records = []

    for page in range(1, page_count + 1):
        url = f"{TARGET_URL}?page={page}"
        print(f"[INFO] 正在获取第 {page} 页公开数据: {url}")

        try:
            # 设置超时时间(timeout),避免网络阻塞导致脚本死锁
            response = requests.get(url, headers=HEADERS, timeout=10)

            # 严格核对状态码
            if response.status_code == 200:
                response.encoding = response.apparent_encoding or "utf-8"
                soup = BeautifulSoup(response.text, "html.parser")

                # 定位目标文章卡片容器
                items = soup.find_all("div", class_="article-item")
                for item in items:
                    title_elem = item.find("h3")
                    date_elem = item.find("span", class_="publish-date")

                    title = title_elem.get_text(strip=True) if title_elem else "无标题"
                    pub_date = date_elem.get_text(strip=True) if date_elem else "未知时间"

                    collected_records.append({
                        "title": title,
                        "date": pub_date
                    })

            elif response.status_code == 403:
                print(f"[WARN] 触发访问权限限制(403 Forbidden),立即停止抓取!")
                break
            else:
                print(f"[WARN] 服务器返回异常状态码: {response.status_code}")

        except requests.exceptions.RequestException as e:
            print(f"[ERROR] 网络请求异常: {e}")
            break

        # 核心合规点:每次抓取之间强制休眠,降低目标服务器瞬时并发压力
        print("[INFO] 等待休眠 2 秒以维持服务器友好负载...")
        time.sleep(2)

    return collected_records

if __name__ == "__main__":
    results = fetch_public_articles(page_count=2)
    print(f"\n[SUCCESS] 成功采集公开条目共 {len(results)} 条。示例结果前2条:")
    for r in results[:2]:
        print(f" - 日期: {r['date']} | 标题: {r['title']}")
- 代码中始终配置了合理的
timeout=10参数,保证爬虫在目标服务器响应慢时及时断开,避免占用双方连接资源。 - 在循环之间加入
time.sleep(2),绝不使用死循环或超高并发多线程对单个中小型网站发起瞬时轰炸。 - 捕获到 403 状态码时主动 break 退出,而不是切换代理盲目重试或强行绕过。
四、合法采集的红线与限制条件
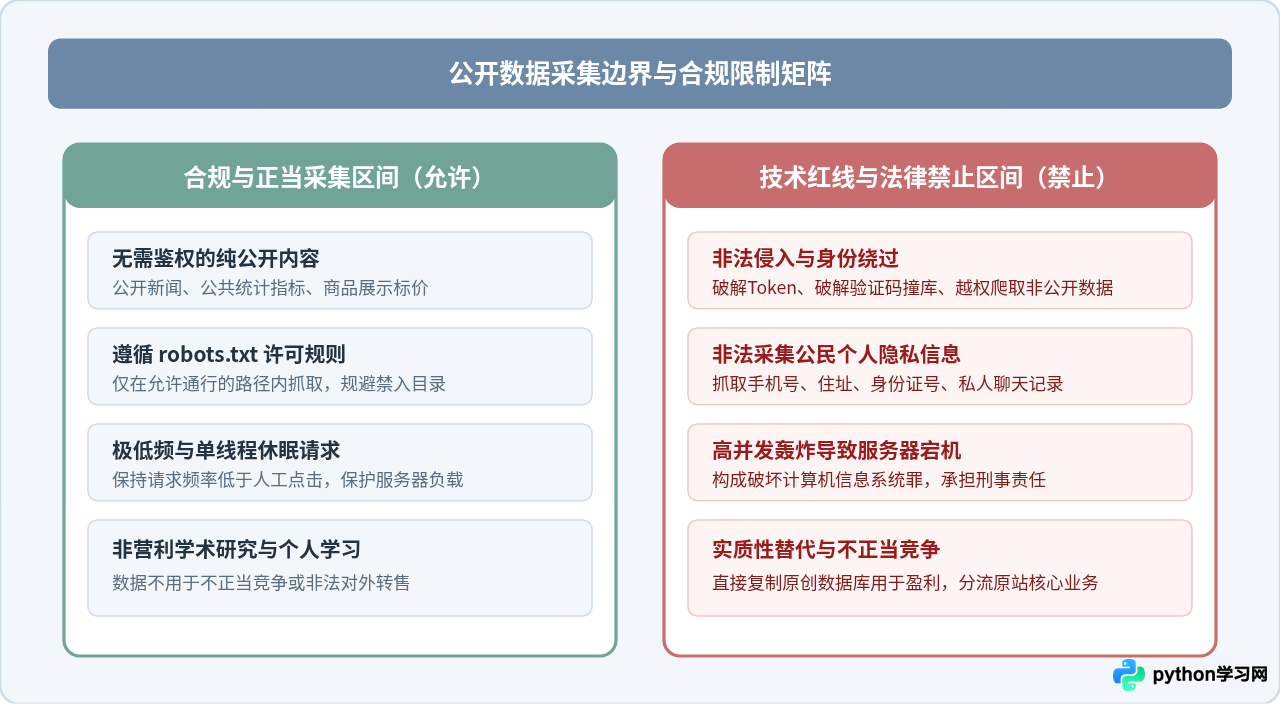
网络爬虫不是法外之地。技术本身是中立的,但使用技术的目标、手段与数据归属具有严格的法律与商业边界。以下三项限制是任何网络爬虫开发者必须牢牢遵守的红线:
1. 身份认证与访问权限限制:绝不越权抓取
法律上判断爬虫是否违规的一大核心标准是“是否侵入计算机信息系统”。如果一个页面需要用户账号登录、输入手机短信验证码、或者通过复杂的加密签名才能看到,说明该数据并不属于无限制的“公开数据”。采用逆向破解、Session劫持或越权漏洞强行爬取这些私域信息,极易构成非法获取计算机信息系统数据罪。
2. 系统稳定性与并发限制:绝不构成拒绝服务
任何Web服务器的算力和带宽都是有上限的。如果不加节制地使用海量线程对目标网站发起连续高频扫描,导致服务器CPU占用100%、正常商业用户无法访问甚至系统瘫痪,即使爬取的是完全公开的数据,也属于破坏计算机信息系统行为。爬虫必须遵守速率限制,做到“润物细无声”。
3. 知识产权与商业竞争限制:绝不搞“实质性替代”
反不正当竞争法和著作权法对爬虫采集有着清晰的判例约束。如果采集他人网站投入巨大成本沉淀的独创性内容(如专业点评、原创数据库、深度评测),并以此搭建一个功能高度重合的竞品平台进行商业变现,导致原平台核心流量流失,属于典型的不正当竞争行为,必然面临高额赔偿。
五、合规采集的最佳实践与决策指南
面对具体的数据获取需求时,开发者应当建立起标准化的评估与决策机制。并不是所有需求都需要启动爬虫,在很多情况下,有更稳妥、更合规的选择:
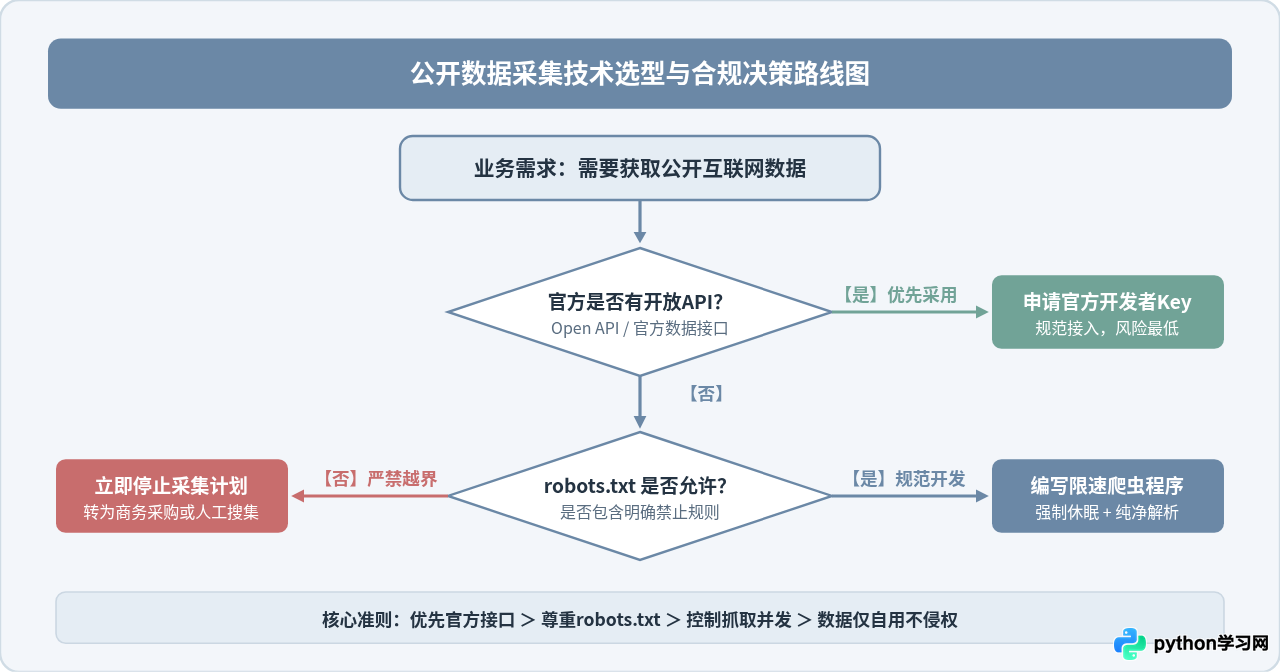
在日常技术实践中,请务必建立并坚持以下三条工程习惯:
- 优先寻找官方开放API:很多大型平台(如GitHub、各类公共数据开放平台、天气预报服务)都提供了标准的RESTful接口。使用API不仅格式规范、解析稳定,而且调用受到官方授权与计费配额保护,维护成本远低于频繁应对网页前端改版与反爬机制。
- 尊重并理解网站的反爬机制:当遇到网站返回403 Forbidden、要求输入滑块验证码或短暂封禁IP时,这是目标服务器发出的明确拒绝信号。正确的做法是立刻暂停程序并检查自身抓取频率是否过高,而不是盲目购买代理池、堆砌多线程或试图破解验证码强行对抗。
- 严格限制存储范围与访问权限:采集落库的数据仅应保存在受控的私有环境中,定期清理包含个人隐私风险或已失效的冗余字段。对外展示分析结论时,应尽量以汇总统计图表或分析报告的形式呈现,避免直接二次分发原网原始网页全文。
总结
Python网络爬虫是一把强大的数据自动化采集工具。它能够极大解放生产力,协助我们完成价格监测、科学研究、新闻聚合与商业研判等有价值的工作。但技术自由必须以合规守法为前提:只有坚持采集公开信息、遵守robots协议、设置温和的抓取频率并合理合法使用数据,才能让爬虫技术在阳光下持续发挥其应有的效率与价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









