

Python中type()与__class__获取类名的区别
深入对比在Python中使用type(obj).__name__与obj.__class__.__name__获取类名的底层原理、执行机制与关键差异,涵盖属性查找、代理绕过、Mock伪装及生产实践中的选型考量。
在日常的Python开发中,获取一个对象所属的类名通常有两种写法:type(obj).__name__ 和 obj.__class__.__name__。对于绝大多数普通自定义对象或内置基础类型,这两种方式返回的结果完全相同,甚至让许多开发者误以为它们只是语法糖层面的差异。然而,这两者背后的运作机制有着本质的不同:type(obj) 直接读取对象底层的物理类型指针,无法被常规属性查找劫持;而 obj.__class__ 则遵循Python的属性查找协议,可以被描述符、动态属性拦截甚至重写。了解这一区别,是在编写高鲁棒性代码、处理动态代理对象、编写单元测试Mock以及安全审计时的关键前提。
一、直观现象与核心差异定义
先来看一个最直观的对照。在标准类实例上,两者没有任何表面分歧:
class Worker:
    pass

worker = Worker()
print("type() 获取:", type(worker).__name__)
print("__class__ 获取:", worker.__class__.__name__)type() 获取: Worker
__class__ 获取: Worker
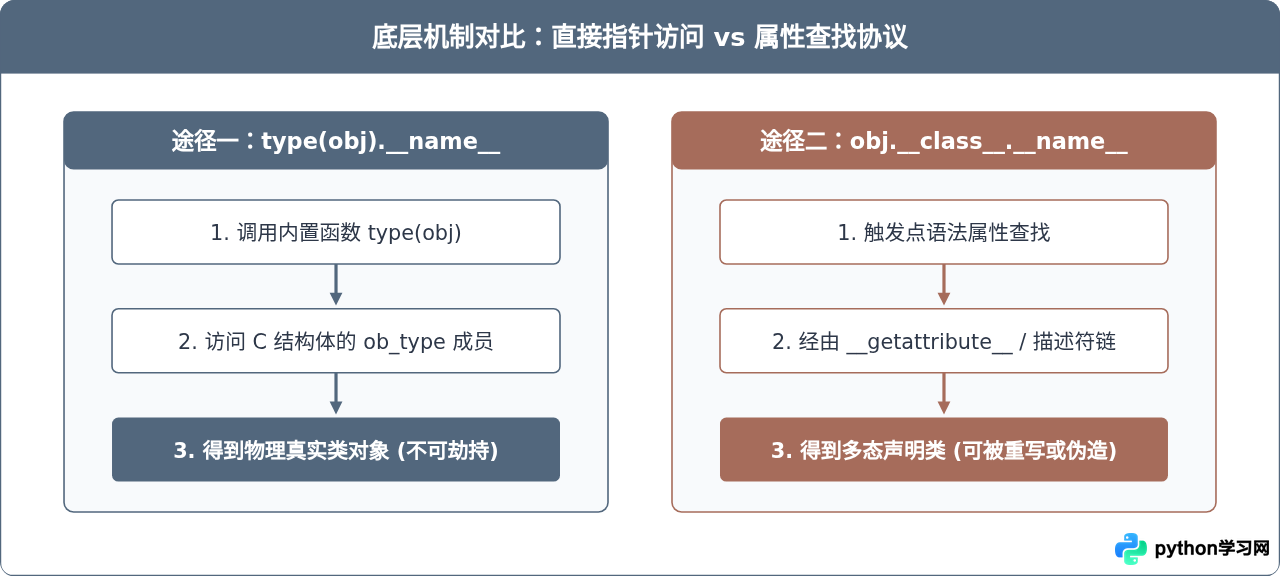
这种表面一致性掩盖了底层的处理分流。我们可以将两者的核心区别归结为一句话:type(obj) 是物理性质的类型探查,直接询问CPython虚拟机该对象的真实类型;而 obj.__class__ 是多态性质的属性查询,询问对象“它声明自己属于哪个类”。
二、底层执行原理解析
为了看清这种区别,我们需要深入到CPython的执行层。
每个Python对象在CPython内部均由一个以 PyObject 为基础的结构体表示。该结构体包含两个核心成员:引用计数 ob_refcnt 以及指向类型对象的指针 ob_type。内置函数 type(obj) 在传入单个参数时,其C源码底层对应的是 PyObject_Type() 或宏定义 Py_TYPE(obj)。它直接读取内存中 ob_type 所指向的结构,不经过任何Python层面的方法分发或拦截机制。这就从根源上杜绝了在Python层篡改 type() 返回值的可能性。
反观 obj.__class__,它是一个常规的特殊属性。在Python的对象模型中,访问 obj.__class__ 会触发 obj.__getattribute__('__class__')。默认情况下,类对象上挂载了一个名为 __class__ 的获取描述符(getset descriptor),它负责返回该实例对应的类型。但正因为它是一个属性访问过程,意味着它完全受制于Python属性查找的全部规则:如果实例自身重写了 __getattribute__,或者通过定义属性拦截了 __class__,那么最终拿到的类名就可以被替换为任意值。
三、三类典型场景中的行为差异
当对象不再是纯粹的朴素实例时,这两种机制的差别会立即暴露出来。
1. 代理对象(Proxy)与透明转发
在设计模式中,代理模式常用于延迟加载(如 SQLAlchemy 的动态关联查询)、弱引用管理(如 weakref.proxy)以及RPC远程调用客户端。代理模式的核心诉求是“隐形”:它希望对外表现得就像被代理的目标对象一样。此时,代理对象通常会刻意转发 __class__ 属性,以满足客户端的 duck typing 检查;但 type() 会立刻击穿这一层包装。
import weakref

class HeavyResource:
    pass

resource = HeavyResource()
proxy = weakref.proxy(resource)

print("真实物理类型 type():", type(proxy).__name__)
print("多态声明类型 __class__:", proxy.__class__.__name__)真实物理类型 type(): PyWeakProxy
多态声明类型 __class__: HeavyResource
从输出可以看出,proxy.__class__.__name__ 诚实地汇报了目标资源是 HeavyResource,实现了代理的透明性;而 type(proxy).__name__ 报告了它是一个 PyWeakProxy。如果你在编写通用的序列化中间件,错误地使用了 type(),就会导致序列化器去处理弱引用包装类而非实际业务数据。
2. 单元测试中的 Mock 伪装
在编写自动化测试时,Python标准库的 unittest.mock.MagicMock 是常用的工具。我们可以为 Mock 对象指定 spec 约束,使其在属性和行为上模拟目标类。为了保证被测函数在使用 obj.__class__ 检查时能够通过,Mock 内部主动将 __class__ 属性指向了被伪装的 spec 类:
from unittest.mock import MagicMock

class DatabaseClient:
    pass

mock_client = MagicMock(spec=DatabaseClient)

print("Mock对象的 type():", type(mock_client).__name__)
print("Mock对象的 __class__:", mock_client.__class__.__name__)Mock对象的 type(): MagicMock
Mock对象的 __class__: DatabaseClient
如果被测代码中充斥着 type(obj) is DatabaseClient 或 type(obj).__name__ == "DatabaseClient" 这种写法,Mock对象就会直接失效,强制测试人员不得不去修改实现代码或采用更晦涩的打桩手段。
3. 显式覆盖 __class__ 实现类型伪装
Python允许在实例或类中动态重写属性。例如,某些状态机实现或安全沙箱会利用 __class__ 的动态重写来完成运行时的状态跃迁:
class RealUser:
    @property
    def __class__(self):
        class DisguisedAdmin:
            pass
        return DisguisedAdmin

user = RealUser()
print("真实类型:", type(user).__name__)
print("篡改后的类名:", user.__class__.__name__)真实类型: RealUser
篡改后的类名: DisguisedAdmin
在这个场景中,如果一个权限校验系统仅仅依赖 user.__class__.__name__ 来确认角色,就会发生权限提升漏洞。此时只有 type(user).__name__ 能提供真实可信的物理类名。
四、多场景对比矩阵与差异全景
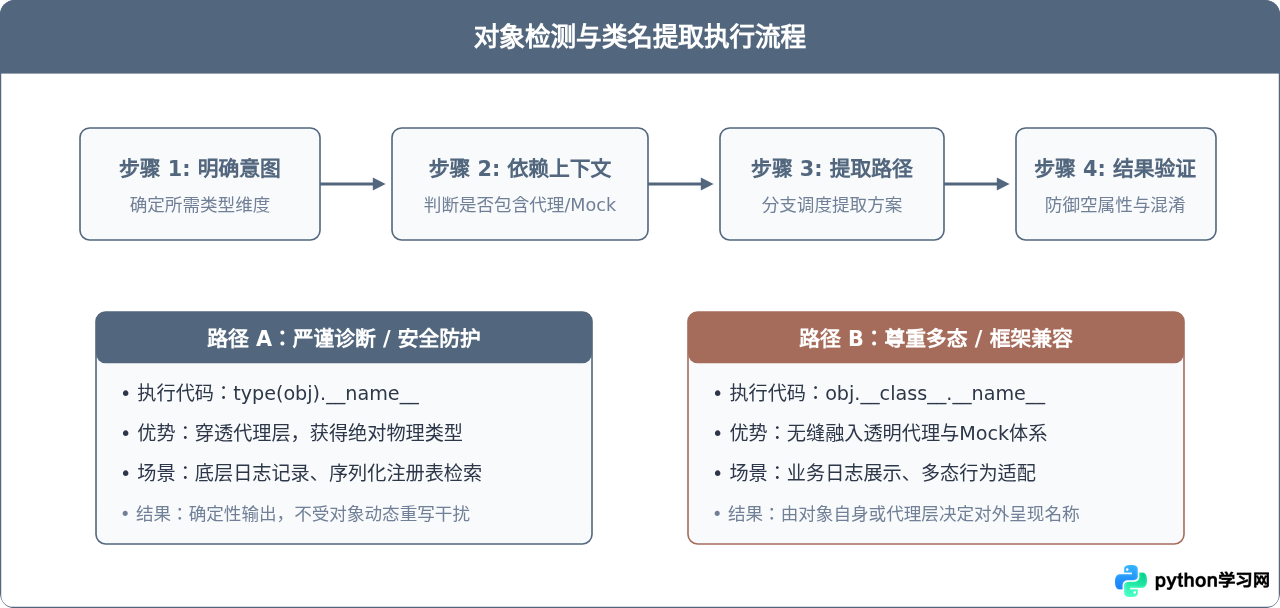
为了在工程开发中快速查阅与排查,下表汇总了常见对象形态在这两种调用下的具体表现:
| 测试对象形态 | type(obj).__name__ 返回 | obj.__class__.__name__ 返回 | 行为一致性 |
|---|---|---|---|
| 常规类实例 | 定义类类名(如 User) |
定义类类名(如 User) |
完全一致 |
| Python内置类型实例 | 内置类型名(如 int) |
内置类型名(如 int) |
完全一致 |
| weakref.proxy 弱引用代理 | PyWeakProxy |
被代理的目标类名 | 产生分歧 |
| unittest.mock.MagicMock(spec=X) | MagicMock |
Spec绑定的目标类名 | 产生分歧 |
| 重写了 __class__ 属性的实例 | 真实定义的底层类名 | 自定义返回的伪造类名 | 产生分歧 |
| 动态类型分配(obj.__class__ = NewCls) | NewCls |
NewCls |
完全一致(物理指针被变动) |
obj.__class__ = NewCls)是一个特殊的Python特性。当直接对实例的 __class__ 赋值时,CPython在底层会执行实质性的指针变更(修改 ob_type),只要新的类在内存布局(Layout)上与原类兼容。在此之后,type(obj) 与 obj.__class__ 都会指向新类,因为这已经修改了对象的物理类型,而不是单纯拦截了属性访问。
五、生产环境中的选型指南与防坑原则
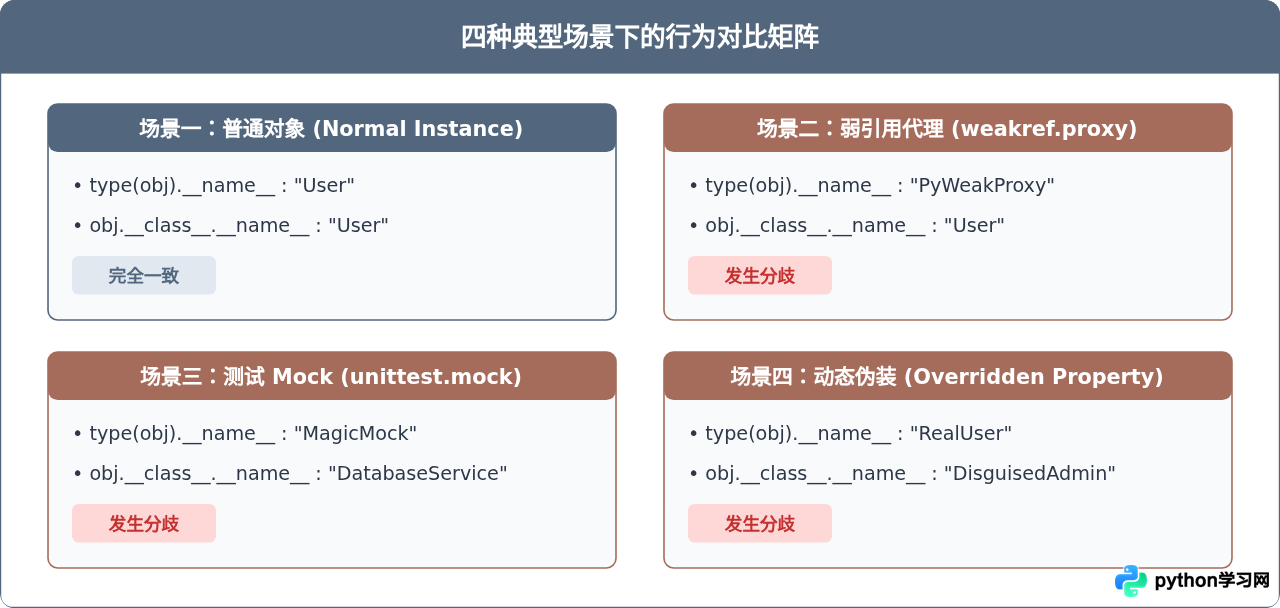
面对这两种写法,我们应该在什么场合使用哪一种?这里给出明确的选型规则:
1. 选用 type(obj).__name__ 的场景
- 系统底层调试与诊断日志:当程序抛出异常、崩溃或进行核心数据链路追踪时,我们需要知道对象在内存中的真实形态,而不是它声称的身份。
type(obj)可以准确指出当前变量是一个weakproxy、MagicMock还是封装容器。 - 序列化与反序列化分发器:在编写基于类型的序列化工具(如将对象映射到对应处理器)时,通常需要精确匹配对象的真实类型。如果使用
__class__,可能会将包装器误判为业务数据,导致反序列化结构崩溃。 - 防御性编程与安全边界:在权限校验、沙箱隔离等对安全性要求严苛的区域,绝不能相信对象通过属性暴露出来的
__class__,必须使用type()获取真实元信息。
2. 选用 obj.__class__.__name__ 的场景
- 业务层多态日志与用户提示:当你在高层业务代码中打印日志,希望呈现给上层调用者的是业务领域的对象名称,而不在乎它是否被ORM透明代理拦截时,使用
obj.__class__.__name__可以保持多态的一致性。 - 编写透明包装器与框架代码:如果你的类是一个包装器(Wrapper)或装饰器模式的实现,你需要尊重被包装对象所暴露的接口规范,此时顺应
__class__的协议是符合框架规范的做法。
3. 绝不应该使用两者的反模式
最严重的常见错误是使用类名字符串或 type() 来做类型校验分支:
# 严重反模式 1:基于字符串类名判断
if type(obj).__name__ == "SqlRepository":
    ...

# 严重反模式 2:使用 type 直接比对,破坏继承多态
if type(obj) is BaseService:
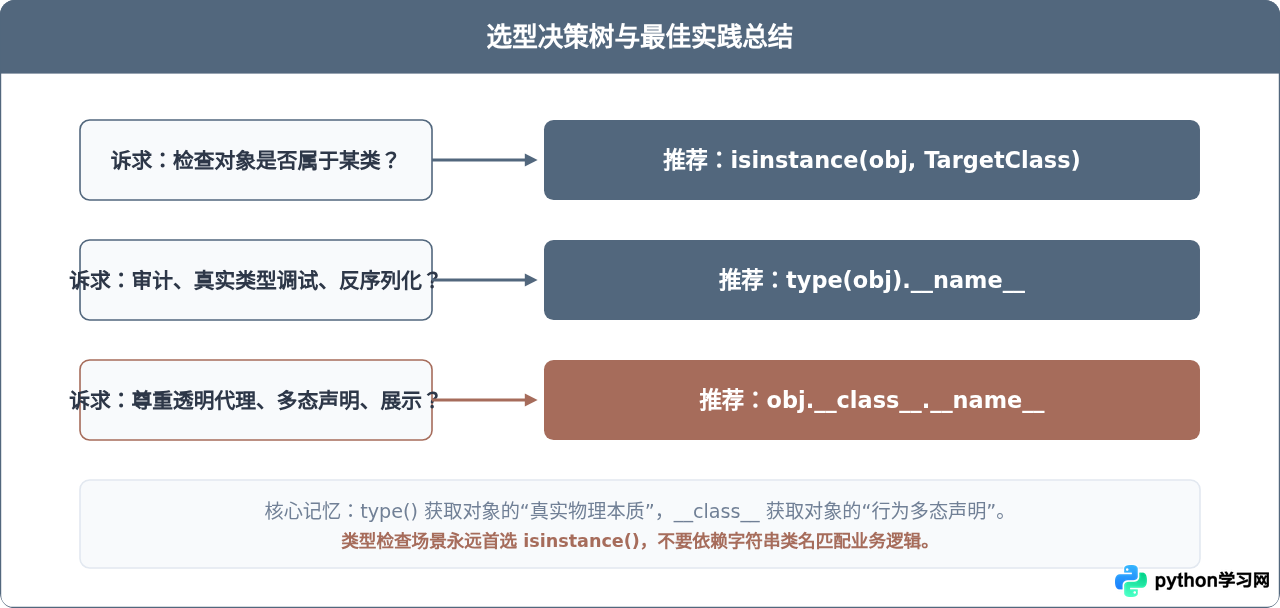
...这种写法的危害极大:首先,字符串判断没有任何重构安全保证,类名一旦重命名就会导致逻辑静默失效;其次,type(obj) is BaseService 彻底摧毁了面向对象的继承机制——任何 BaseService 的子类实例都会在该条件判断中返回 False。在绝大多数需要进行类型判定的场景下,始终应该优先使用内置的 isinstance(obj, Cls) 函数,它不仅能够优雅地处理子类继承,而且深度兼容抽象基类(ABC)和虚拟子类协议。
六、总结
掌握 type(obj).__name__ 与 obj.__class__.__name__ 的区别,是理解Python对象模型与属性解析机制的一个典型切入点。简要总结:
- 对于常规对象,二者无功能差异;
type(obj)走C层指针,直击本质,不可伪造,适合底层诊断、排障、序列化;obj.__class__走属性查找,顺应多态,可被代理拦截,适合透明代理、测试Mock与高层呈现;- 进行类型校验时,严禁使用类名字符串比较,应当使用
isinstance()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









