

Python pandas与openpyxl获取Excel行数的区别与选择
深入对比Python中使用pandas与openpyxl获取Excel工作表行数的底层机制、统计口径区别、空行与格式干扰陷阱以及内存性能差异,提供场景化选择指南与避坑建议。
在 Python 中处理 Excel 文件时,获取表格的“行数”是一项极高频的基础操作,但许多开发者经常会发现:使用 pandas 算出的行数往往和 openpyxl 的 max_row 不一致,有时甚至相差成百上千行。这一现象的根源在于两者对“行数”的定义边界不同、底层解析机制不同,以及对空行与格式单元格的处理方式不同。本文将详细拆解 pandas 与 openpyxl 在获取行数时的核心差异,剖析幽灵空行的产生机理,并提供场景化的选型依据与实用代码。
一、核心结论:两者统计行数的本质差异
简单来说,两个库获取行数的分歧主要集中在以下三个关键维度:
- 统计对象不同:
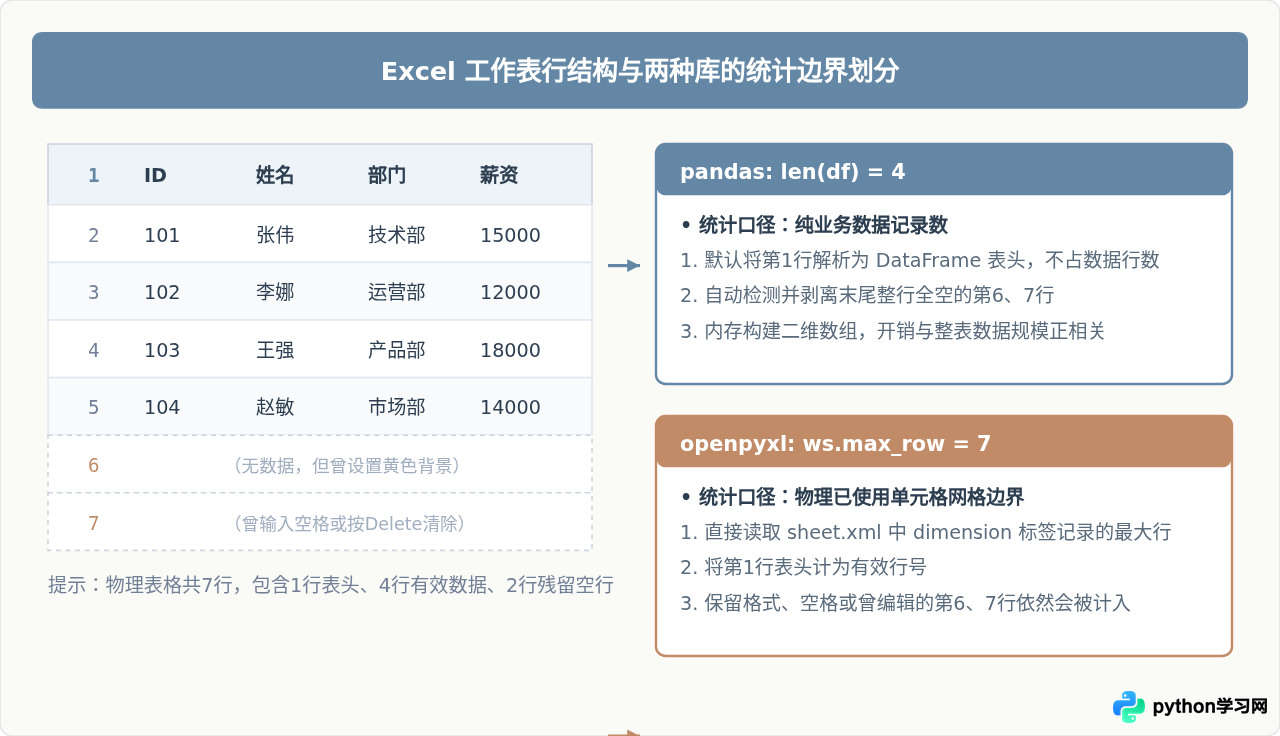
pandas统计的是“有效数据记录数”,默认自动剥离首行作为列索引(表头),且自动忽略文件末尾连续的全空行;而openpyxl的max_row统计的是“已使用网格的最大行号”,直接包含表头行,并将任何带有边框、底色或曾编辑过内容的单元格视为已占用行。 - 解析机制不同:
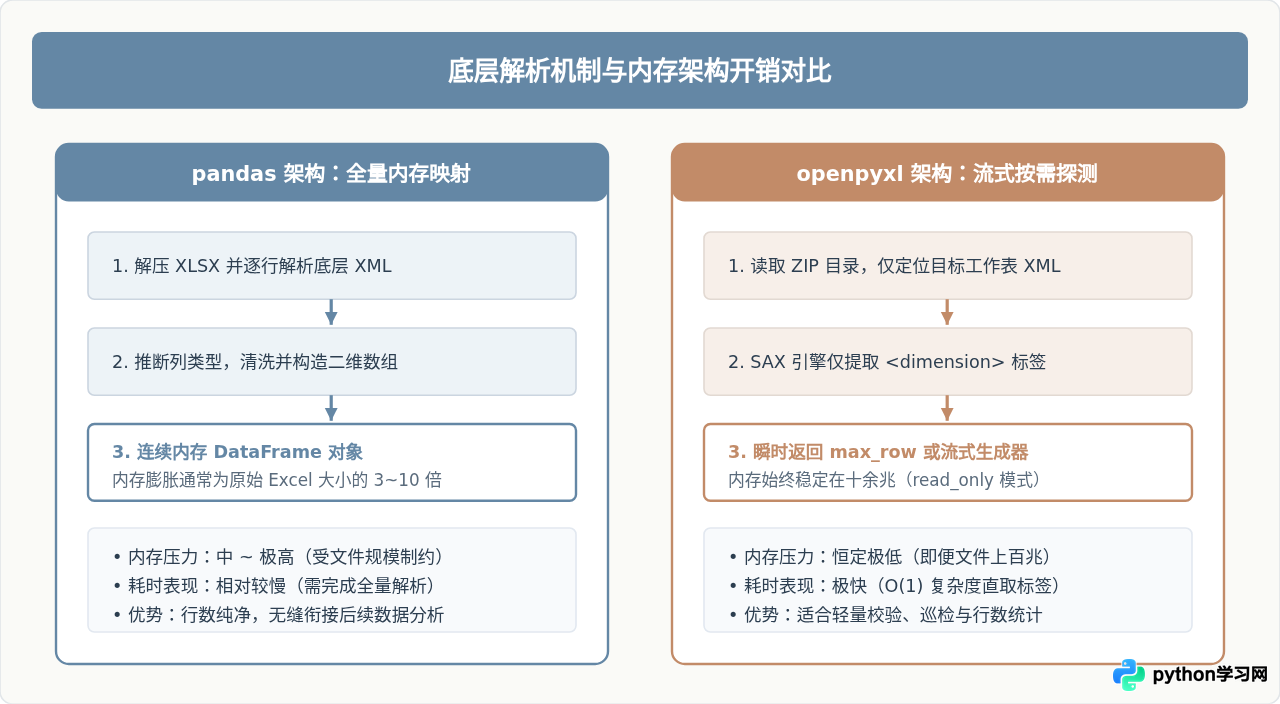
pandas读取时需要解压整个 xlsx 压缩包并将工作表全量加载进内存,构建连续的二维 DataFrame 结构;openpyxl的max_row则直接从内部 XML 文件的<dimension>标签中读取元数据,无需遍历所有单元格即可瞬时返回。 - 开销与速度不同:面对几十兆以上的大型 Excel 文件,
pandas消耗高昂的内存与解析时间,而openpyxl在read_only=True模式下内存占用极小。
二、使用 pandas 获取行数的实现细节与规则
在使用 pandas 读取 Excel 时,通常通过 pd.read_excel() 函数载入数据,随后使用 len(df) 或 df.shape[0] 获取行数。
import pandas as pd

# 读取默认第一张工作表
df = pd.read_excel("sales_data.xlsx")

# 获取数据行数
row_count = len(df)
# 或者
row_count_shape = df.shape[0]

print(f"数据行数: {row_count}")
1. 表头参数 header 的关键影响
pd.read_excel 默认参数为 header=0,即默认把 Excel 的第一行当作字段名(列名)。因此:
- 如果你的 Excel 第一行是列名,
len(df)返回的是“纯数据行数”(对应 Excel 中的第 2 行到最后一行)。 - 如果表格没有列名,第一行就是实际数据,若仍使用默认参数,第一行数据会被吞噬成列名,导致统计出的行数比实际少 1。此时必须显式指定
header=None:
# 表格无表头时的规范写法
df_no_header = pd.read_excel("sales_data.xlsx", header=None)
print(f"无表头真实行数: {len(df_no_header)}")
2. 末尾空行的智能剥离机制
用户在 Excel 中编辑时,经常会在数据底部残留一些只包含空格、单元格格式或曾输入后删除的空行。pandas 在读取时,会对每一行进行值解析。如果末尾的几行所有单元格全为 NaN(空值),pandas 在构造 DataFrame 时会默认将这些完全空白的末尾行抛弃,从而保护了数据行计数的准确性。
注意:如果表格中间存在整行全空的数据,pandas 默认会保留这些空行(填充为 NaN)以保证行索引对应关系。只有在调用 df.dropna(how='all') 时,才会将中间的空行彻底剔除。
三、使用 openpyxl 获取行数的实现与“幽灵空行”陷阱
openpyxl 是 Python 操作 Excel 底层 XML 的标准库。最常用的行数属性是 ws.max_row:
from openpyxl import load_workbook

wb = load_workbook("sales_data.xlsx", data_only=True)
ws = wb.active

print(f"工作表最大行号: {ws.max_row}")
1. max_row 的底层运作原理
Excel 的 .xlsx 文件实质上是一个使用 ZIP 规范压缩的文件包。解压后,每个工作表对应一个 sheet1.xml。在这个 XML 的头部,Excel 维护了一个维度节点,例如:
<dimension ref="A1:D1000"/>当 openpyxl 读取工作表时,ws.max_row 通常直接读取该维度定义中的最大行号(1000),而无需解析每个单元格的具体内容。这也是为什么读取 max_row 速度极快的原因。
2. 为什么 max_row 会虚高(幽灵空行)?
当用户在 Excel 中选中第 51 行到第 1000 行并按键盘上的 Delete 键时,单元格里的文字虽然被清空了,但单元格的样式、边框、对齐方式甚至空白字符依然留存在底层 XML 中。Excel 认为这些网格“已被使用”,维度标签依然记录为 A1:D1000。这时 ws.max_row 返回的就是 1000,而不是肉眼看到的 50。
3. 如何在 openpyxl 中准确获取有效数据行数
如果既要享受 openpyxl 的低内存优势,又想剔除末尾的残留空行,标准做法是从 max_row 开始逆向扫描,或者在流式遍历时检测是否有实际内容:
from openpyxl import load_workbook

# 使用 read_only=True 保证超低内存占用
wb = load_workbook("sales_data.xlsx", read_only=True)
ws = wb.active

def get_actual_row_count(worksheet):
    # 逆向逐行扫描单元格内容
    for row_idx in range(worksheet.max_row, 0, -1):
        row_cells = worksheet[row_idx]
        # 判断当前行是否有任何非空单元格
        if any(cell.value is not None and str(cell.value).strip() != "" for cell in row_cells):
            return row_idx
    return 0

actual_rows = get_actual_row_count(ws)
print(f"剔除幽灵空行后的物理最大行: {actual_rows}")
wb.close()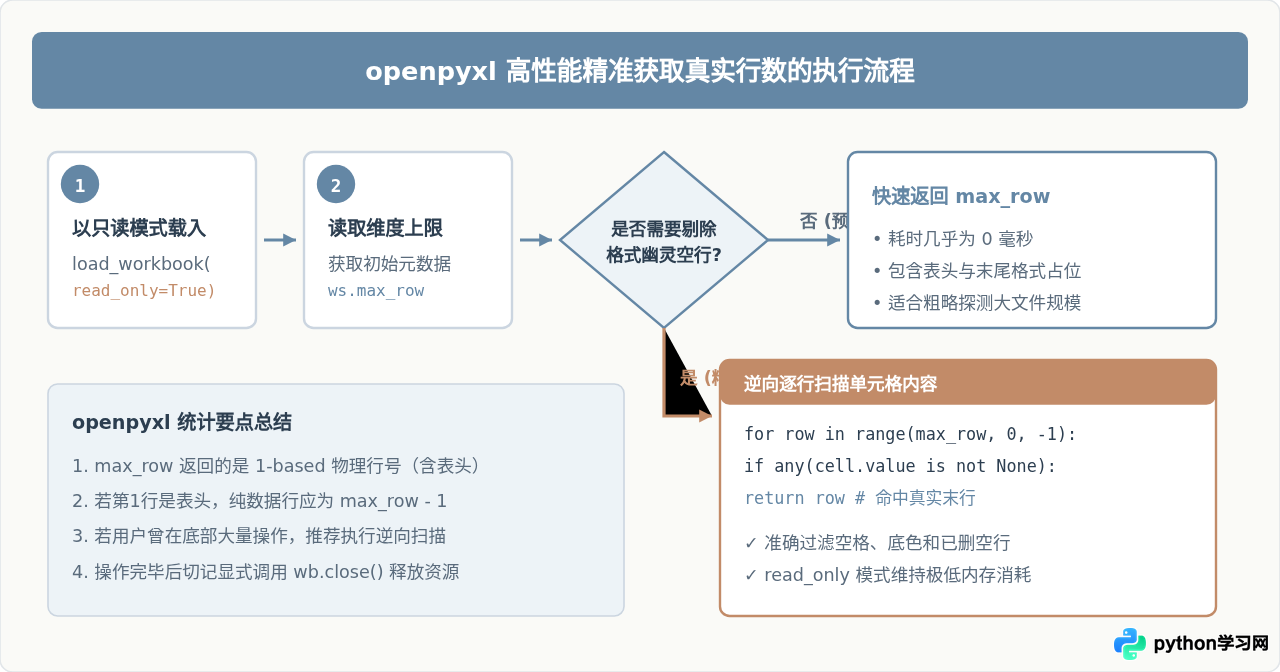
四、全方位对比:pandas vs openpyxl
为了在工程开发中做出最优的技术选择,以下从 7 个核心技术维度对两者进行系统化对比:
| 对比维度 | pandas (read_excel) | openpyxl (普通模式) | openpyxl (read_only=True) |
|---|---|---|---|
| 常用获取语句 | len(df) 或 df.shape[0] |
ws.max_row |
ws.max_row 或 迭代过滤 |
| 统计口径含义 | 实际数据记录条数 | 使用网格的最大行号 | 使用网格的最大行号 |
| 表头处理方式 | 默认当作列索引,不计入行数 | 计为第 1 行,包含在行数内 | 计为第 1 行,包含在行数内 |
| 末尾全空行过滤 | 自动丢弃末尾全空行 | 无法自动剔除(受格式干扰) | 无法自动剔除(需配合代码检测) |
| 内存资源占用 | 高(解压并构建完整二维对象) | 较高(DOM树模式存储所有单元格) | 极低(流式 SAX 解析,内存恒定) |
| 执行时间开销 | 较慢(数据量大时耗时明显) | 极快(直接读元数据标签) | 极快(毫秒级获取初始边界) |
| 后续数据操作 | 极佳(清洗、透视、过滤、聚合) | 适合精细单元格读写与样式调整 | 仅支持单向只读流式遍历 |
五、工程实践中的技术选型决策树
面对具体的业务需求,如何科学选择获取行数的方案?读者可以根据以下决策逻辑进行快速匹配:
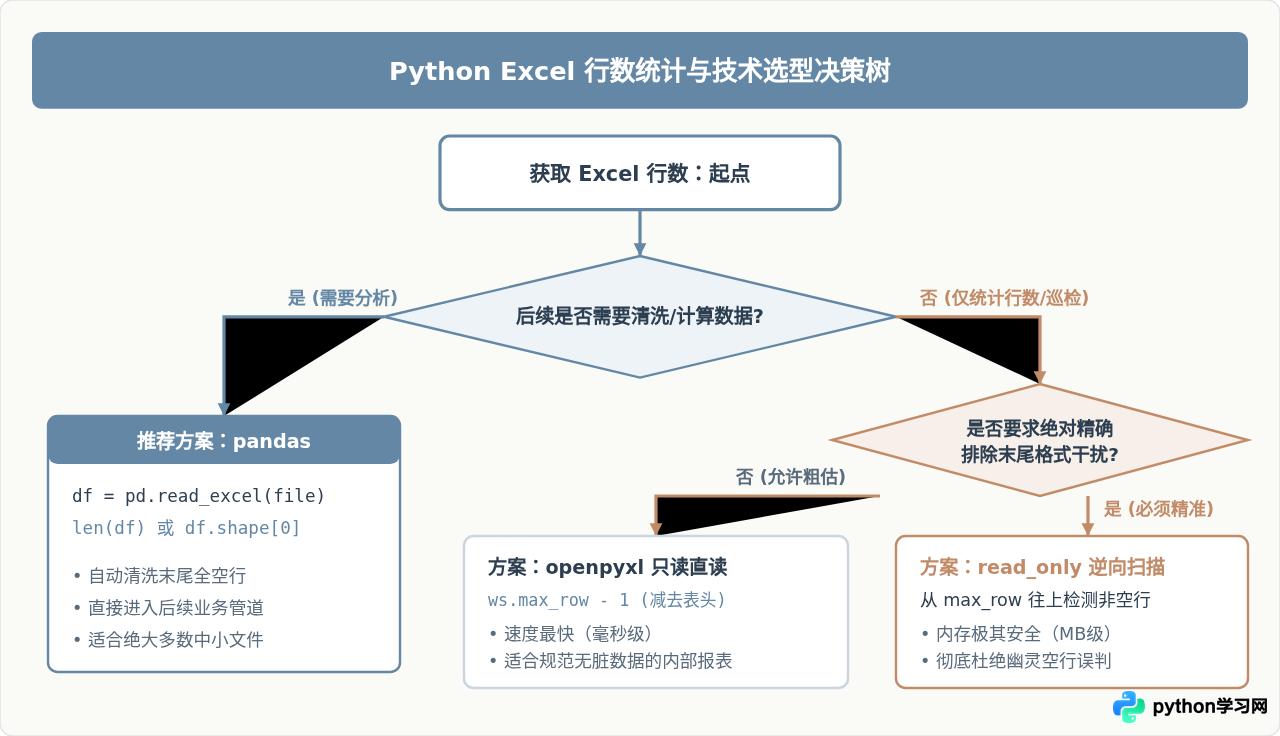
六、高频常见问题与注意事项
1. 为什么用 pandas 算出的行数正好比 Excel 底部的行号少 1?
这是最常见的新手疑问。Excel 界面左侧显示的行号是从 1 开始的,包含第 1 行的列名。而 pandas 默认会将第 1 行直接提拔为 DataFrame 的列名(columns),不计入数据行的行数(index 从 0 开始)。因此只要首行是列名,len(df) 必定比 Excel 最大有效数据行号少 1,这是正常且符合数据分析规范的逻辑。
2. 在超大 Excel 文件中,为什么不推荐直接用 openpyxl 普通模式?
当执行 load_workbook(filename) 且未指定 read_only=True 时,openpyxl 会在内存中为每一个单元格创建完整的 Python 对象(包括字体、边框、填充、数字格式等)。一个 30MB 的 Excel 文件完全载入后,可能瞬间吃掉 1GB 以上的物理内存,甚至触发服务器 OOM 崩溃。如果只是获取行数,务必加上 read_only=True。
3. 合并单元格对行数统计有什么影响?
在含有合并单元格的表格中:
- pandas:仅在合并区域的左上角单元格保留原值,其余合并位置填充为
NaN。如果最后几行全被合并,需注意不要误被当成空行过滤掉。 - openpyxl:合并单元格仍占据底层的行列网格范围,
max_row会正确覆盖合并区域的底沿。但在read_only=True模式下无法访问ws.merged_cells属性。
4. 公式返回空字符串 "" 是否会被判为空行?
在 Excel 中,如果某些单元格设置了类似于 =IF(A2="","",B2) 的公式,当条件不满足时单元格显示为空。在 openpyxl 普通模式下,其 cell.value 为公式字符串本身;在 data_only=True 模式下,其返回值为 None 或空字符串 ""。在编写逆向扫描检测代码时,必须同时兼顾 cell.value is not None 以及 str(cell.value).strip() != "" 两种情况,才能确保判定完全准确。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









