

Poetry对比pip:Python项目中哪种工具更擅长自动处理包版本兼容
深入对比Poetry与pip在Python项目中的依赖解析机制、版本冲突处理能力、锁文件与环境一致性保障,解析哪种工具更擅长自动处理包版本兼容。
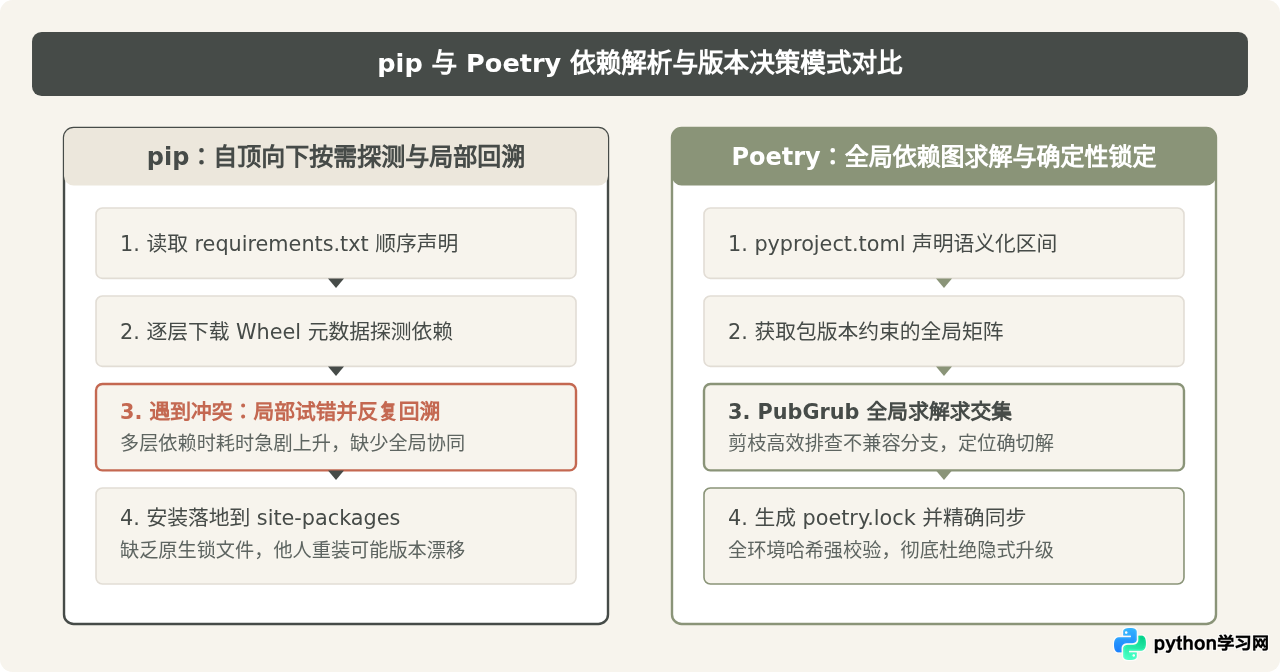
在面对复杂的依赖网络和潜在的版本冲突时,Poetry 在自动处理包版本兼容方面明显优于 pip。Poetry 内置了基于 PubGrub 算法变种的全局依赖图解析器,在真正安装任何文件前会对所有直接依赖和多层传递依赖构建完整数学模型,穷举寻找满足全部约束的唯一交集,并生成确定性的 poetry.lock 文件;而标准 pip 虽在 20.3 版本后引入了依赖回溯解析器,但在工作方式上仍偏向线性试错与按需下载 wheel 包,缺乏原生的强锁定清单与多依赖全局协同机制,容易在多层传递依赖冲突时陷入漫长回溯或环境不一致。
一、解析核心机制:pip 与 Poetry 如何推导兼容版本
判断哪种工具更擅长版本兼容,首先要看它们在遇到“依赖的依赖”时如何计算最终版本。
在传统的 Python 工作流中,pip 主要配合 requirements.txt 使用。执行 pip install 时,解析器会依次检索目标包及其元数据。尽管新版 pip 支持回溯检查,但它的解析逻辑依然是“自顶向下、按需探测”:它先下载当前候选包的元数据,如果发现某个深层依赖版本与已选中的包冲突,再触发回溯卸载或换版本重试。这种机制在依赖项较少时足够快,但随着依赖树深度增加,pip 需要反复向 PyPI 发起网络请求获取候选包元信息,解析时间呈非线性增长。
与之相对,Poetry 采用声明式规范。所有直接依赖及其版本容差均记录在 pyproject.toml 中。当运行 poetry add 或 poetry lock 时,Poetry 会启动专用求解器(Solver),将所有直接声明与各依赖包在 PyPI 上声明的全部历史版本约束汇总为一个全局布尔可满足性(SAT/PubGrub)问题。求解器在纯内存计算中排查不兼容分支,一次性推导出让全局所有包均满足要求的版本组合,最后把精确版本号与文件内容哈希写入 poetry.lock。
二、实战冲突辨析:当传递依赖出现“版本剪刀差”
在实际开发中,最常导致项目崩溃的并非直接引用的两个包名字相同,而是两个直接依赖间接引用了同一个底层包的不同版本。例如:
- 业务引入组件 A(例如
requests某扩展),组件 A 限制底层库urllib3 >= 1.26.0, < 2.0.0。 - 业务同时引入组件 B(例如云厂商最新 SDK),组件 B 要求
urllib3 >= 2.0.0。
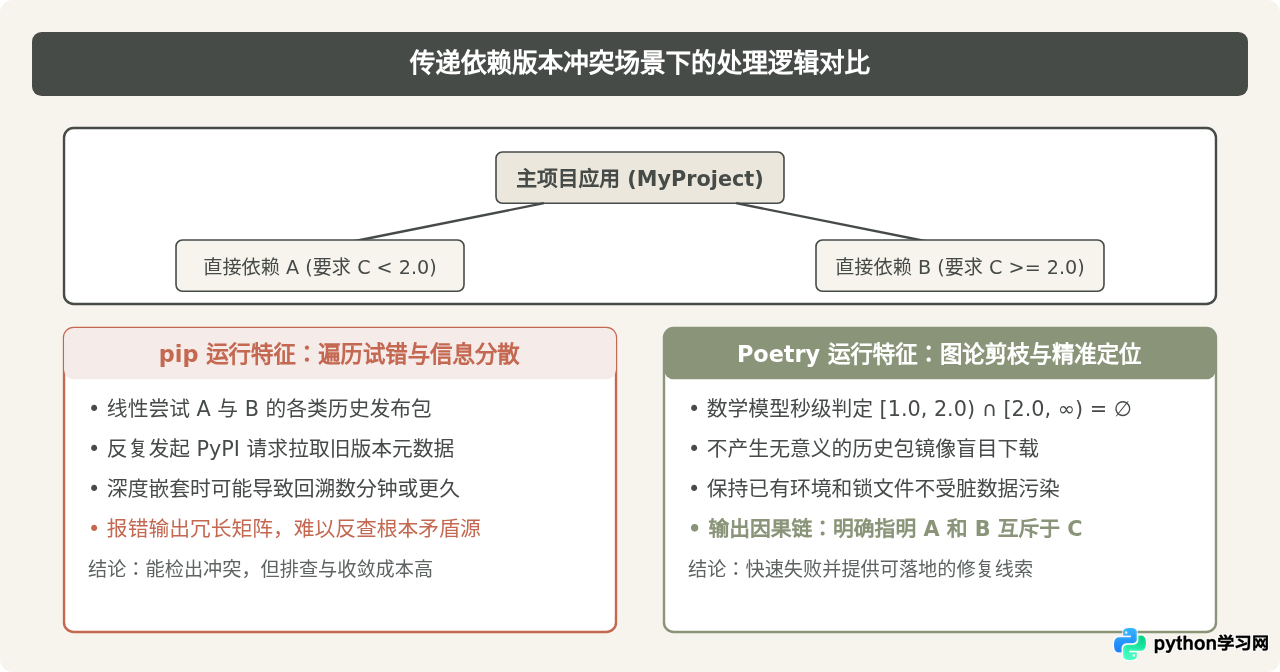
此时,底层库 urllib3 的版本区间没有任何交集,这就是典型的传递依赖冲突(版本剪刀差)。两种工具在这一场景下的表现存在本质区别:
1. pip 的应对表现
如果直接执行 pip install A B,pip 的解析器会尝试查找组件 A 的其他可用发布版本,或者组件 B 的历史版本,试图寻找是否存在某个旧版本的 B 可以放宽对 urllib3 的要求。如果依赖包的发布历史非常繁多,终端会持续输出数十行甚至上百行的 INFO: pip is looking at multiple versions of ... to determine which version is compatible,长时间占用 CPU 与网络连接。如果最终无解,pip 会抛出冗长的 ResolutionImpossible 报错,通常直接列出上百行候选方案的排列组合,开发者很难一眼看出根本矛盾发生在哪个包上。
2. Poetry 的应对表现
当在项目中执行 poetry add B(假定 A 已存在)时,Poetry 的 PubGrub 算法会直接针对约束区间做布尔逻辑运算。因为求解器在内存中已经维护了依赖树的推导图,它能立刻察觉到 urllib3 的约束在 < 2.0.0 与 >= 2.0.0 之间互斥,并在秒级时间内停止无谓搜索。终端输出简练而明确:
Because package-a (1.2.0) depends on urllib3 (>=1.26.0,<2.0.0)
 and package-b (2.1.0) depends on urllib3 (>=2.0.0),
 package-a (1.2.0) is incompatible with package-b (2.1.0).
So, because my-project depends on both package-a (^1.2.0) and package-b (^2.1.0), version solving failed.
这种精准的错误调用链能够让开发者立刻明白是 A 和 B 在抢夺 urllib3 的控制权,从而迅速采取升级 A、降级 B 或寻找替代方案的措施,而不是在几十屏的回溯日志中逐行排查。
三、操作实践:使用 Poetry 自动化管理依赖与锁定的规范流程
理解了理论差异后,可以通过一套标准流程观察 Poetry 如何在实际工程中自动化处理版本约束并消除兼容隐患。
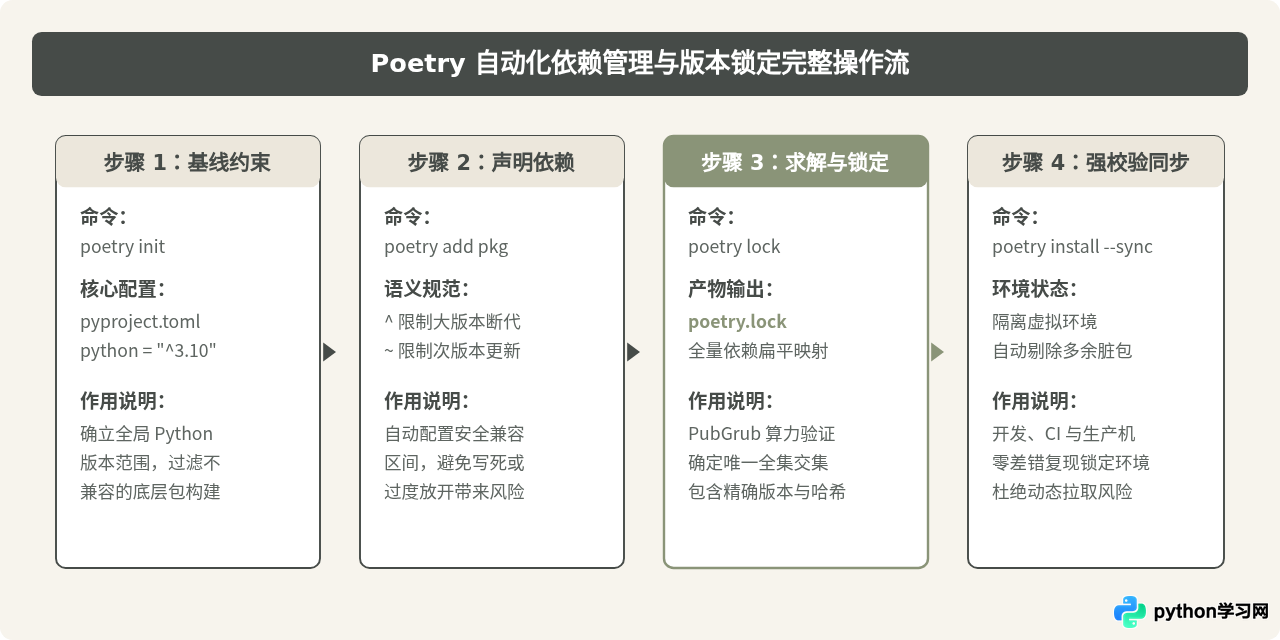
步骤一:项目初始化与 Python 环境约束
在项目根目录启动管理,生成遵循 PEP 518 规范的 pyproject.toml:
# 在空目录中交互式生成配置文件
poetry init --no-interaction --name="data-service" --python="^3.10"
此处的 python = "^3.10" 建立了项目的基线运行环境约束。Poetry 会在后续所有依赖解析中,严格过滤掉不支持 Python 3.10+ 的包版本,从底层切断因解释器版本不兼容引发的语法或二进制轮子缺失问题。
步骤二:添加依赖并自动推导语义化区间
使用 poetry add 添加目标依赖包:
# 添加 FastAPI 与 SQLAlchemy
poetry add fastapi "sqlalchemy>=2.0.0"
执行该命令时,Poetry 会自动查询 PyPI 的最新稳定版,并在 pyproject.toml 中写入符合语义化版本规范的符号(如 ^0.110.0)。符号 ^ 意味着允许向下兼容的次版本更新(例如允许升级到 0.110.1,但不允许跨越至破坏性更新 1.0.0)。这种机制从根源上防止了未来依赖包被盲目升级到不兼容的大版本。
步骤三:依赖图求解与 lock 文件固化
在所有依赖计算完毕后,Poetry 会生成 poetry.lock:
# 仅解析并更新锁文件,不修改当前环境已安装的包
poetry lock --no-update
poetry.lock 记录了完整的依赖拓扑图,每一个直接包及其全部多层间接包的具体版本号(如 pydantic == 2.6.4、anyio == 4.3.0)以及对应的 sha256 文件哈希值均被固定。团队中其他成员或 CI/CD 流水线检出代码后,不需要重新走一遍求解器,而是严格按照锁文件还原环境。
步骤四:环境强一致性同步
在测试或生产部署环境中,执行统一同步指令:
# 依据 poetry.lock 严格同步环境,清理不在清单内的无关包
poetry install --sync --no-root
参数 --sync 会确保本地虚拟环境的 site-packages 与 poetry.lock 达到比特级的一致;若之前手动用 pip 装过冲突的临时包,会被自动卸载,彻底杜绝隐式版本漂移。
四、常见认知误区与边界条件辨析
在探讨这两种工具时,开发者群体中常有一些看似合理但不够全面的说法,需要结合实际工程场景具体辨析:
辨析:这个说法在“生成固定版本文件”这一点上是成立的,但在工程协作和求解完整度上仍有差距。pip-compile(来自 pip-tools)确实能够通过扫描 requirements.in 生成带哈希锁定的 requirements.txt,这在一定程度上弥补了 pip 缺乏原生锁文件的短板。然而,pip-tools 依然建立在 pip 核心的安装与解析基础设施之上,缺乏 Poetry 原生的依赖分组管理(如 poetry install --only dev)、跨系统多环境协同求解以及与构建打包流程的紧密整合。此外,遇到深层互斥时,pip 的线性回溯仍然比 PubGrub 的布尔约束求解更易消耗大量等待时间。
辨析:很多开发者之所以觉得 pip “能装上”,是因为旧版 pip 或某些宽松参数下并没有对传递依赖做严格强校验,或者是直接覆盖了先前安装的某个包版本。这种“强行装上”往往把潜在的版本冲突推迟到了运行时——例如代码在调用某个函数时抛出 AttributeError 或 ImportError,这时调试代价远高于在安装期报错。Poetry 的严格报错并不是“兼容性差”,恰恰是它守住了包版本数学约束的底线,提前拦截了隐蔽的运行时崩溃风险。
辨析:并不绝对。Poetry 的严格求解需要所有上游依赖在 PyPI 上提供规范、标准的元数据(如符合 PEP 566/621)。在某些老旧的内部遗留系统中,如果引用的私有库存在未填写版本约束、打包脚本动态生成依赖(依赖 setup.py 动态执行)或严重错误的元数据声明,Poetry 的求解器可能会直接拒绝工作,甚至需要开发者手动编写复杂的 package.patch 规则。此时,使用原生 pip 的 --no-deps 手动安装或使用宽松的 pip install 往往是维护老旧系统的临时兜底手段。
五、选型依据与能力矩阵总结
为了让不同场景下的选型更加清晰明确,以下汇总了两种工具在核心工程维度上的综合能力差异:
| 对比维度 | 原生 pip (+ venv) | Poetry |
|---|---|---|
| 解析算法与架构 | 基于候选轮子的线性回溯解析,逐步按需试错 | 基于 PubGrub 的全局依赖图求解,内存剪枝计算 |
| 版本冲突诊断 | 输出大量候选排查日志,难以一眼定位根因 | 直接打印清晰互斥因果链,指明冲突包与区间 |
| 锁文件机制 | 无官方原生锁文件(多依赖手工维护 requirements.txt) | 原生强锁定文件 poetry.lock,包含完整哈希与图谱 |
| 语义化版本表达 | 需手动书写 >=、<=、~=,缺乏项目级默认推导 |
原生集成 ^、~ 等前沿语法,支持智能推荐区间 |
| 环境一致性与清理 | 只管安装,多余或历史遗留依赖需手动逐个 pip uninstall | poetry install --sync 自动清理非清单包,环境纯净 |
| 学习曲线与上手成本 | Python 自带,几乎零学习成本,随处可用 | 需理解 pyproject.toml、锁机制及命令行工作流 |
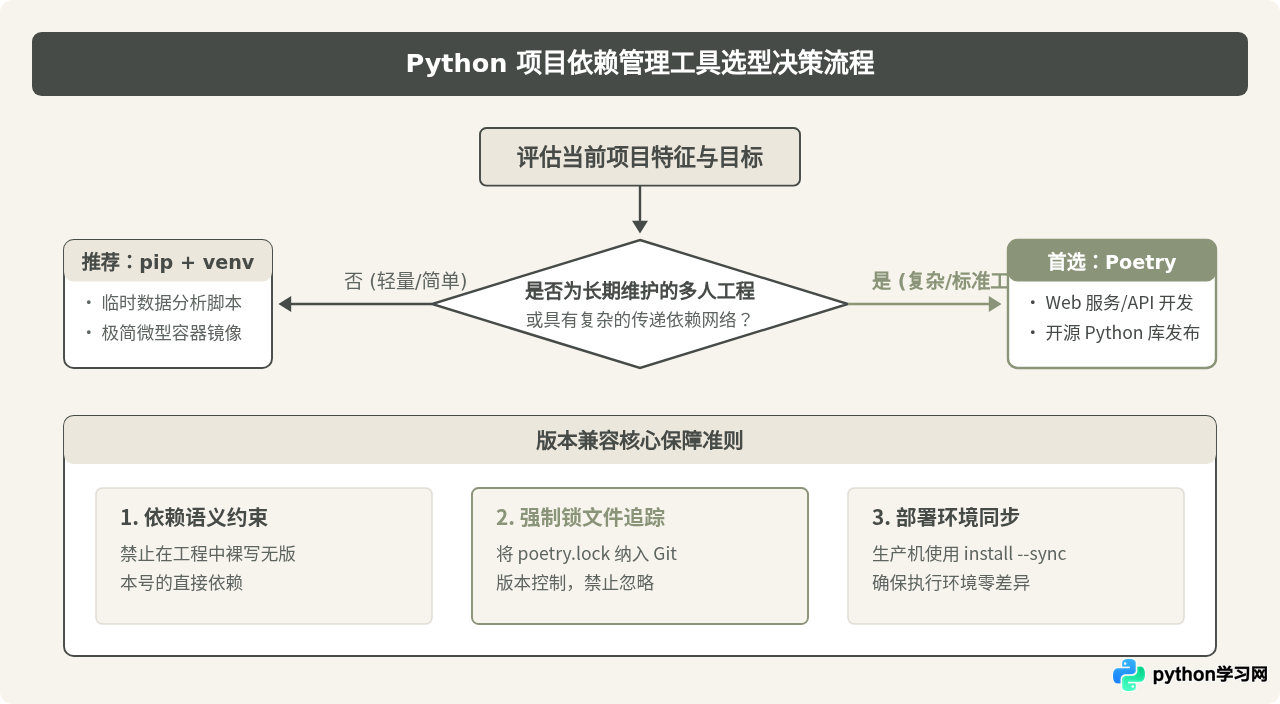
综上所述,当你的项目从“单文件轻量脚本”过渡到“多模块中大型工程”时,包与包之间的隐式传递依赖将呈网状交织。在此类场景下,Poetry 凭借其数学级的全局图论求解能力、确定性的锁文件架构以及清晰的冲突因果诊断,在自动处理包版本兼容问题上具备无可替代的优势;而 pip 则适合在轻量脚本、一次性数据实验或构建体积要求极苛刻的微型容器中继续发挥其简洁、轻装上阵的工具特性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









