

Python正则实战:从日志文件中批量提取关键信息
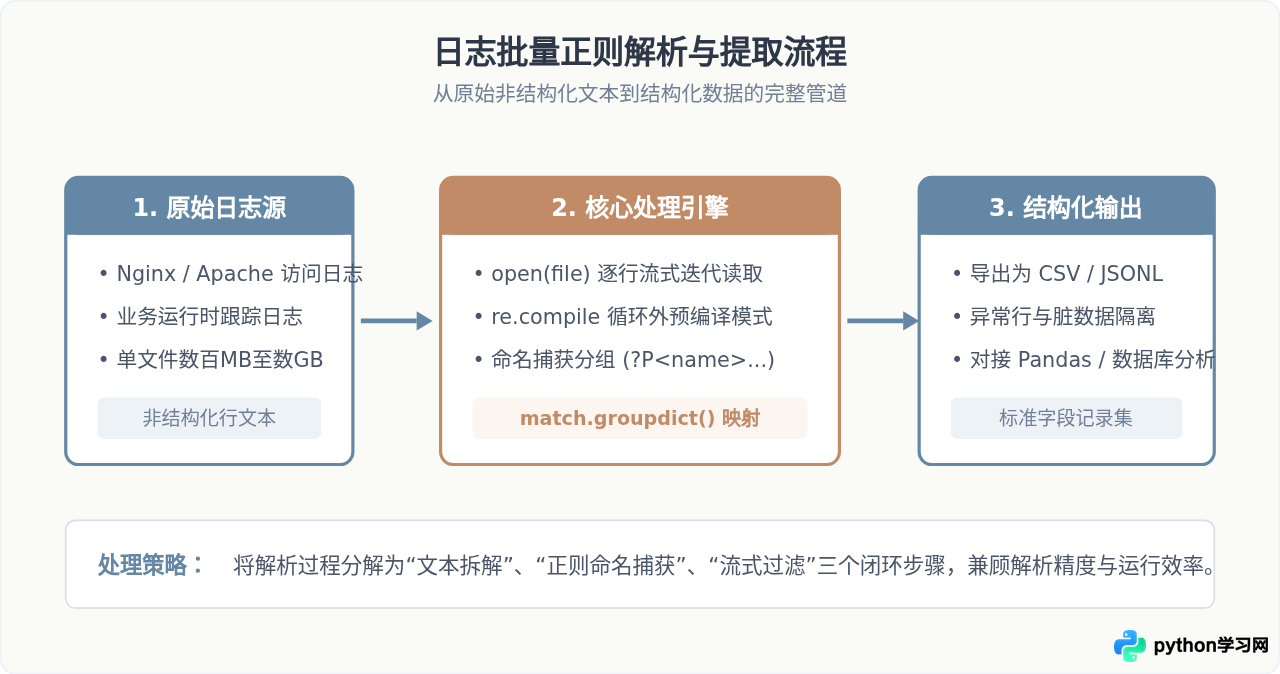
本文深入讲解如何使用Python标准库re模块结合逐行流式读取,从非结构化日志文件中批量提取IP、时间戳、请求路径、状态码等关键字段,包含预编译正则、命名捕获分组、内存保护与异常处理实战方案。
re模块结合逐行流式生成器,通过预编译正则表达式与命名捕获分组,以极低的内存开销实现百万级日志行的结构化转换与导出。
一、剖析日志结构与构建精准正则表达式
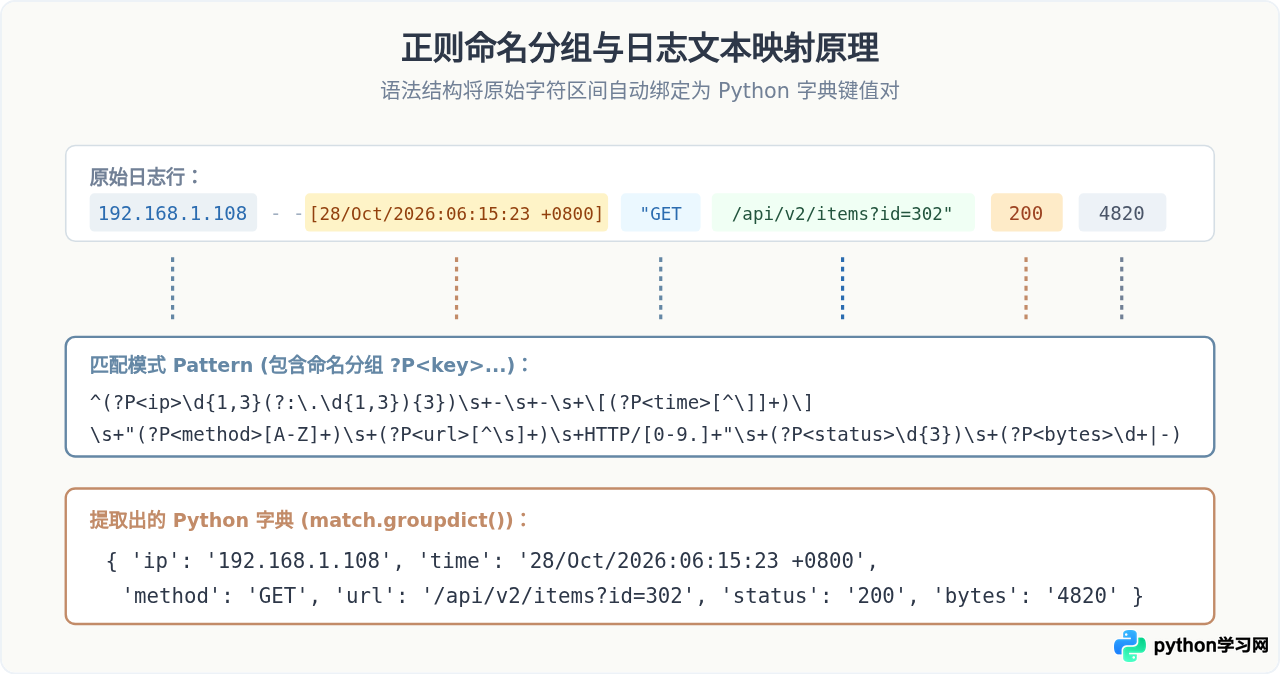
编写高效率正则表达式的前提是明确日志行的格式规范。以互联网服务中最为典型的 Nginx Combined 访问日志为例,其单行格式通常如下:
如果使用普通的捕获分组(例如连续使用小括号 (.*)),在提取结果时只能通过数字索引 match.group(1)、match.group(2) 获取字段。当字段超过5个时,索引极易错位且可读性差。最佳实践是使用命名捕获分组 (?P<name>pattern),直接将匹配结果绑定至字段名。
我们将日志行拆解为以下几个核心字段及其对应的正则规则:
- 客户端IP (ip):
(?P<ip>\d{1,3}(?:\.\d{1,3}){3}),匹配4段由点分隔的数字。 - 访问时间 (time):
\[(?P<time>[^\]]+)\],匹配方括号包裹的全部字符。 - HTTP请求方法 (method):
"(?P<method>[A-Z]+),如 GET、POST 等大写动词。 - 请求路径 (url):
(?P<url>[^\s]+),匹配空格前的完整 URI。 - HTTP状态码 (status):
(?P<status>\d{3}),匹配精确3位数字。 - 响应字节数 (bytes):
(?P<bytes>\d+|-),匹配传输字节或中划线。
二、批量提取的完整代码实现
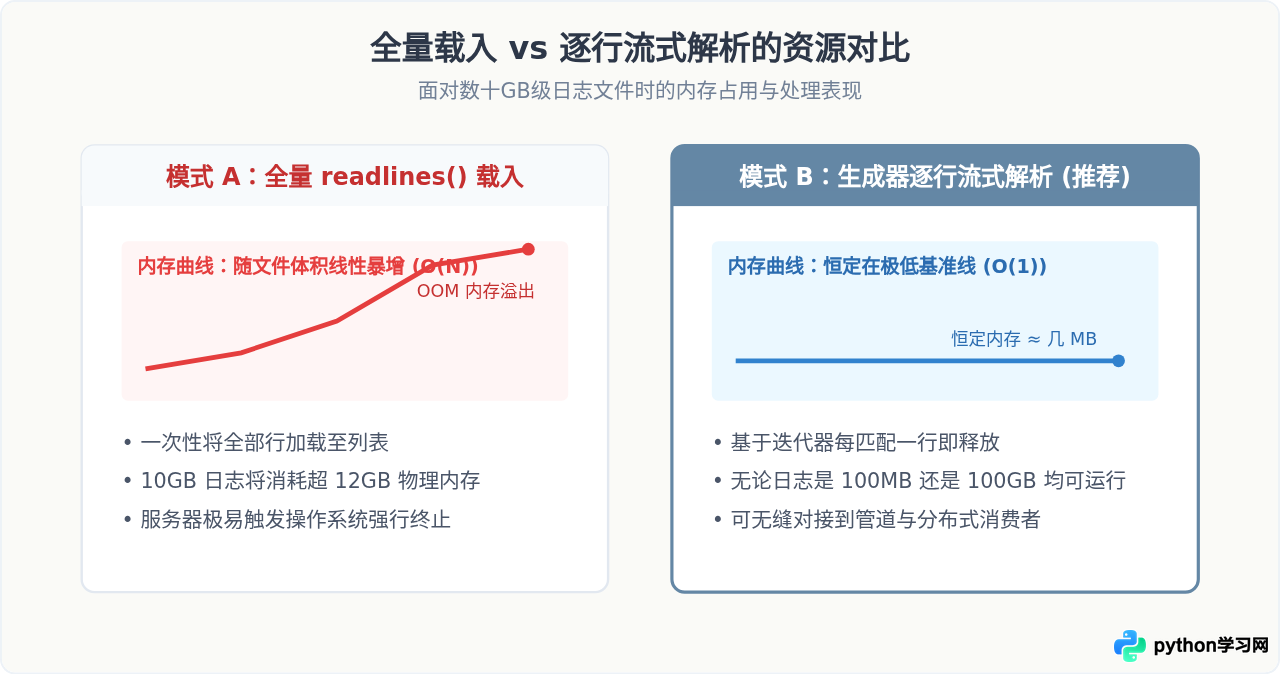
在处理大型日志文件时,有两个容易导致程序缓慢或崩溃的操作习惯:
- 在循环内反复调用
re.match()或re.search():每次调用都会重新分析和编译正则字符串。先使用re.compile()将其生成底层模式对象,可以在数万次循环中节省大量重复解析时间。 - 使用
f.readlines()或f.read()一次性装载:对于GB级以上的日志,一次性读取会瞬间吃满内存导致系统发生 OOM (Out of Memory) 崩溃。Python 的文件对象天然支持迭代器协议,for line in f:仅在迭代时按行读取,常驻内存仅有数KB。
以下是具备完整流式解析与 CSV 结构化导出功能的 Python 脚本:
import re
import csv
from typing import Generator, Dict, Any

# 1. 预编译正则表达式(包含命名捕获分组)
LOG_PATTERN = re.compile(
    r'^(?P<ip>\d{1,3}(?:\.\d{1,3}){3})'
    r'\s+-\s+-\s+'
    r'\[(?P<time>[^\]]+)\]'
    r'\s+"(?P<method>[A-Z]+)\s+(?P<url>[^\s]+)\s+HTTP/[0-9.]+"'
    r'\s+(?P<status>\d{3})'
    r'\s+(?P<bytes>\d+|-)'
)

def stream_parse_log(file_path: str) -> Generator[Dict[str, Any], None, None]:
    """
    流式逐行解析日志文件
    返回匹配成功的字段字典生成器
    """
    with open(file_path, mode='r', encoding='utf-8', errors='replace') as f:
        for line_num, line in enumerate(f, start=1):
            line_str = line.strip()
            if not line_str:
                continue

            match = LOG_PATTERN.match(line_str)
            if match:
                data = match.groupdict()
                # 针对具体字段做轻量类型转换
                data['status'] = int(data['status'])
                data['bytes'] = int(data['bytes']) if data['bytes'] != '-' else 0
                data['line_num'] = line_num
                yield data
            else:
                # 记录不匹配的脏数据行,用于后续完善正则或排查异常请求
                pass

def export_to_csv(log_path: str, output_csv_path: str) -> None:
    """批量解析日志并写入CSV"""
    fieldnames = ['line_num', 'ip', 'time', 'method', 'url', 'status', 'bytes']
    total_count = 0

    with open(output_csv_path, mode='w', encoding='utf-8', newline='') as out_f:
        writer = csv.DictWriter(out_f, fieldnames=fieldnames)
        writer.writeheader()

        for record in stream_parse_log(log_path):
            writer.writerow(record)
            total_count += 1

    print(f"提取完成:共成功结构化写入 {total_count} 条记录到 {output_csv_path}")

if __name__ == '__main__':
    # 示例执行入口
    export_to_csv("access.log", "parsed_access_log.csv")
在终端执行该脚本后的输出信息如下:
三、实战中容易遇到的陷阱与边界处理
在实际生产环境的日志提取过程中,简单直接的规则往往会因为脏数据或特殊请求字符产生漏匹配或性能剧烈衰减。以下是三项关键注意事项:
1. 警惕贪婪匹配引发的回溯与越界
在提取请求 URI 或 User-Agent 时,初学者常习惯写 .*。点号通配符加贪婪模式会一口气匹配到行末,随后在尝试满足后续双引号或状态码时发生大量回溯(Backtracking)。这不仅会导致提取性能急剧下降数倍,还可能将请求体中带有的空格错误吞掉。
.*。例如提取两端用引号闭合的内容时,使用 "[^"]*" 代替 ".*?";提取非空连续字符串使用 [^\s]+。这不仅能避免恶性回溯,还能在不匹配时瞬间短路失败。
2. 建立未匹配行的隔离收集机制
直接丢弃 match is None 的行会在后期数据汇总时造成统计数据对不上账(例如总PV少于原始日志行数)。实际工程中,建议在解析函数中添加计数与旁路记录:
- 维护一个专门的
unmatched.log文件,将正则未能捕获的行写入其中。 - 通过分析未命中行,通常能够发现特殊攻击注入请求(如超长畸形URI、包含特殊控制字符的请求行),或者版本迭代后新加的日志中间件字段。
3. 字符集编码与乱码宽容处理
系统日志中可能混杂不同客户端提交的二进制载荷、URL编码字符或损坏的 UTF-8 字节。在 open() 打开文件时,显式指定 errors='replace' 或 errors='ignore',防止脚本运行到第90万行时突然因为一个无法解码的字节触发 UnicodeDecodeError 中断整个批处理任务。
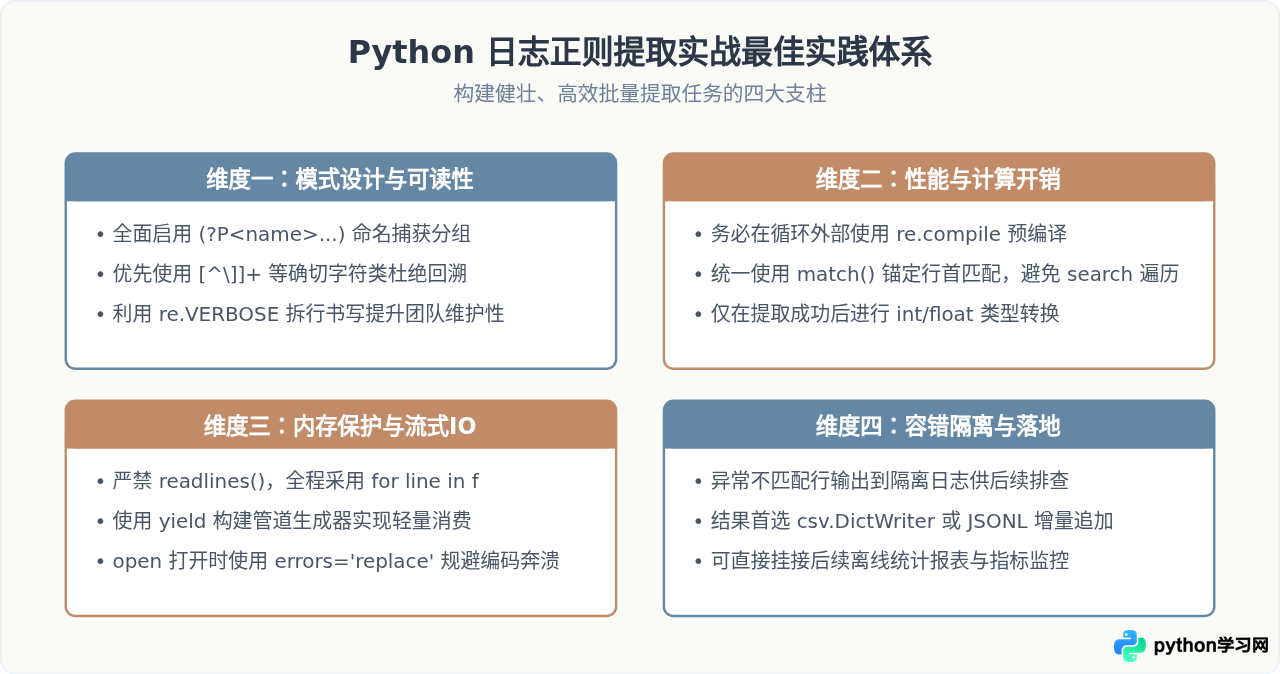
四、核心实战经验总结清单
总结本篇实践的核心策略,建议在设计任何批量日志解析任务时遵循以下四大工程原则:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









