

Python列表切片是浅拷贝吗?嵌套对象地址不变
深入剖析Python列表切片(如a[:])的浅拷贝机制。通过内存引用模型与代码示例,直观展示为何外层列表是新容器,而嵌套对象地址保持不变,以及如何正确使用深拷贝防范意外修改。
b = a[:] 或 a[1:3])是标准且纯粹的浅拷贝(Shallow Copy)。切片操作会开辟新的内存空间创建一个独立的外层列表容器,因此外层列表对象的地址发生变化(id(a) != id(b));但新列表中容纳的所有元素,仅仅是对原列表元素引用的逐个复制。如果列表中包含可变嵌套对象(例如子列表或字典),该嵌套对象的内存地址完全保持不变(id(a[i]) == id(b[i])),对嵌套对象的就地修改会同时波及原列表与切片列表。
一、Python列表切片的内存本质与引用机制
要透彻理解切片是否为浅拷贝,首先需要明确 Python 列表在内存中的存储形式。Python 的 list 本质上并不是一块连续存放真实数据对象的内存块,而是一个动态引用的指针数组。列表中存放的每一个元素,都是指向实际对象内存地址的指针(引用)。
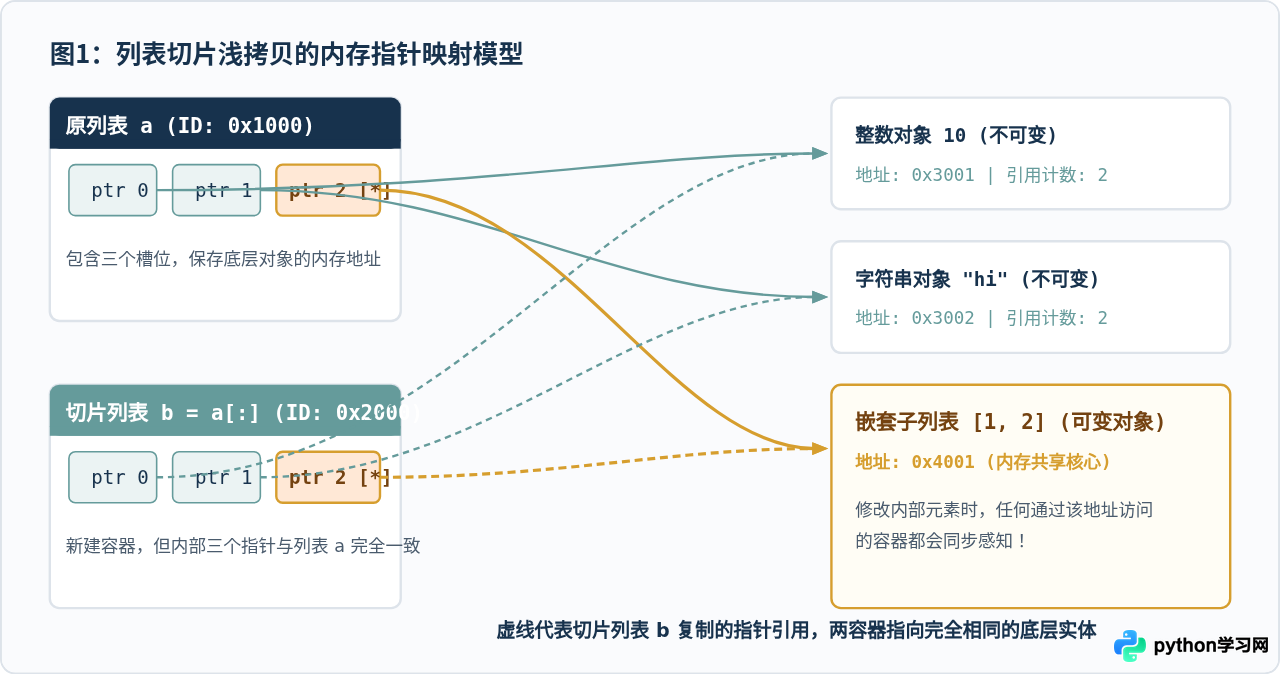
当执行 b = a[:] 这样的切片语句时,解释器内部执行了两个关键动作:
- 创建新容器:在堆内存中为变量
b分配一个新的list结构体,拥有独立的内存 ID。 - 复制引用指针:按切片区间顺序,将原列表
a对应槽位中保存的对象内存指针,原封不动地复制到b的对应槽位中。
因为仅仅复制了“指针”这一层外壳,并没有对指针指向的具体对象进行递归复制,所以在计算机体系中被称为浅拷贝。
二、代码实测验证:通过 id() 观察地址与突变行为
为了验证上述内存模型,我们可以在 Python 交互环境中使用内置函数 id() 进行求证。id() 返回对象在 CPython 中的内存绝对地址。
1. 验证外层容器与嵌套对象的内存地址
我们构造一个复合列表,包含基础类型和嵌套子列表:
# 构造包含基础数据和嵌套子列表的原列表
original = [10, "Python", [1, 2]]

# 执行全切片浅拷贝
sliced = original[:]

# 1. 对比外层列表的内存地址
print("原列表 ID:    ", id(original))
print("切片列表 ID:  ", id(sliced))
print("外层是否同对象:", original is sliced)

# 2. 对比各个索引处元素的内存地址
print("索引0(int)地址对比: ", id(original[0]) == id(sliced[0]))
print("索引1(str)地址对比: ", id(original[1]) == id(sliced[1]))
print("索引2(list)地址对比:", id(original[2]) == id(sliced[2]))
执行输出示例:
原列表 ID:     140455823848128
切片列表 ID:   140455823848512
外层是否同对象: False
索引0(int)地址对比:  True
索引1(str)地址对比:  True
索引2(list)地址对比: True
从输出可以清楚看到:original is sliced 为 False,证实切片确实产生了一个全新的外层容器。然而,子列表 original[2] 与 sliced[2] 的内存地址完全一致(True)。
2. 修改操作的差异:顶层重绑定 vs 嵌套就地修改
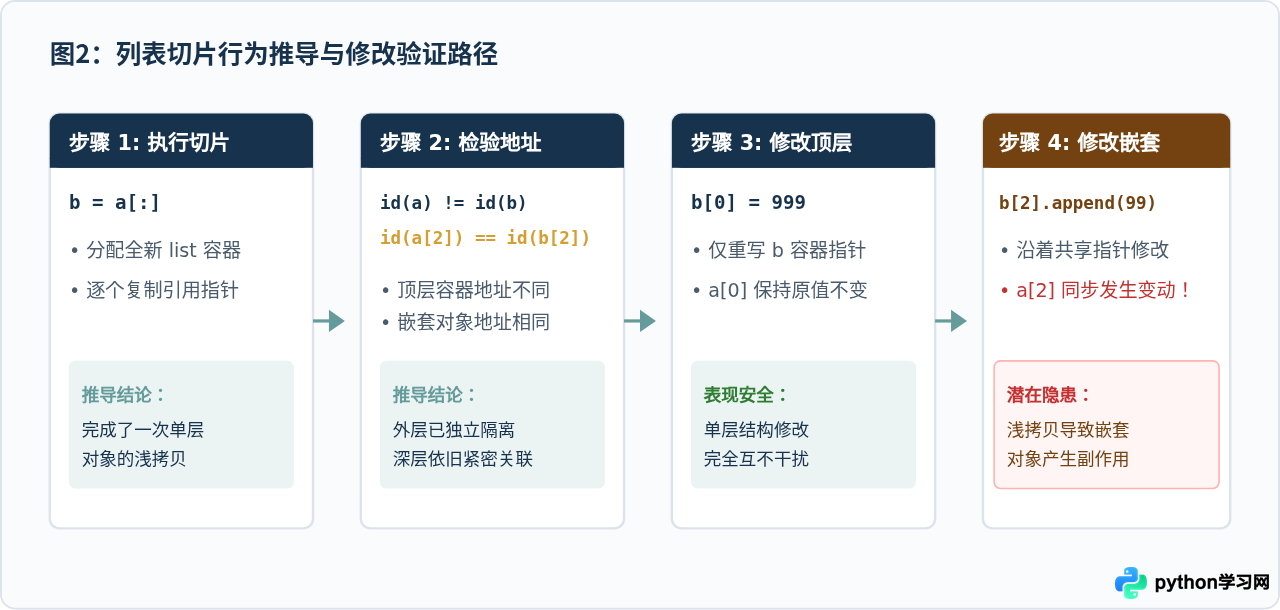
许多开发者在此处容易产生混淆:为什么有时候修改切片列表不会影响原列表,而有时候又会联动修改?核心差异在于执行的是顶层指针重新赋值还是对共享可变对象的就地变更(In-place mutation)。
# 场景 A:重新赋值切片的第 0 项(顶层指针替换)
sliced[0] = 999
print("原列表:", original)  # 输出: [10, 'Python', [1, 2]] -> 完全不受影响
print("切片列表:", sliced)  # 输出: [999, 'Python', [1, 2]]

# 场景 B:对嵌套子列表进行就地修改(向子列表中追加元素)
sliced[2].append(99)
print("原列表:", original)  # 输出: [10, 'Python', [1, 2, 99]] -> 原列表被连带修改!
print("切片列表:", sliced) # 输出: [999, 'Python', [1, 2, 99]]•
sliced[0] = 999 改变的是 sliced 容器第 0 格内的指针,将其指向新整数 999,原列表 original 第 0 格的指针未动。•
sliced[2].append(99) 则是顺着第 2 格的指针找到共享的子列表内存对象,并直接在该对象内部增加数据,因此原列表读取该对象时必然同步改变。
三、深浅拷贝机制对比:切片与 copy.deepcopy()
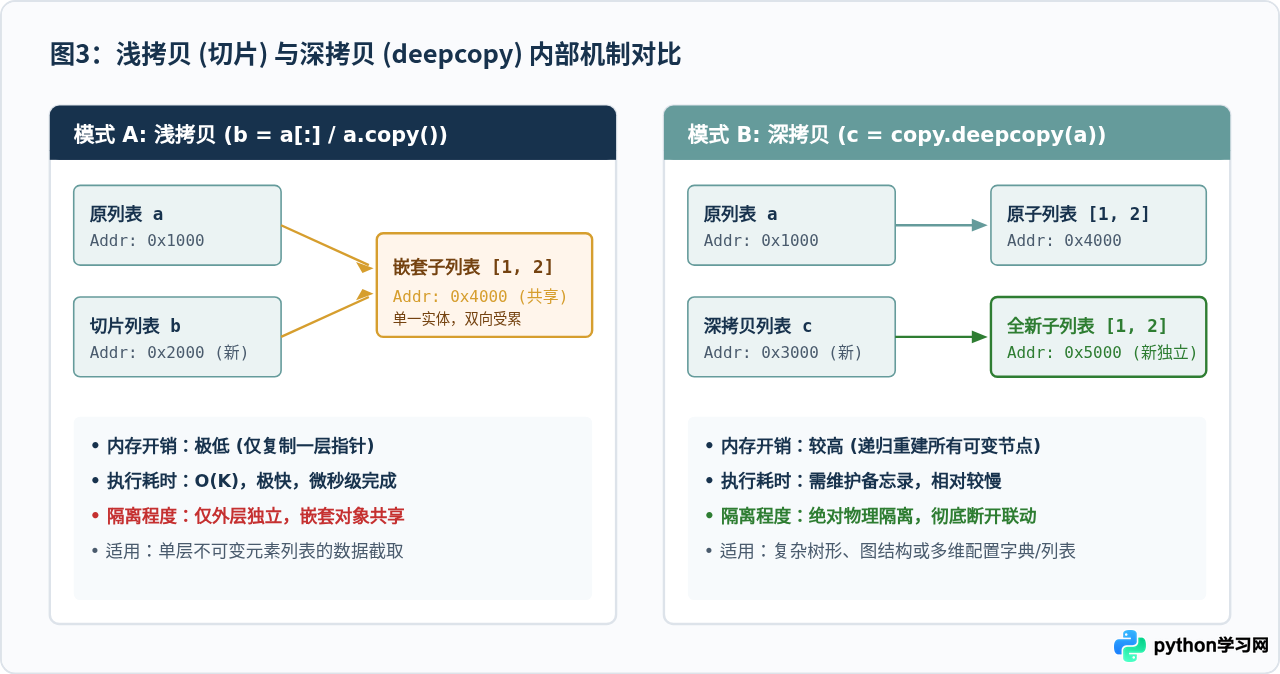
在实际开发中,除了全切片 a[:] 外,list(a)、a.copy() 以及 copy.copy(a) 产生的效果与切片完全等价,它们都属于浅拷贝。
如果你的数据结构中存在多层嵌套的可变对象(如嵌套列表、包含字典的列表),并且要求副本与原对象彻底隔离,必须使用标准库中的 copy.deepcopy()。
深拷贝的代码实现与地址对照
通过引入 copy.deepcopy(),可彻底斩断嵌套对象间的隐形链接:
import copy

original = [10, "Python", [1, 2]]
deep_cloned = copy.deepcopy(original)

# 打印对比嵌套子列表的地址
print("原嵌套子列表 ID:  ", id(original[2]))
print("深拷贝子列表 ID:  ", id(deep_cloned[2]))
print("嵌套对象是否同一: ", original[2] is deep_cloned[2])

# 对深拷贝对象的嵌套层做变更
deep_cloned[2].append(999)
print("原列表内容:      ", original)     # [10, 'Python', [1, 2]] -> 依然保持原样
print("深拷贝列表内容: ", deep_cloned) # [10, 'Python', [1, 2, 999]]输出结果明确证实:在深拷贝下,original[2] is deep_cloned[2] 已经为 False,二者拥有完全隔离的独立内存地址。
四、开发实践选型与避坑指南
了解切片是浅拷贝后,在实际编码中应如何做出恰当的选择?下表汇总了常见操作方式的特性与适用边界:
| 操作方式 | 拷贝类型 | 外层容器 ID | 嵌套可变对象 ID | 时间与内存开销 | 推荐使用场景 |
|---|---|---|---|---|---|
b = a |
无拷贝 (引用绑定) | 相同 (同一对象) | 相同 | 零开销 | 仅需要为现有对象创建别名时 |
b = a[:] 或 a.copy() |
浅拷贝 (Shallow) | 不同 (新开辟) | 相同 (地址不变) | O(K) 极低开销 | 平铺列表(元素全为不可变类型)的复制与分片 |
b = copy.deepcopy(a) |
深拷贝 (Deep) | 不同 (新开辟) | 不同 (递归新开辟) | 较高 (取决于嵌套深度与数量) | JSON数据模板、嵌套配置字典、复杂游戏状态快照 |
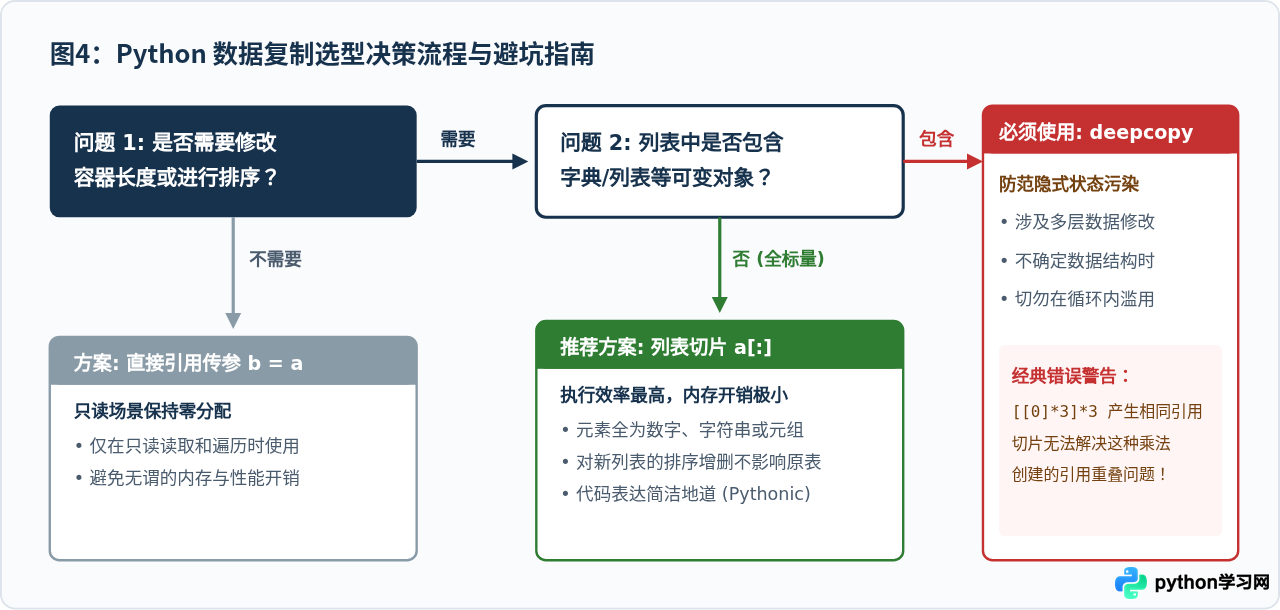
常见疑惑与注意事项解答
Q1:为什么切片操作不默认设计为深拷贝?
A:核心考量是执行性能与资源控制。在大多数应用场景中,开发者只需要切取列表的一段数据进行迭代或排序。如果每次切片都进行深度递归复制,对于大型嵌套列表(例如成千上万个对象构成的树或图结构),将导致巨大的 CPU 耗时与内存爆炸。浅拷贝以近乎即时(O(K))的开销为开发者提供了新容器,将深拷贝的决策权交给了明确有此需求的开发者。
Q2:二维列表推导式 [[0 for _ in range(3)] for _ in range(3)] 属于什么拷贝?
A:推导式在每一次循环迭代中都会通过 [0 for _ in range(3)] 新建一个子列表,因此外层和内层子列表全部是彼此独立的全新内存块。这与使用 [[0]*3]*3(外层三个槽位全部指向同一行子列表的严重错误写法)有本质区别,能从根本上避免浅拷贝引用的共享问题。
五、全文总结
回到标题提出的核心命题:Python 列表切片确凿无疑是浅拷贝。
- 外层独立:切片会新建一个列表容器对象,因此
a is a[:]永远为False。改变切片列表中顶层元素的指向、添加新元素或剔除元素,均不会对原列表的顶层结构产生副作用。 - 嵌套共享:切片只复制容器内部的指针,并不对深层对象做副本克隆。若列表中含有子列表、字典等可变复合对象,其内存绝对地址(
id())完全不变。对该嵌套对象内部的修改,依然会“穿透”并反映在原列表上。
在日常开发中,处理扁平数据结构可放心使用优雅高效的切片语法;而在面对多维数据、树形结构或需要确保内部状态绝对安全的业务逻辑时,务必明确引入 copy.deepcopy() 进行隔离。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









