

Python列表浅拷贝与深拷贝的区别及实际应用误区

在Python日常开发中,列表(list)是最常用的可变容器类型。然而,许多开发者在复制列表时,常常因为混淆了变量赋值、浅拷贝(Shallow Copy)与深拷贝(Deep Copy)的本质差异,导致看似毫无关联的代码逻辑相互干扰,产生难以排查的“幽灵数据污染”缺陷。
核心结论可以概括为三句话:
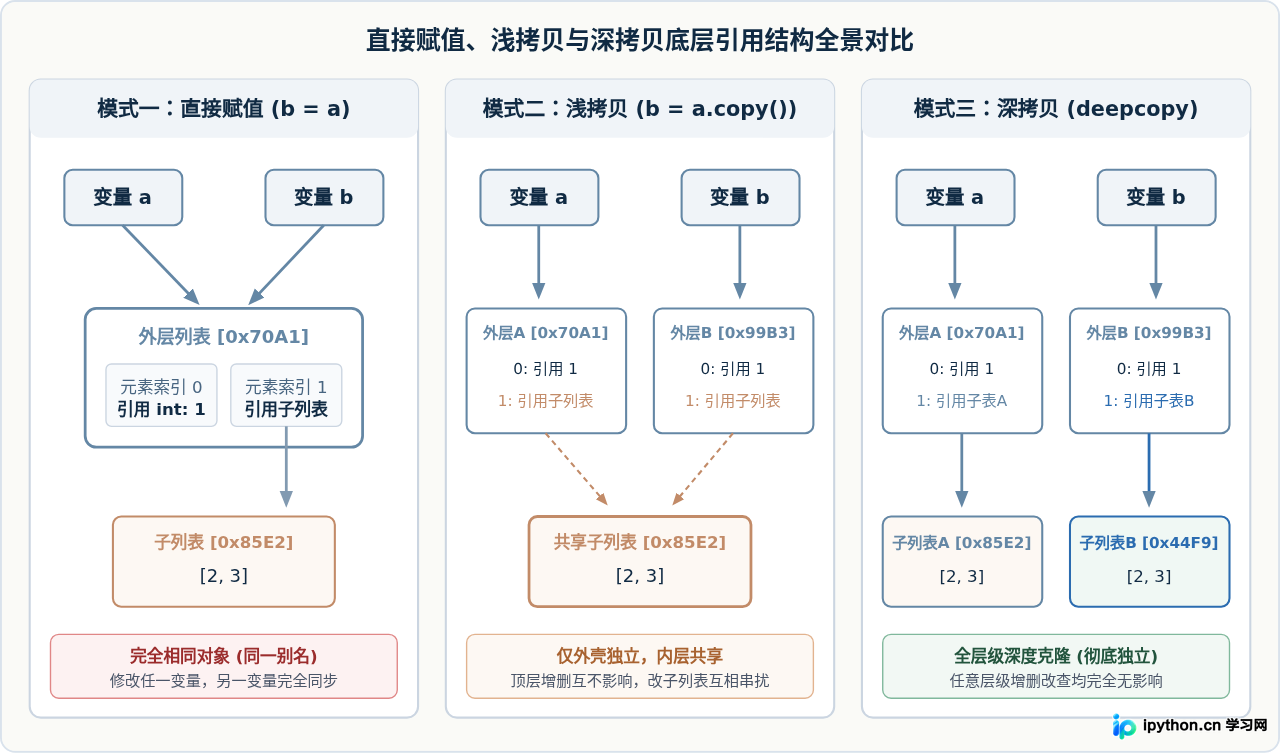
- 变量直接赋值:仅是增加了一个别名标签,多个变量共享同一个内存对象,任何修改均完全同步。
- 浅拷贝:创建了一个全新的顶层列表外壳,但内部嵌套子对象的引用原封不动地复制过来;修改顶层元素互不影响,修改嵌套子对象仍会相互牵连。
- 深拷贝:递归克隆所有层级的容器与可变对象,构建拓扑结构相同但内存地址完全独立的全新对象,实现真正意义上的彻底隔离。
一、Python列表的内存模型与引用机制
要透彻理解拷贝的差别,必须首先看清Python列表在底层内存中的存储结构。Python中的变量名并不直接存储具体数值,而是存储指向堆内存中真实对象的引用(即内存地址指针)。
Python的列表本质上是一个指针数组。当定义一个列表 original = [1, [2, 3]] 时,外层列表对象维护的是两个指针槽位:第0个槽位存储整数对象 1 的引用,第1个槽位存储子列表 [2, 3] 的引用。这种间接引用机制决定了拷贝动作在不同层级上的行为截然不同。
二、浅拷贝的底层行为与五种实现途径
浅拷贝的作用是创建一个新的容器对象,但保留容器内部原始元素的引用。换言之,浅拷贝只复制了列表的“最外层结构”。
1. 浅拷贝的常见语法形式
在Python中,实现列表浅拷贝的方式非常多样,以下五种方式在运行机制和底层效果上等价:
b = a.copy():Python 3中最直观推荐的实例方法。b = a[:]:经典的完整切片语法,语法简洁且执行效率极高。b = list(a):使用内置工厂函数进行类型转换与新列表构造。b = [*a]:Python 3.5引入的解包表达式。b = copy.copy(a):标准库copy模块提供的通用浅拷贝函数。
2. 浅拷贝的实测代码与双重表现
浅拷贝对于一维不可变元素是安全的,但对嵌套可变对象会表现出“半独立、半共享”的特性:
import copy

original = [100, [20, 30]]
shallow = original.copy()

# 验证最外层容器地址:两者不同,说明外壳已独立
print(id(original) == id(shallow))        # 输出: False

# 验证内部子列表地址:两者相同,说明内部引用共享
print(id(original[1]) == id(shallow[1]))  # 输出: True

# 操作测试 1:修改顶层不可变元素
shallow[0] = 999
print(original)  # 输出: [100, [20, 30]](original 未受影响)
print(shallow)   # 输出: [999, [20, 30]]

# 操作测试 2:修改嵌套的可变子列表
shallow[1].append(40)
print(original)  # 输出: [100, [20, 30, 40]](original 被意外篡改!)
print(shallow) # 输出: [999, [20, 30, 40]]浅拷贝对顶层槽位重绑定(如 shallow[0] = 999)是完全隔离的;但对槽位所指可变对象的原地修改(如 shallow[1].append(...))是完全共享的。
三、深拷贝的运作机制与循环引用防护
当列表中包含多层嵌套的可变容器(如列表中有子列表、字典或自定义对象),且需要保证副本的任何改动都绝不影响原数据时,就必须使用深拷贝。
1. 深拷贝的底层实现机制
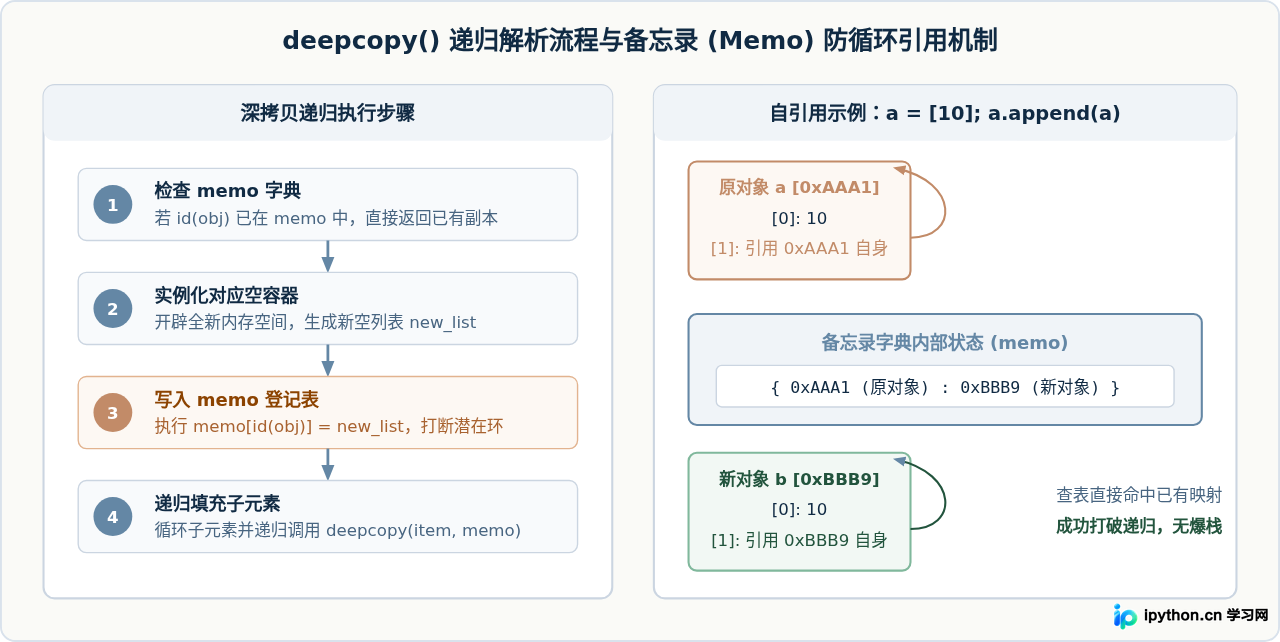
深拷贝通过调用标准库模块的 copy.deepcopy() 实现。它的工作机制是自顶向下递归遍历对象图:
- 首先检查当前对象是否为不可变基础类型(如数值、字符串、纯不可变元组)。若不可变,Python通常复用该对象直接返回,避免无谓的内存开辟。
- 若对象是可变容器(如列表、字典、集合),则在内存中实例化一个对应类型的全新空容器。
- 随后递归拷贝该容器内的每一个元素,将生成的新元素依次注入到新容器中,直到整棵对象树的所有叶子节点全部处理完毕。
2. 循环引用与备忘录(Memo)字典机制
在复杂的数据结构中,容器对象之间可能存在循环引用(例如子节点反向引用父节点,或者列表直接包含自身 a.append(a))。如果深拷贝仅做单纯的递归调用,程序必将陷入无限递归并最终崩溃(引发 RecursionError)。
为了解决这个问题,copy.deepcopy() 在内部维护了一个名为 memo 的字典。该字典记录了所有“已访问对象的内存ID -> 对应新创建对象”的映射关系:
四、实际应用中的四大高频误区与深水坑
误区一:以为直接赋值操作是在“复制列表”
这是初学者最容易触犯的错误。在Python中,list_b = list_a 绝不是把数据复制一份,而仅仅是给原来的对象多贴了一个名字标签。
# 错误场景:试图备份原数据
def process_scores(scores):
    backup = scores  # 严重错误:backup 和 scores 指向完全相同的列表!
    scores.sort()    # 原地排序直接破坏了原数据顺序
    print("备份顺序同样被破坏:", backup)

raw_data = [88, 62, 95, 71]
process_scores(raw_data)
# raw_data 的原始输入顺序已经无法挽回避坑指南:函数内部需要保留传入列表的初态时,必须显式使用 backup = scores.copy() 或 backup = list(scores) 进行顶层隔离。
误区二:二维矩阵乘法初始化陷阱(经典的“改一改三”血案)
在算法题或开发网格、矩阵时,许多人习惯用乘法运算符快速生成固定维度的二维列表:matrix = [[0] * 3] * 3。然而,这段代码会在内存中埋下一颗巨大的隐患炸弹。
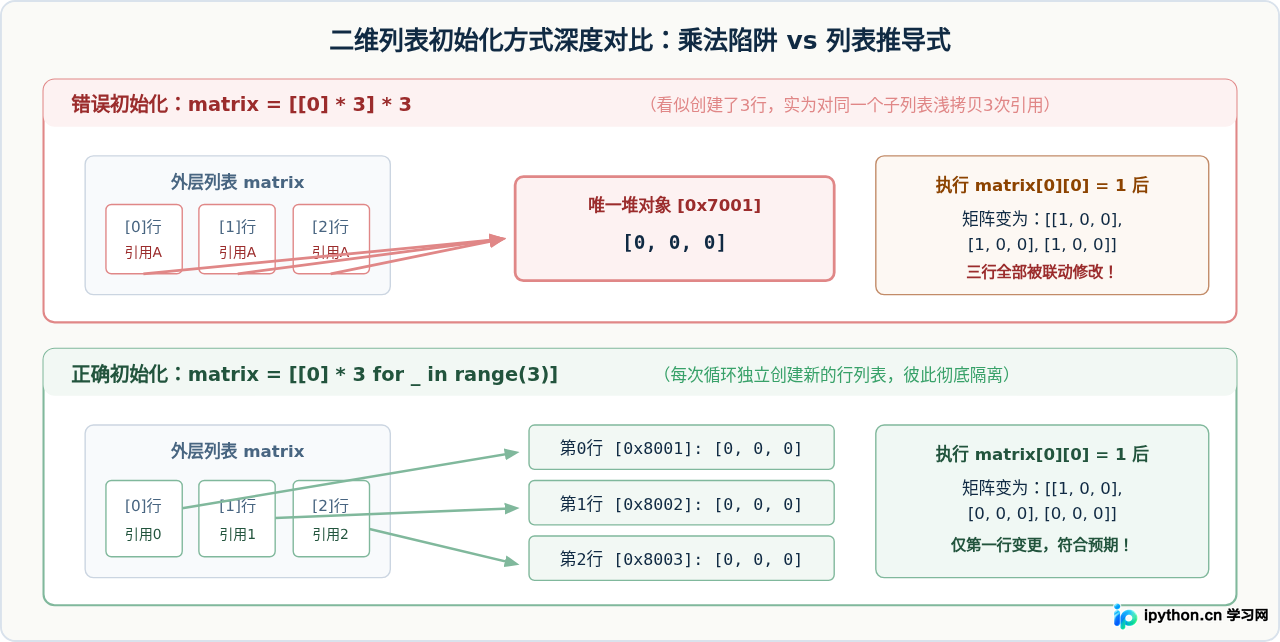
乘法运算符 [row] * 3 的本质是对列表内包含的对象引用进行浅拷贝重复复制。虽然外层的三个元素槽位是新建的,但它们都指向最先生成的同一个 [0, 0, 0] 子列表。只要通过 matrix[0][0] = 1 改动了该子列表,其他两行由于共用同一内存空间,打印时也会同时显示被篡改的结果。
误区三:包含“不可变对象内部的可变元素”时的盲区
许多开发者知道元组(tuple)是不可变对象,便误以为“列表中包含元组时,浅拷贝就是绝对安全的”。这是一种典型的认知漏洞。
# 列表中包含元组,元组内部包含可变子列表
data = [("用户A", ["权限1", "权限2"])]
cloned = data.copy()

# 尝试修改元组指针本身会抛出 TypeError
# cloned[0][0] = "用户B"  # 报错: 'tuple' object does not support item assignment

# 但是直接修改元组内部包含的可变列表却畅通无阻!
cloned[0][1].append("管理员权限")

print(data)
# 输出: [('用户A', ['权限1', '权限2', '管理员权限'])]
# 原列表 data 内部的权限列表同样被注入了新数据!避坑指南:元组的“不可变性”仅保证其自身存储的指针地址不可变更,并不负责冻结指针所指向的下层对象。若数据结构中任何层级存在可变类型,且需要独立变更,都必须使用深拷贝。
误区四:滥用深拷贝引发严重的性能雪崩与内存膨胀
发现浅拷贝会引起数据冲突后,部分开发人员走入另一个极端——“为了安全起见,所有列表一律使用 deepcopy”。这种做法极度危险,特别是在处理大规模数据集合或高并发任务时。
- 时间开销激增:
deepcopy需要遍历每个对象的类型、维护并查询内部memo字典,存在显著的函数调用栈和哈希查找开销。在纯一维列表或上万条数据的场景下,deepcopy的耗时可比切片浅拷贝慢上百倍。 - 内存成倍消耗:对大型复杂数据树执行深拷贝,会导致内存在瞬间翻倍,容易在后台进程中触发系统级内存溢出(OOM)。
- 意外破坏单例或系统对象:若列表中意外包含了线程锁(Lock)、网络连接句柄、生成器或文件IO对象,直接执行
deepcopy会引发错误或复制出异常的失效对象。
五、工程实践选型决策树与避坑指南
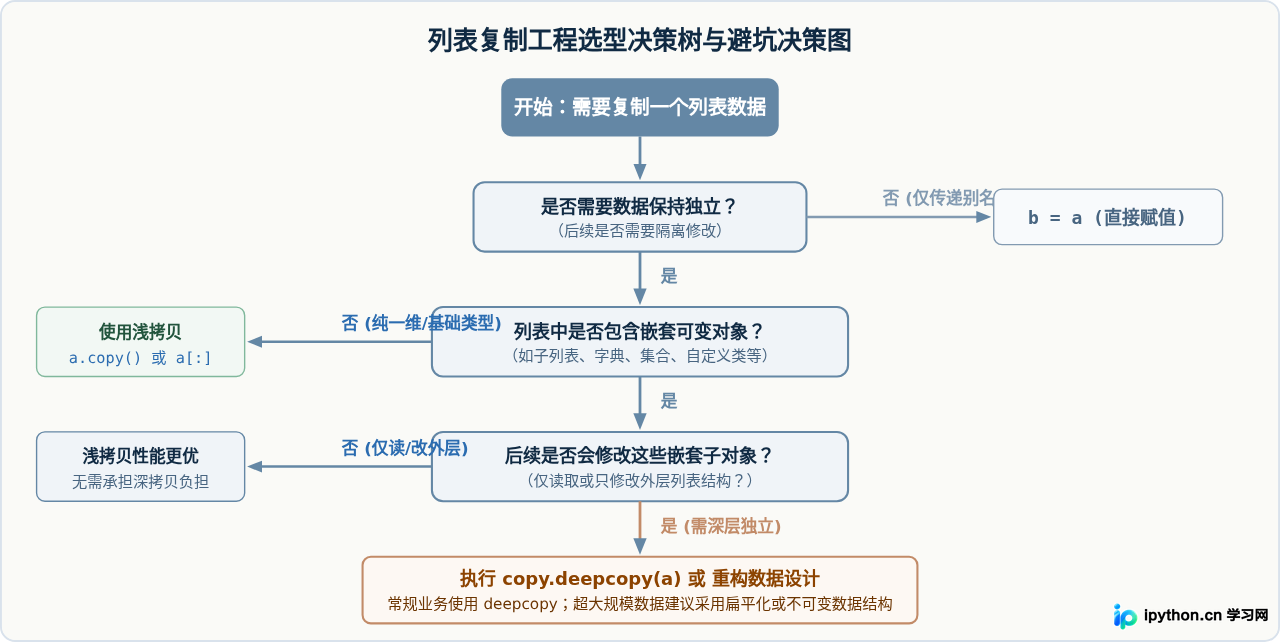
在工程落地中,应当根据列表存储的数据类型与后续的修改意图,遵循精确的选型路径:
选型综合对比矩阵
| 操作类别 | 常见语法形式 | 复制深度 | 内存开销 | 执行性能 | 典型适用场景 |
|---|---|---|---|---|---|
| 直接赋值 | b = a |
无拷贝(仅增加别名) | 零额外开销 | 纳秒级 | 需要共享数据状态、函数内部返回别名时。 |
| 浅拷贝 | a.copy() / a[:] / list(a) |
仅复制顶层指针数组 | 仅增加外层列表本身大小 | 微秒级(极快) | 纯一维列表,或嵌套数据只读且需独立增加/删除顶层元素时。 |
| 深拷贝 | copy.deepcopy(a) |
递归复制全部子层级 | 随嵌套结构与元素量成倍增长 | 毫秒级(含哈希与递归开销) | 多层配置字典、复杂树形/图状数据、算法回溯需完全独立快照时。 |
| 推导式构造 | [item.copy() for item in a] |
精准按需二级浅拷贝 | 仅复制指定层级 | 优于 deepcopy | 二维网格/矩阵独立复制,避免通用 deepcopy 性能浪费。 |
- 初始化多维列表:切勿使用
[[0] * n] * m,务必使用列表推导式[[0] * n for _ in range(m)]。 - 纯一维列表快照:优先使用
lst.copy()或lst[:],简单、安全且速度最快。 - 深层树状结构复制:引入
import copy并调用copy.deepcopy(lst),但在海量数据下需评估内存与递归成本。 - 不确定是否同源:在关键业务节点使用
id(obj1) == id(obj2)或obj1 is obj2校验两者是否共享底层内存。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









