

Python写入Elasticsearch常见报错解析与重试机制配置
深入解析Python写入Elasticsearch时的连接超时、429限流与400格式解析报错,详细讲解官方客户端配置、helpers.bulk批量写入重试与指数退避抖动机制的工程实现。
使用 Python 向 Elasticsearch 批量或高频写入数据时,网络闪断、集群负载激增、数据字段冲突等问题极易引发写入中断。解决写入可靠性问题的核心路径在于两步:准确认定报错性质以区分“可重试异常”与“不可重试异常”,并在客户端配置具备指数退避与随机抖动(Jitter)的自动重试机制。本文将针对写入阶段最具代表性的报错提供排查依据,并给出从官方 SDK 底层连接池到 helpers.bulk 批量处理的完整重试配置方案。
一、常见写入报错特征与可重试性研判
盲目对所有异常执行重试会导致严重后果:如果是由于文档结构不合规引发的校验错误,重试只会无限占用计算资源;如果是集群队列溢出,高频重试更会加剧雪崩。因此,写入异常的第一道防线是识别错误类型。
1. 网络与超时异常(ConnectionTimeout / ConnectionError)
报错现象:抛出 elasticsearch.exceptions.ConnectionTimeout 或 ConnectionError,通常伴随 Read timed out after X seconds 提示。
成因分析:Python 客户端与 ES 节点之间的网络链路抖动、代理网关断开,或单次请求数据包体积过大导致 ES 处理耗时超过客户端设定的 request_timeout 阈值。
处理决策:此类属于典型的瞬态故障(Transient Failure),必须重试。在多节点集群环境下,重试时应主动切换到连接池中的其他可用节点。
2. 集群负载过载与队列饱和(429 Too Many Requests)
报错现象:抛出 elasticsearch.exceptions.ApiError: ApiError(429, ...),返回信息中包含 es_rejected_execution_exception,提示 queue capacity = 200/200。
成因分析:ES 节点的写入线程池(Write Thread Pool)及其等待队列已满。当突发并发过高或磁盘 I/O 达到物理瓶颈时,协调节点无法承载新任务,主动拒绝写入请求。
处理决策:属于必须重试但严禁立即重试的异常。客户端必须施加指数退避(Exponential Backoff)策略,延后重试间隔并下调写入并发量,给集群留出清空队列的时间缓冲。
3. 数据映射与字段冲突(400 BadRequestError)
报错现象:抛出 BadRequestError(400, 'mapper_parsing_exception'),例如提示 failed to parse field [timestamp] of type [date] 或 object mapping for [user] tried to parse field as object, but found a concrete value。
成因分析:写入的文档字段类型与已有 Index Mapping 冲突,或 JSON 数据包含格式错误的日期、不符合规范的嵌套结构。
处理决策:属于永久性逻辑错误(Non-retryable),严禁重试。重复发送相同文档无法成功,应捕获该错误后将脏数据转存至死信队列(Dead Letter Queue,DLQ)或本地日志文件,随后由人工校验纠错。
4. 版本冲突与并发锁(409 ConflictError)
报错现象:抛出 ConflictError(409, 'version_conflict_engine_exception')。
成因分析:在指定 op_type='create' 或启用乐观并发控制(if_seq_no / if_primary_term)时,目标文档已经存在或已被其他并发进程修改。
处理决策:视业务策略决定。若业务遵循幂等覆盖,可改用默认的 index 操作;若需要严格时序控制,应重新拉取最新文档版本后再重试更新。
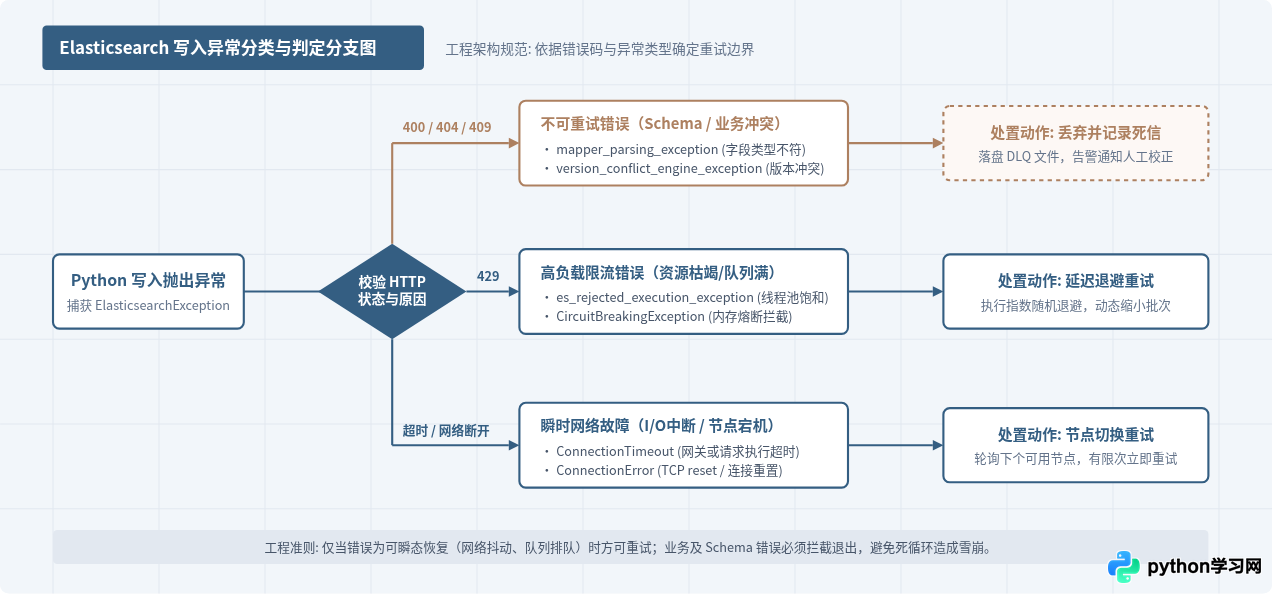
图 1: Elasticsearch 写入异常分类与判定分支图
二、Python 原生客户端基础重试机制配置
官方 Python 客户端 elasticsearch(v8.x 与 v7.x)内置了连接池与故障转移能力。通过在实例化客户端时正确注入重试参数,可以自动消化绝大多数由于节点重启、短暂丢包引起的写入中断。
from elasticsearch import Elasticsearch

# 初始化具备容灾与自动重试能力的 Elasticsearch 客户端
es = Elasticsearch(
    hosts=[
        "http://es-node-01:9200",
        "http://es-node-02:9200",
        "http://es-node-03:9200"
    ],
    # 单次请求超时时间(秒),避免大批次数据卡死线程
    request_timeout=30.0,
    # 开启超时引发的自动重试
    retry_on_timeout=True,
    # 单个请求最大重试次数(包含切换节点尝试)
    max_retries=3,
    # 指定需要触发自动重试的 HTTP 状态码(重点配置 429 与服务端错误)
    retry_on_status=(429, 502, 503, 504),
    # 动态集群节点嗅探(适用于直接暴露集群节点的内网环境,经由负载均衡反向代理时建议关闭)
    sniff_on_start=False,
    sniff_on_connection_fail=True,
    sniffer_timeout=60
)max_retries:默认为 3 次。该计数涵盖了连接失败与指定状态码失败。如果耗尽重试次数依然失败,SDK 将抛出最终捕获的底层异常。retry_on_status:默认情况下 SDK 不会自动对 HTTP 429 报错进行重试,必须显式添加 429,否则一旦线程池打满,客户端将直接抛出异常中断作业。retry_on_timeout:若写入请求为非幂等操作需格外注意;若仅使用带明确_id的文档写入,该项务必设置为True以对抗网络丢包。
三、生产级批量写入(helpers.bulk)重试与死信分流实战
单条调用 es.index() 产生极高的 HTTP 建立与销毁开销。生产中绝大多数数据同步均使用 elasticsearch.helpers.bulk 或 parallel_bulk。然而,bulk API 的返回形态非常特殊:即使部分文档写入失败,整体 HTTP 请求依然可能返回 200 OK,错误细节嵌套在响应体的 items 数组中。
因此,对于批量写入,不能单纯依赖客户端外层的 HTTP 重试,而必须配置 helpers.bulk 的内部重试参数,并严格解析捕获的 BulkIndexError。
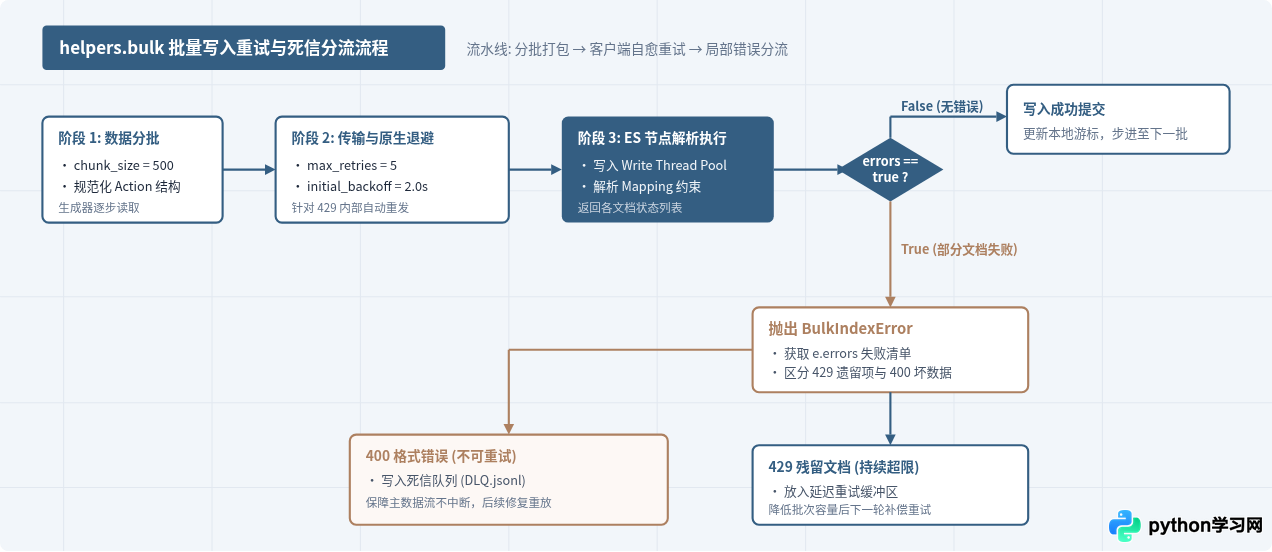
图 2: helpers.bulk 批量写入重试与死信分流流程
下面是生产环境中推荐的标准批量写入封装。代码集成了 helpers.bulk 的内部重试,并在遇到 BulkIndexError 时将坏文档和重试耗尽的文档分流处置:
import json
import logging
from typing import Iterable, Dict, Any
from elasticsearch import Elasticsearch
from elasticsearch.helpers import bulk, BulkIndexError

logger = logging.getLogger("es_sync")

def robust_bulk_index(
    es_client: Elasticsearch,
    actions: Iterable[Dict[str, Any]],
    index_name: str,
    chunk_size: int = 500,
    dlq_file_path: str = "dead_letter_queue.jsonl"
) -> Dict[str, int]:
    """
    稳健的 Elasticsearch 批量写入函数
    - 内置 429 退避重试机制
    - 捕获 BulkIndexError,精准隔离脏数据
    """
    stats = {"success": 0, "failed_schema": 0, "failed_retry_exhausted": 0}

    try:
        # helpers.bulk 原生支持对 429 状态进行指数退避重试
        success_count, _ = bulk(
            client=es_client,
            actions=actions,
            index=index_name,
            chunk_size=chunk_size,
            # 针对 429 / 队列排队的最大重试次数
            max_retries=5,
            # 初始退避等待时长(秒)
            initial_backoff=2.0,
            # 最大退避时长上限(秒)
            max_backoff=60.0,
            # 是否在退避中加入随机抖动
            backoff_factor=2.0,
            # 设为 True 时,如果重试后仍有文档失败,将抛出 BulkIndexError
            raise_on_error=True,
            # 设为 False 避免因为单个文档错误而强行截断后续文档
            raise_on_exception=True
        )
        stats["success"] += success_count
        logger.info("批量写入完成,成功导入 %d 篇文档", success_count)

    except BulkIndexError as err:
        logger.error("批量写入存在失败项,触发死信分流,失败条数: %d", len(err.errors))

        with open(dlq_file_path, "a", encoding="utf-8") as dlq_file:
            for item in err.errors:
                action_type = next(iter(item.keys()))
                detail = item[action_type]
                status_code = detail.get("status", 0)
                error_info = detail.get("error", {})

                # 400 属于数据结构错误,记录死信供排查修复
                if status_code == 400:
                    stats["failed_schema"] += 1
                    logger.warning("文档 Schema 错误: id=%s, reason=%s",
                                   detail.get("_id"), error_info.get("reason"))
                    dlq_record = {
                        "index": index_name,
                        "doc_id": detail.get("_id"),
                        "status": status_code,
                        "error": error_info,
                        "data": detail.get("data")
                    }
                    dlq_file.write(json.dumps(dlq_record, ensure_ascii=False) + "\n")

                # 429 耗尽重试次数,需告警通知降低写入并发
                elif status_code == 429:
                    stats["failed_retry_exhausted"] += 1
                    logger.critical("ES 集群负载持续超限,文档已丢弃: id=%s", detail.get("_id"))
                else:
                    logger.error("其他未决错误 status=%d: %s", status_code, str(error_info))

    return stats
四、高级自定义退避:指数退避与随机抖动(Full Jitter)
当多个 Python 写入 Worker(例如多进程爬虫、Celery 分布式任务队列)同时向同一个 ES 集群批量写入时,如果遭遇 429 报错,常规的固定时间重试或简单的指数退避(2s, 4s, 8s...)会导致严重的羊群效应(Thundering Herd Problem)。
所有 Worker 在相同的退避时间点同时苏醒并再次发起重试,瞬间在 ES 节点上制造巨大流量洪峰,导致集群写入队列反复被打满。工程落地的最优实践是采用 Full Jitter(全随机抖动) 算法:在指数增长的上限范围内,完全随机选取重试间隔时间,将重试请求在时域上均匀铺开。
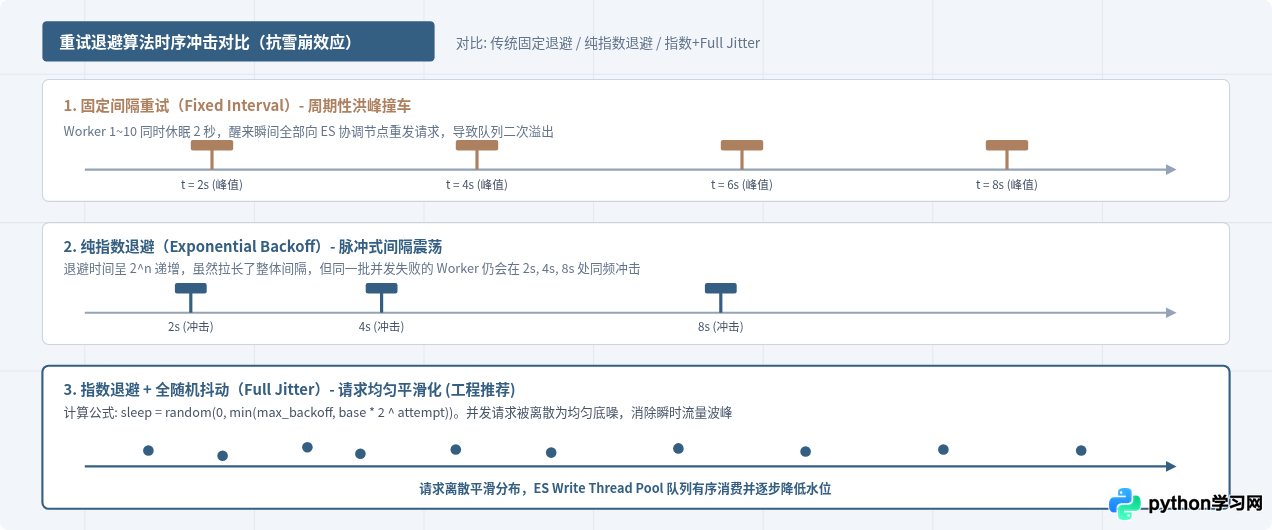
图 3: 重试退避算法时序冲击对比(抗雪崩效应)
下面给出基于 Python 标准库实现的 Full Jitter 重试装饰器。它不仅可用于 Elasticsearch 的索引操作,也可直接作用于任意自定义的数据入库函数中:
import time
import random
import logging
from functools import wraps
from elasticsearch.exceptions import ConnectionError, ConnectionTimeout, ApiError

logger = logging.getLogger("es_retry")

def retry_with_full_jitter(
    max_retries: int = 5,
    base_delay: float = 1.0,
    max_delay: float = 30.0
):
    """
    具备全随机抖动(Full Jitter)的指数退避重试装饰器
    sleep = random.uniform(0, min(max_delay, base_delay * (2 ** attempt)))
    """
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            attempt = 0
            while True:
                try:
                    return func(*args, **kwargs)
                except (ConnectionError, ConnectionTimeout) as e:
                    # 瞬态网络异常直接进行退避重试
                    attempt += 1
                    if attempt > max_retries:
                        logger.error("网络异常耗尽重试次数 (%d/%d): %s", attempt, max_retries, e)
                        raise

                    sleep_time = random.uniform(0, min(max_delay, base_delay * (2 ** attempt)))
                    logger.warning("捕获网络超时,第 %d 次重试,退避等待 %.2f 秒", attempt, sleep_time)
                    time.sleep(sleep_time)

                except ApiError as e:
                    # 对于 API 报错,仅对 429 熔断限流重试
                    if e.status_code == 429:
                        attempt += 1
                        if attempt > max_retries:
                            logger.error("集群负载超限,耗尽重试次数 (%d/%d): %s", attempt, max_retries, e)
                            raise

                        sleep_time = random.uniform(0, min(max_delay, base_delay * (2 ** attempt)))
                        logger.warning("触发 ES 429 限流,第 %d 次重试,退避等待 %.2f 秒", attempt, sleep_time)
                        time.sleep(sleep_time)
                    else:
                        # 400 等业务逻辑错误立即上抛,不进行无谓重试
                        logger.error("遇到不可重试的 Elasticsearch API 错误 (status=%d): %s", e.status_code, e)
                        raise
        return wrapper
    return decorator

# 使用示例
@retry_with_full_jitter(max_retries=4, base_delay=1.5, max_delay=20.0)
def insert_single_document(es: Elasticsearch, index: str, doc_id: str, body: dict):
    return es.index(index=index, id=doc_id, document=body)
五、集群端排障核对与配置验证
重试机制是客户端在出现问题时的自我保护手段,但重试发生本身意味着服务端已经出现了瓶颈或异常。当 Python 写入作业频繁触发重试日志时,应在 Elasticsearch 服务端核对以下运行指标以找到根因:
1. 查看写入线程池积压状态
# 在终端或 Kibana Dev Tools 中执行
GET _cat/thread_pool/write?v&h=node_name,name,active,queue,rejected,completed
关键指标解读:
queue:当前排队的写入任务数。如果长期接近上限(默认通常为 200 或 1000),说明集群吞吐已经饱和。rejected:累计被拒绝的任务总数。只要此数值在持续自增,Python 客户端就必然收到 429 报错。
2. 临时与永久优化措施
- 调小客户端
chunk_size:过大的批次(如一次 5000 条)容易造成单批次解析时间过长并引发超时。推荐将单批次文档量下调为 500~1000 条,单批总大小控制在 5MB~15MB 之间。 - 增大索引刷新间隔(Refresh Interval):批量写入阶段可临时将刷新间隔设为
-1或30s,减少 Lucene Segment 生成频率:
PUT my_index/_settings {"index": {"refresh_interval": "30s"}} - 临时调整副本数(Replica):海量初始化写入时可将
number_of_replicas设为0,待写入完全结束后再恢复为1。
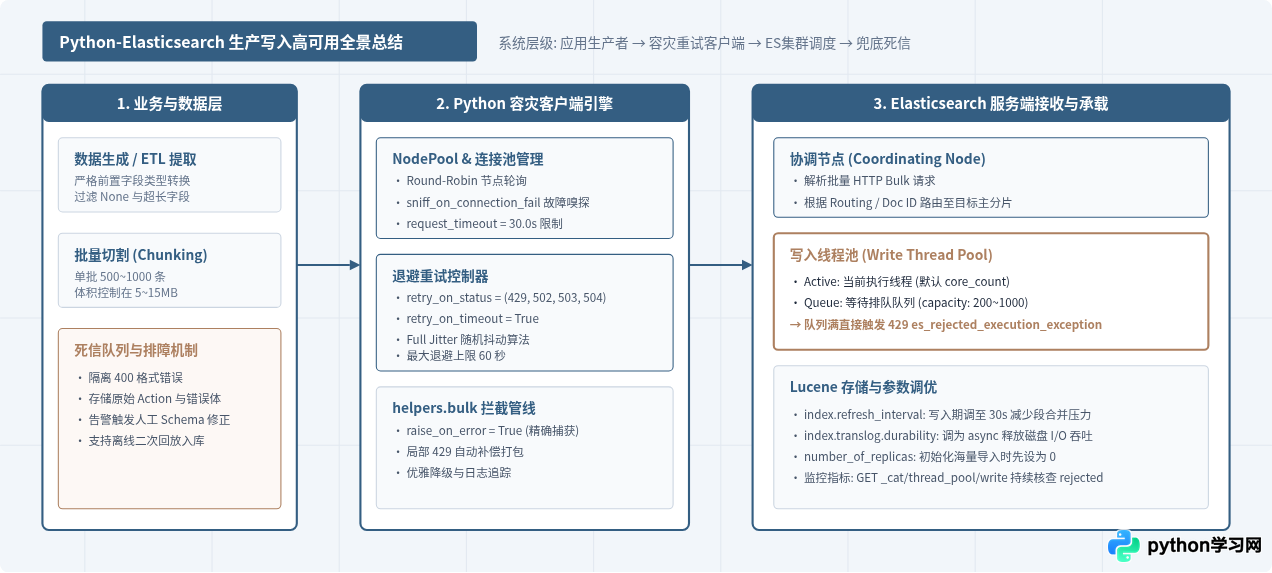
图 4: Python-Elasticsearch 生产写入高可用全景总结
六、工程落地核对清单
| 核对维度 | 标准配置 / 建议阈值 | 目的与排障收益 |
|---|---|---|
| 客户端超时 | request_timeout=30.0 |
防止由于网关或单节点缓慢导致线程永久悬挂。 |
| 重试状态码 | retry_on_status=(429, 502, 503, 504) |
必须显式纳入 429,确保集群队列打满时能够自动退避重试。 |
| 退避算法 | Full Jitter(全随机抖动) | 打散并发 Worker 唤醒时钟,彻底根除重试导致的二次雪崩。 |
| 批量大小 | 500 ~ 1000 docs / 批(约 5MB~10MB) | 在吞吐量与集群处理时延之间取得最佳平衡。 |
| 异常分流 | 捕获 BulkIndexError,400 入 DLQ |
避免由于单条脏数据导致整个写入任务中断崩溃。 |
| 集群端观测 | GET _cat/thread_pool/write |
确认 rejected 字段是否为 0,定位物理瓶颈所在。 |
通过区分错误类型、配置连接池级自动重试、在 helpers.bulk 启用指数随机退避并配套死信分流,Python 与 Elasticsearch 之间的数据写入链路即可具备抵抗网络抖动与集群过载的工业级弹性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









