

为什么Python字符串不能直接修改?str不可变特性解析

在 Python 中,尝试通过索引直接修改字符串字符(例如执行 s[0] = 'H')会立刻引发 TypeError: 'str' object does not support item assignment。这是因为字符串(str)在设计上属于不可变对象(Immutable Object)。字符串一旦在内存中分配,其长度和内部字符序列就被永久固化,任何尝试原地变更其内容的操作都会被解释器直接阻断。
一、尝试直接修改时的报错与内存底层表现
为了直观观察这一机制,我们先在交互式命令行中执行以下代码:
# 示例代码:直接按索引赋值
text = "hello"
print("修改前地址:", id(text))

text[0] = "H"
# 报错信息:
# TypeError: 'str' object does not support item assignment该错误明确提示:str 对象不支持项赋值。作为对比,同为序列类型的列表(list)却可以轻松支持原地项赋值:
# 示例代码:列表支持原地修改
char_list = ['h', 'e', 'l', 'l', 'o']
print("修改前地址:", id(char_list))

char_list[0] = 'H'
print("修改后内容:", char_list)
print("修改后地址:", id(char_list))  # 地址保持一致,属于原地修改
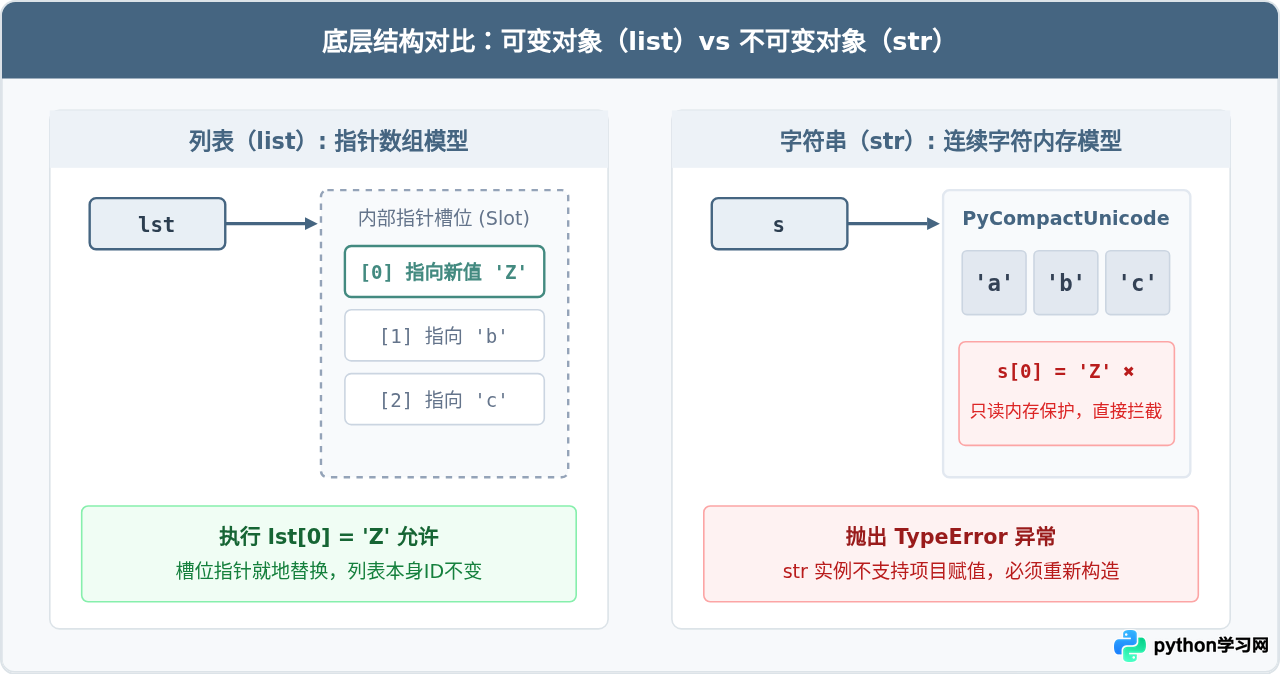
这种差异源自两者的底层内存组织方式:列表本质上是一个动态的指针数组,它的元素是指向各个独立对象的引用,修改列表元素只是替换了对应槽位存储的内存指针;而 Python 的 str 内部采用连续紧凑的字符缓冲结构(在 CPython 底层对应 PyASCIIObject 或 PyCompactUnicodeObject),字符序列与对象头紧密结合且被标记为只读,底层没有预留任何原地写操作接口。
二、Python 将字符串设计为不可变的三大核心原因
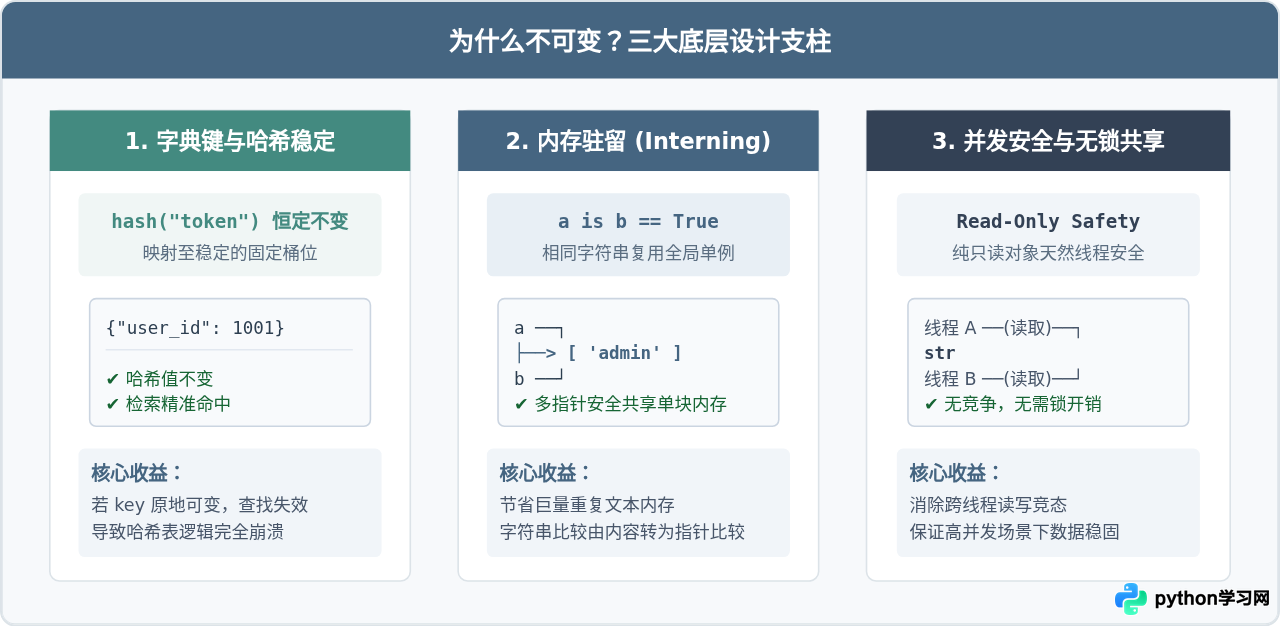
将核心数据类型设计为不可变,绝非语法层面的刻意刁难,而是综合权衡了散列安全、系统性能与多线程稳定性的工程决定。具体表现在以下三个关键支柱:
1. 保证哈希表(dict 和 set)的寻址一致性
在 Python 内部,字典(dict)和集合(set)是基于哈希表实现的。当使用对象作为字典的键时,Python 会首先调用其 __hash__() 方法计算出哈希值,进而定位元素在哈希桶中的位置。
如果字符串是可变的,当一个字符串作为字典的键存入后,若它的内容随后在原地发生改变,其哈希值也将同步改变。这将导致下一次通过原键查询字典时,哈希函数计算出完全不同的桶索引,原存入的数据将“人间蒸发”而无法被命中,甚至引发哈希冲突链表彻底错乱。不可变性保证了对象的哈希值在整个生命周期内恒定不变,是其作为安全字典键的前提。
2. 支持字符串驻留(String Interning)与内存共享
为了节省内存开销并提升字符串对比速度,Python(CPython)实现了字符串驻留机制。对于由字母、数字、下划线构成的常用短字符串及代码标识符,解释器会在全局字典中维护单例缓存:
# 示例代码:字符串驻留现象
a = "python_script"
b = "python_script"

# 判断二者是否指向同一内存地址
print(a is b)        # 输出: True
print(id(a) == id(b))  # 输出: True
如果字符串是可变对象,当开发者修改变量 a 的内容时,所有共享同一内存块的变量(如 b、函数名、模块属性等)都会在毫无察觉的情况下被篡改,带来灾难性的隐蔽副作用。正因为字符串不可变,Python 才能安全地让数万个变量引用同一个字符串实例。
3. 天然实现跨线程读取的数据安全
在多线程并发环境中,共享可变数据往往需要引入锁机制(如互斥锁、读写锁)来防止并发写入导致的数据竞态(Race Condition)。而不可变对象一旦完成初始化,其内容就是只读的,任何线程都可以无须加锁直接并发读取,从根源上消除了并发读写冲突,降低了运行时代价。
三、如何在实际业务中“修改”字符串?
理解了不可变性后,我们在日常编程中如果确实需要变更字符串内容,应该如何操作?答案是:通过构造一个全新的字符串对象来替代旧对象。根据具体场景,主要有以下三种标准模式:
1. 针对局部指定索引的修改:切片拼接法
如果要替换某个明确索引位置的单个字符或局部切片,可以通过切片提取前后两部分,与新字符拼接生成全新字符串:
# 场景:将索引 0 的字符改为大写 'H'
s = "hello"
s_new = 'H' + s[1:]
print(s_new)  # 输出: Hello

# 场景:替换中间指定索引 i 的字符(如将第 2 位的 'l' 替换为 'L')
i = 2
s_modified = s[:i] + 'L' + s[i+1:]
print(s_modified)  # 输出: heLlo
2. 针对指定文本或子串模式的替换:replace() 方法
若需求是按内容进行子串查找并替换,应直接调用内置的 str.replace() 方法:
text = "apple pie, apple cider"
# 替换所有 "apple" 为 "orange"
new_text = text.replace("apple", "orange")
print(new_text)  # 输出: orange pie, orange cider

# 限制替换次数(只替换第 1 处)
single_replace = text.replace("apple", "orange", 1)
print(single_replace)  # 输出: orange pie, apple cider
3. 针对高频拼接与大批量修改:列表收集与 join()
如果需要在循环中多次向字符串追加字符或拼接文本,严禁在循环内部连续使用 += 操作符。因为每次 += 都会触发一次全新内存分配与全量内容拷贝,导致整体算法复杂度退化为 $O(N^2)$。正确的做法是先将元素存入列表,最后统一调用 join():
# 推荐做法:列表暂存 + join 聚合(复杂度 O(N))
chunks = []
for i in range(5):
    chunks.append(f"item_{i}")

result = ",".join(chunks)
print(result)  # 输出: item_0,item_1,item_2,item_3,item_4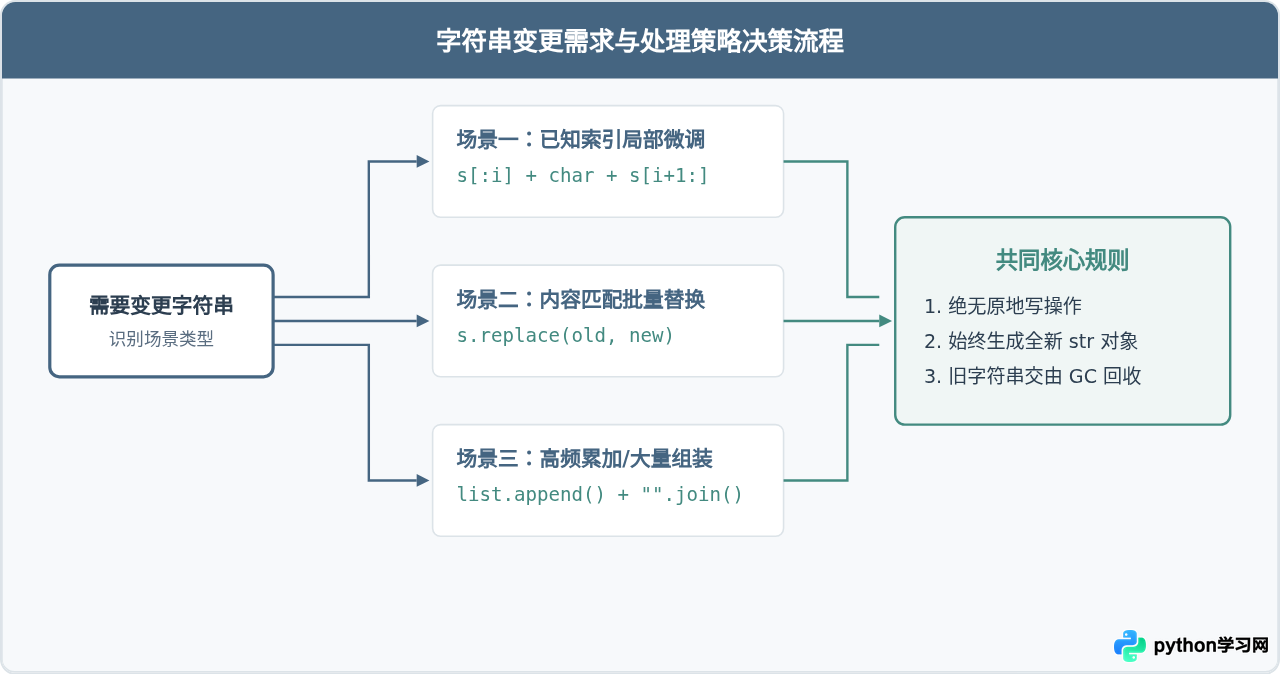
四、常见认知误区与避坑指南
初学者常有疑问:“如果我写
s = 'abc',紧接着写 s = 'xyz',s 的内容不是变了吗?”这里发生的是变量引用重定向。变量
s 只是一个附着在对象上的“标签名”。第二步赋值并没有改变原先的 'abc' 对象,而是创建了一个全新的 'xyz' 对象,并将标签 s 撕下来贴到了新对象上。原对象如果失去了所有引用,会被 Python 的垃圾回收器(GC)自动释放。
+= 拼接在旧版本或大循环场景中,每次执行
s += chunk 都会开辟新内存块并将原有内容全量拷贝进去。循环 $N$ 次累计耗时高达 $O(N^2)$。处理文本流、拼接长文件时,务必使用列表累加后统一 join() 或借助 io.StringIO 内存流缓冲区。
五、总结与知识回顾
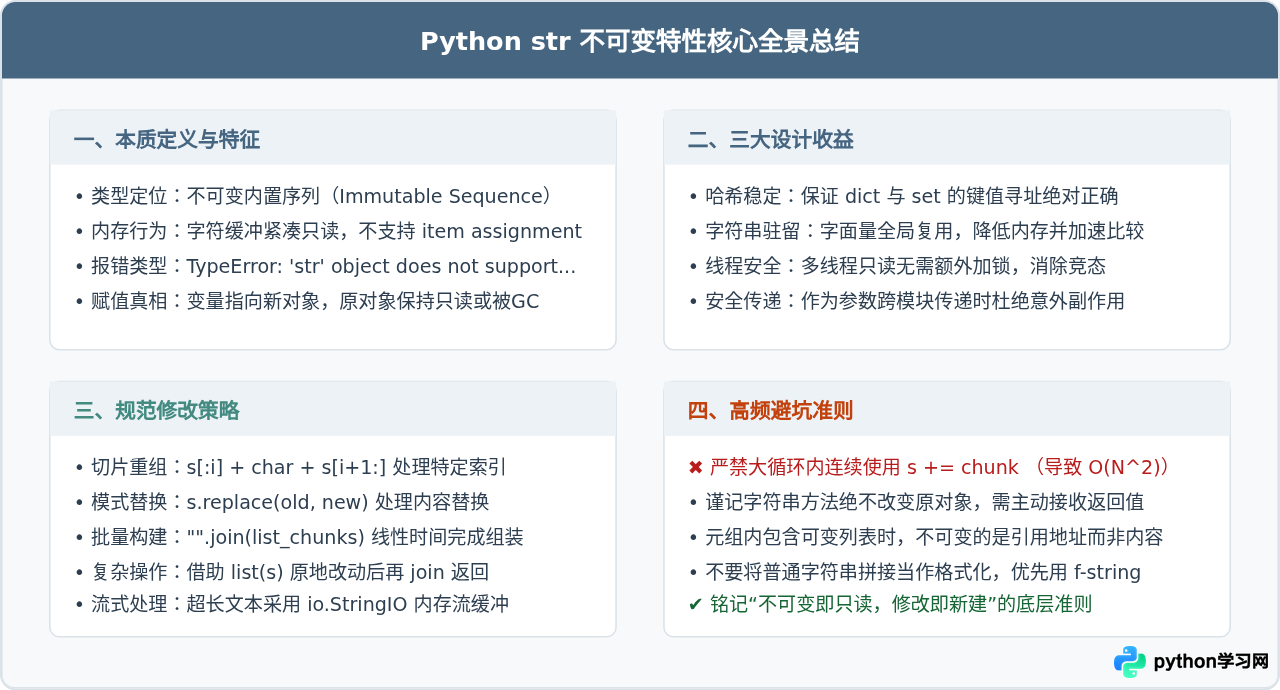
Python 字符串的不可变特性是语言底层的基石设计之一。它确保了哈希表的可靠寻址、驱动了字符串驻留带来的空间精简,同时为并发执行提供了天然的无锁安全性。日常开发中牢记“修改即新建”的原则,针对不同场景灵活运用切片、replace 与 join,便能写出既健壮又高效的高质量代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









