

Python Web实现在线编辑Excel:Flask结合openpyxl处理上传与下载
深入讲解如何使用Python轻量Web框架Flask结合openpyxl库,利用标准内存字节流io.BytesIO实现无物理落盘的Excel上传、在线解析、数据编辑与动态下载完整方案。
.xlsx 格式设计的 openpyxl 处理库,并通过 Python 内置的 io.BytesIO 内存字节流作为枢纽:整个过程无需向服务器磁盘写入任何临时文件,兼具高处理效率与并发无状态优势。
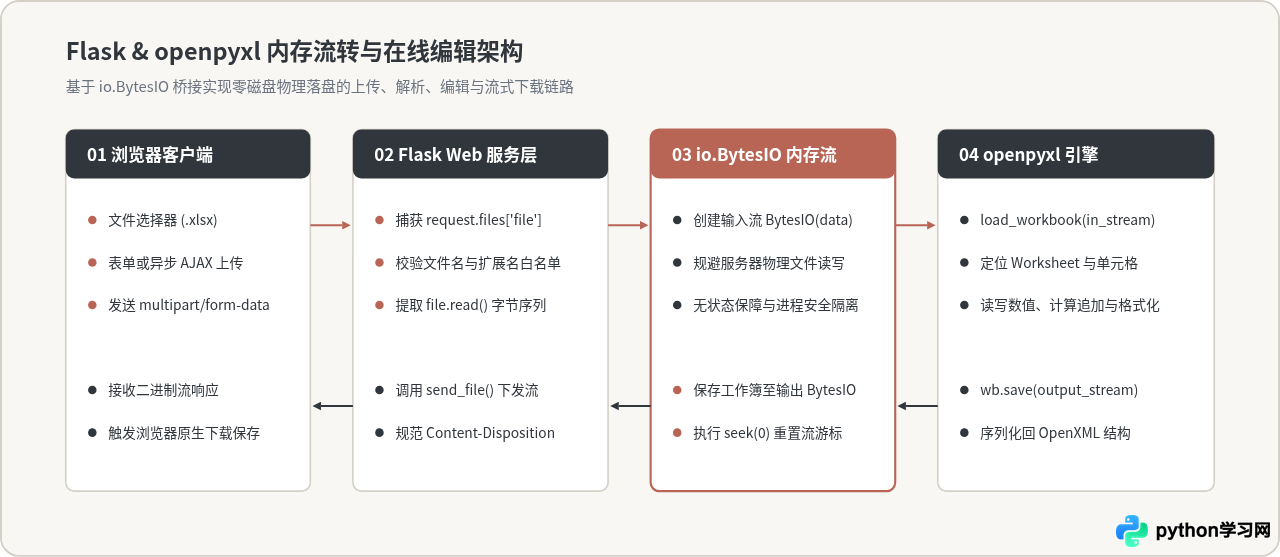
一、系统整体架构与端到端数据流
传统的文件处理方式通常先将前端上传的文件保存到服务器的临时目录(如 /tmp),再通过文件路径打开修改并写回磁盘,最后由 Web 框架读取物理文件发送给用户。这种方式不仅增加了磁盘 I/O 损耗,在多实例部署或容器化环境中,还极易遭遇并发文件名冲突、磁盘空间泄露以及缺少清理定时任务导致的存储耗尽问题。
更为工程化的处理模式是“全内存流式运转”。Flask 接收到客户端发起的 multipart/form-data 表单后,提取 FileStorage 对象的内部流;openpyxl 直接从内存流中加载工作簿;业务层完成单元格计算、样式填充或行列增删后,再将工作簿保存至新的 io.BytesIO 缓冲区,最后通过 Flask 的 send_file 工具配合标准响应头回传客户端。
二、依赖环境与最小运行骨架
实现该方案仅需 Python 标准库与两个核心第三方库:负责 Web 路由与 HTTP 处理的 Flask,以及负责解析和构建 .xlsx 格式的 openpyxl。在虚拟环境中直接安装:
pip install flask openpyxl werkzeug
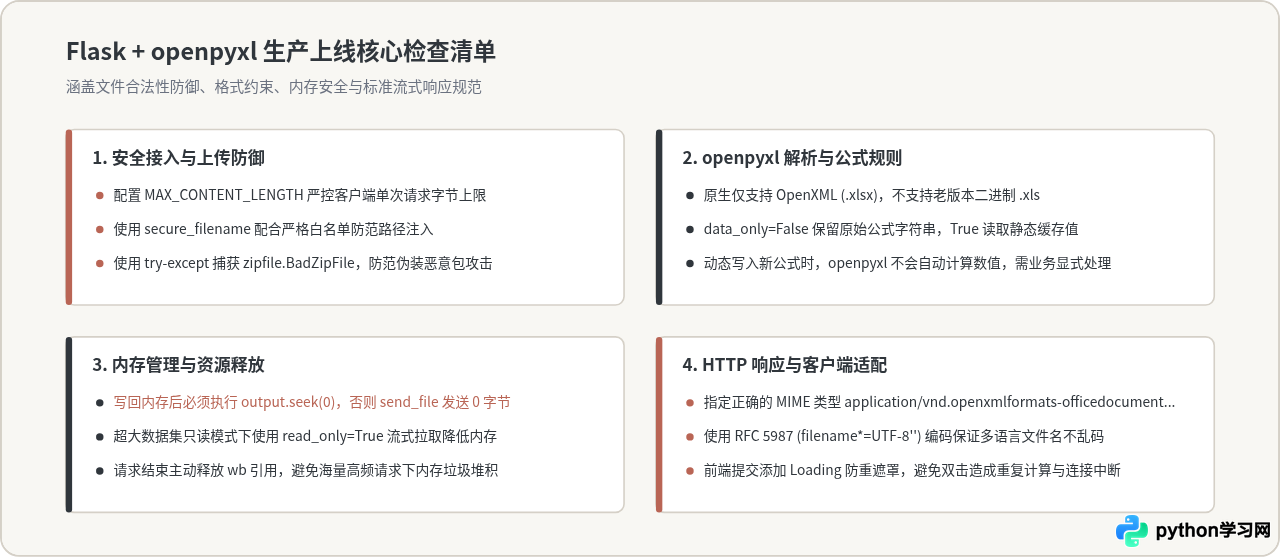
需要明确的是,openpyxl 原生仅支持基于 ECMA-376 标准的 Office Open XML 格式(即 .xlsx、.xlsm、.xltx),它并不支持老旧的二进制 .xls 格式(Excel 97-2003)。因此在接口层必须配置扩展名白名单,避免非合法文件进入解析引擎。
三、核心操作流程与分步生命周期
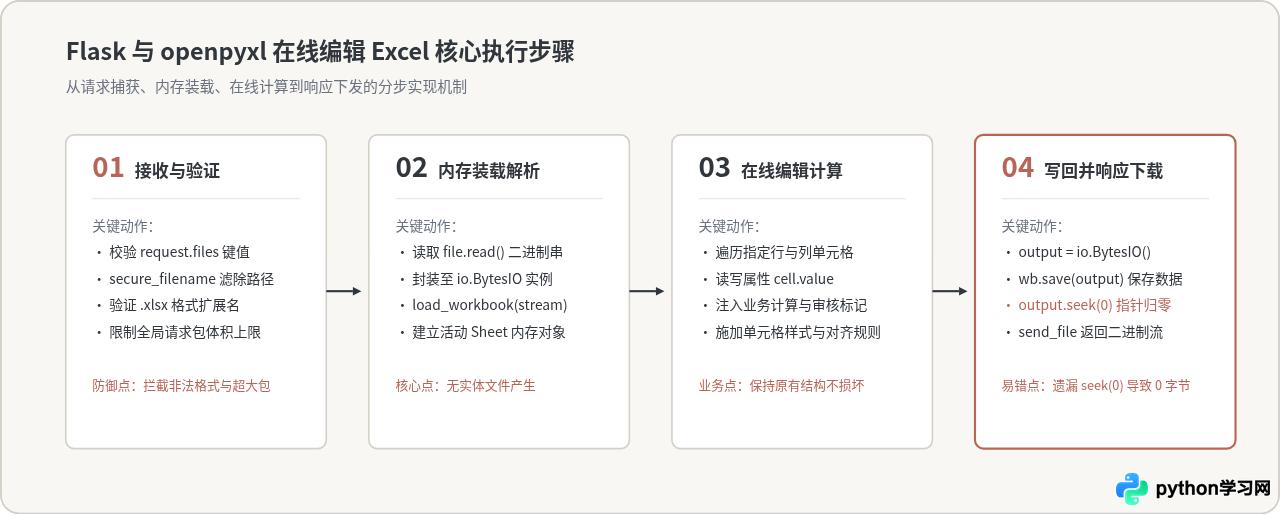
一次完整的在线修改交互包含四个不可或缺的生命周期阶段,每个阶段都有其关键技术约束和代码细节。
1. 接收文件并构建内存输入流
在 Flask 视图函数中,上传的文件通过 request.files['字段名'] 获取。此时对象为 werkzeug.datastructures.FileStorage。可以通过 file.read() 读取全部字节并放入 io.BytesIO 中:
import io
import openpyxl
from flask import request

file = request.files['excel_file']
# 读取内存字节流并载入 openpyxl 工作簿
input_stream = io.BytesIO(file.read())
wb = openpyxl.load_workbook(input_stream)
2. 在线编辑数据与样式控制
载入工作簿后,通过 wb.active 访问当前默认工作表,或通过 wb['Sheet名称'] 显式指定工作表。通过行列索引或单元格坐标修改数据:
ws = wb.active

# 1. 动态在末尾追加表头
new_col_index = ws.max_column + 1
ws.cell(row=1, column=new_col_index, value="审核结果")

# 2. 遍历数据行并写入计算值
for row in range(2, ws.max_row + 1):
    raw_amount = ws.cell(row=row, column=2).value  # 假设第2列为金额
    if raw_amount is not None:
        ws.cell(row=row, column=new_col_index, value="已核算")
3. 保存至内存流与指针归零
openpyxl.Workbook.save() 方法不仅支持接收文件路径字符串,也支持任何实现了 write() 方法的文件类对象。创建一个空的 io.BytesIO() 作为接收容器,调用 wb.save(output) 后,字节流内部的游标指针已经停留在末尾。必须执行 output.seek(0),将读取指针复位到第 0 字节,后续的 send_file 才能从头读取完整数据并输出给客户端;如果遗漏此操作,客户端下载到的将是一个 0 字节的损坏文件。
四、完整端到端实现代码
以下是包含文件校验、业务处理、公式处理容错、RFC 5987 编码及流式响应的完整可运行服务代码:
import io
import urllib.parse
from flask import Flask, request, send_file, render_template_string
from werkzeug.utils import secure_filename
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment

app = Flask(__name__)
# 限制客户端最大请求体为 16MB,超出自动返回 413 Payload Too Large
app.config['MAX_CONTENT_LENGTH'] = 16 * 1024 * 1024

ALLOWED_EXTENSIONS = {'xlsx'}

def is_allowed_file(filename: str) -> bool:
    return '.' in filename and filename.rsplit('.', 1)[1].lower() in ALLOWED_EXTENSIONS

HTML_FORM = """
<!DOCTYPE html>
<html>
<head><title>Excel 在线上传编辑</title></head>
<body style="font-family: sans-serif; padding: 40px;">
  <h2>上传 .xlsx 文件进行在线批量编辑</h2>
  <form action="/process-excel" method="post" enctype="multipart/form-data">
    <p><input type="file" name="excel_file" accept=".xlsx" required></p>
    <button type="submit">上传并在内存中处理并下载</button>
  </form>
</body>
</html>
"""

@app.route('/')
def index():
    return render_template_string(HTML_FORM)

@app.route('/process-excel', methods=['POST'])
def process_excel():
    if 'excel_file' not in request.files:
        return "请求中未包含文件字段", 400

    file = request.files['excel_file']
    if not file or file.filename == '':
        return "未选择任何文件", 400

    if not is_allowed_file(file.filename):
        return "格式不受支持:仅支持 .xlsx 文件", 400

    # 提取安全文件名
    safe_name = secure_filename(file.filename) or "document.xlsx"

    try:
        # 1. 读入内存字节流
        input_stream = io.BytesIO(file.read())

        # 2. openpyxl 解析内存流中的 Excel
        wb = openpyxl.load_workbook(input_stream)
        ws = wb.active

        # 3. 业务编辑演示:追加核验列并对指定数据执行加权运算
        target_col = ws.max_column + 1
        ws.cell(row=1, column=target_col, value="状态与调整金额")

        # 设置表头样式
        ws.cell(row=1, column=target_col).font = Font(name="Microsoft YaHei", bold=True, color="FFFFFF")
        ws.cell(row=1, column=target_col).fill = PatternFill(start_color="30363C", end_color="30363C", fill_type="solid")
        ws.cell(row=1, column=target_col).alignment = Alignment(horizontal="center")

        for row_idx in range(2, ws.max_row + 1):
            val = ws.cell(row=row_idx, column=2).value # 假设第2列为数值
            try:
                numeric_val = float(val) if val is not None else 0.0
                ws.cell(row=row_idx, column=target_col, value=round(numeric_val * 1.1, 2))
            except (ValueError, TypeError):
                ws.cell(row=row_idx, column=target_col, value="格式非数值")

        # 4. 写出至新的内存字节流
        output_stream = io.BytesIO()
        wb.save(output_stream)
        output_stream.seek(0) # 关键:重置流读取位置

        # 5. 组装下载文件名与响应头
        export_name = f"processed_{safe_name}"
        encoded_name = urllib.parse.quote(export_name.encode('utf-8'))

        response = send_file(
            output_stream,
            mimetype='application/vnd.openxmlformats-officedocument.spreadsheetml.sheet',
            as_attachment=True,
            download_name=export_name
        )

        # 依据 RFC 5987 注入兼容各类浏览器的下载文件名
        response.headers["Content-Disposition"] = (
            f"attachment; filename=\"{export_name}\"; filename*=UTF-8''{encoded_name}"
        )
        return response

    except Exception as err:
        return f"Excel 文件解析或编辑失败: {str(err)}", 500

if __name__ == '__main__':
    app.run(debug=True, port=5000)
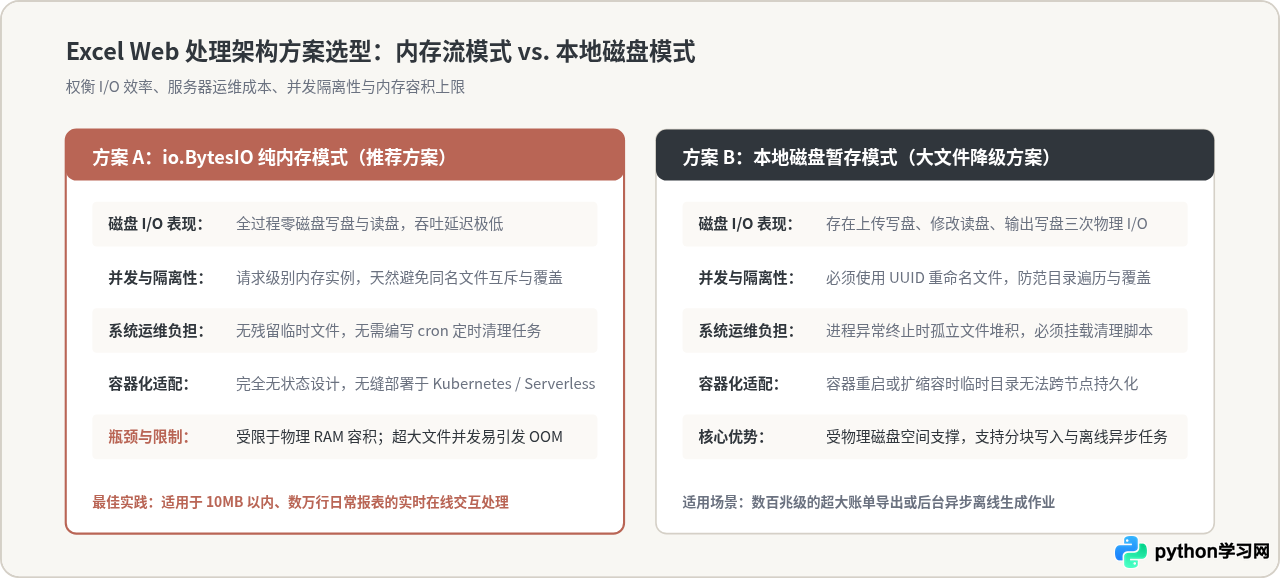
五、架构决策对比:内存流 vs. 磁盘落盘暂存
在实际项目落地时,团队往往会在“纯内存流”与“磁盘物理暂存”之间进行架构选型。两者并非绝对的优劣对立,而是面向不同文件规模与并发模型的权衡选择。
六、关键业务细节与常见陷阱排查
1. 公式计算结果与公式表达式的区别
在 Excel 内部,单元格如果包含公式(例如 =SUM(A1:A10)),文件内实际保存了两个信息:公式文本字符串,以及上一次 Office 保存时计算出的静态结果缓存。
- 默认情况下,
openpyxl.load_workbook(stream, data_only=False)读取得到的是公式文本本身(如"=SUM(A1:A10)")。若业务需要读取上一轮计算后的真实数值,需指定data_only=True。 - 需要特别注意:openpyxl 本身不包含公式计算引擎。如果你用代码向单元格写入了
ws['C1'] = '=A1+B1',在没有桌面 Excel 打开并重新重算前,该单元格的静态缓存值是不存在的。如果下游系统完全依赖静态值,需在 Python 代码中计算出确定数值后再写入。
2. 中文下载文件名的标准编码规范(RFC 5987)
在 HTTP 响应头 Content-Disposition 中,旧式 ASCII 编码会导致中文文件名在 Chrome、Firefox 或 Safari 等现代浏览器中出现乱码或下划线丢失。现代标准要求使用 RFC 5987 格式,通过 filename*=UTF-8''... 进行 URL 编码声明:
encoded_name = urllib.parse.quote("财务报表_已审核.xlsx".encode('utf-8'))
response.headers["Content-Disposition"] = (
    f"attachment; filename=\"export.xlsx\"; filename*=UTF-8''{encoded_name}"
)
3. openpyxl 内存膨胀防护
虽然 .xlsx 文件压缩包本身通常只有几兆字节,但 openpyxl 将其解压为 DOM 节点和 Python 对象树时,内存占用会膨胀 30 到 50 倍。对于并发较高的生产系统,必须采取以下防护策略:
- 配置最大请求体:通过
app.config['MAX_CONTENT_LENGTH'] = 16 * 1024 * 1024(16MB)限制上传体积,避免攻击者上传大体积文件耗尽服务内存。 - 大文件流式只读:若只需读取上传表格提取统计信息而无需原样回写格式,可传入
openpyxl.load_workbook(input_stream, read_only=True),它采用逐行解析器,内存占用恒定极小。 - 及时解除引用:在视图函数结束前,显式调用
wb.close()并重置局部变量,协助 Python 的垃圾回收器迅速释放内存。
七、总结
借助 Flask 与 openpyxl 处理 Excel 的在线编辑,核心在于理解并运用 Python 的内存流机制(io.BytesIO)。将二进制上传流作为输入载入 load_workbook,在内存中直接对工作表与单元格进行增删改查及样式调整,再无缝序列化至输出内存流并通过 send_file 触发客户端下载,构建了一个高内聚、零磁盘物理落盘、天生契合容器化与无状态架构的轻量化处理通道。配合完备的文件格式校验、异常捕获与 RFC 5987 文件名转义,即可稳定可靠地服务于各类自动化报表、在线审核与批量数据清洗业务场景。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









