

Python Web开发中怎么处理表单提交与文件上传

在 Python Web 开发中,处理表单提交与文件上传的核心在于理解 HTTP 请求的编码格式,并依据框架特性正确提取文本参数与二进制文件流,同时通过多层防御机制确保后端存储安全。常规文本表单通常使用键值对编码,而包含文件的表单必须采用多部分编码(multipart/form-data)。本文将以常用框架(Flask 与 FastAPI)为例,拆解表单接收、安全校验、流式落盘与常见误区的全流程解决方案。
一、HTTP 请求体编码与传输基础
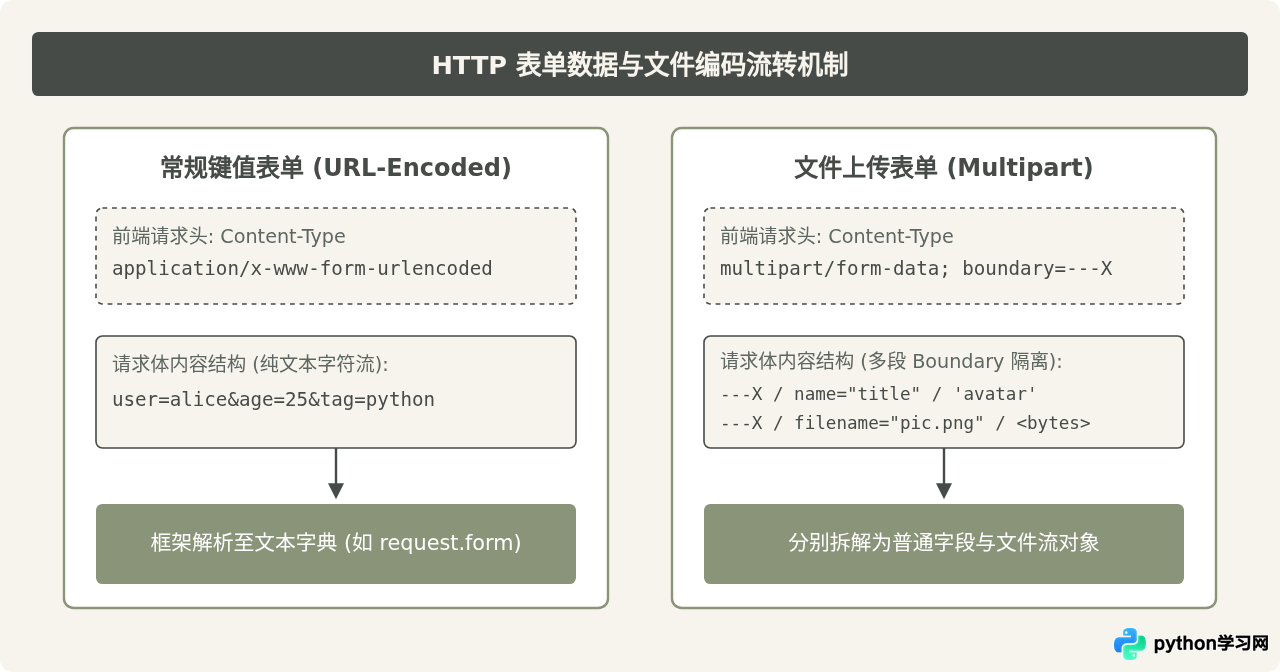
当浏览器向 Web 服务器发送 POST 请求时,请求头中的 Content-Type 决定了数据如何组装与拆解。普通的表单提交默认采用 application/x-www-form-urlencoded,所有字段键值均经过 URL 编码后拼接为纯字符串(例如 username=admin&role=editor)。这种方式体积紧凑,但完全无法有效表达非文本的二进制文件内容。
一旦表单包含文件输入控件(<input type="file">),前端必须显式指定 enctype="multipart/form-data"。在该格式下,请求体被一个随机生成的 boundary 分隔字符串切分为若干独立部分。每个部分包含自己的小型头部(说明该字段的名称、上传时的原始文件名和 MIME 类型)与对应的数据正文。Web 框架正是依据这些 Boundary 来分别提取文本字段与文件字节流的。
二、主流框架下的接收与实现代码
在 Python Web 开发中,Flask 和 FastAPI 具有代表性。虽然它们语法与设计理念有所不同,但在解析表单时均遵循标准规范:将普通键值和文件流对象分别暴露给开发者。
1. Flask 中的表单与文件处理
在 Flask 中,普通文本字段通过 request.form 访问,而上传的文件则封装为 Werkzeug 的 FileStorage 对象,存放在 request.files 中。
from flask import Flask, request, jsonify
from werkzeug.utils import secure_filename
import os

app = Flask(__name__)
UPLOAD_DIR = "/path/to/secure_storage"
os.makedirs(UPLOAD_DIR, exist_ok=True)

@app.route("/api/submit", methods=["POST"])
def handle_form_and_file():
    # 1. 提取常规表单文本数据
    username = request.form.get("username", "").strip()
    category = request.form.get("category", "default")

    if not username:
        return jsonify({"error": "用户名不能为空"}), 400

    # 2. 检查是否有文件控件
    if "attachment" not in request.files:
        return jsonify({"error": "缺少文件字段"}), 400

    file_obj = request.files["attachment"]

    # 用户未选择文件时 filename 为空
    if file_obj.filename == "":
        return jsonify({"error": "未选择任何上传文件"}), 400

    # 3. 清洗文件名并安全保存
    clean_name = secure_filename(file_obj.filename)
    save_path = os.path.join(UPLOAD_DIR, clean_name)
    file_obj.save(save_path)

    return jsonify({
        "status": "success",
        "user": username,
        "saved_file": clean_name
    })
2. FastAPI 中的异步声明式处理
FastAPI 基于 Pydantic 与 Starlette,使用类型声明注入依赖。接收表单时需使用 Form(...),接收文件时推荐使用 UploadFile。UploadFile 支持异步读取且内部使用 SpooledTemporaryFile,当文件尺寸小于临界值时保留在内存,超过后自动滚入临时磁盘文件,避免内存爆满。
from fastapi import FastAPI, UploadFile, File, Form, HTTPException
import shutil
import os
from pathlib import Path

app = FastAPI()
STORAGE_PATH = Path("/path/to/storage")
STORAGE_PATH.mkdir(parents=True, exist_ok=True)

@app.post("/api/upload")
async def upload_document(
    title: str = Form(...),
    document: UploadFile = File(...)
):
    if not document.filename:
        raise HTTPException(status_code=400, detail="未提供有效文件名")

    destination = STORAGE_PATH / Path(document.filename).name

    # 使用流式方式逐块拷贝,避免全量读入内存
    with open(destination, "wb") as buffer:
        shutil.copyfileobj(document.file, buffer)

    return {
        "title": title,
        "filename": document.filename,
        "content_type": document.content_type
    }
三、文件上传的四大核心安全防线与规范步骤
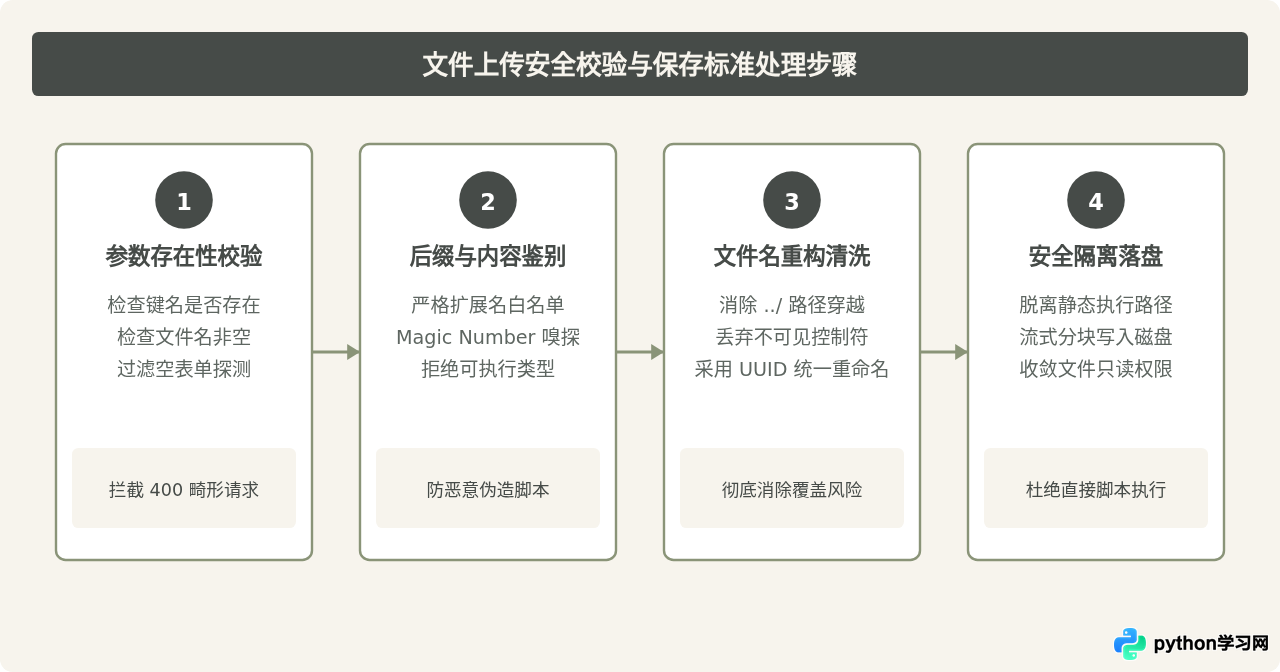
处理用户上传的文件属于高危操作。直接信任客户端提供的文件名或未经校验保存文件,极易导致任意文件覆盖、目录遍历或远程代码执行漏洞。安全保存文件必须经过四道严格的防御处理。
1. 扩展名白名单与文件签名(Magic Number)检验
客户端提交的 Content-Type 极易被爬虫或抓包工具篡改(例如将 shell.php 伪装为 image/jpeg)。因此,绝对不能仅凭请求头断定文件类型。
生产环境下应采用“扩展名严格白名单 + 文件头幻数嗅探”的双重判断机制。利用标准库或第三方库(如 python-magic 或纯 Python 的轻量魔数比对)验证前几个字节是否与预期类型一致:
ALLOWED_EXTENSIONS = {'.png', '.jpg', '.jpeg', '.gif', '.pdf'}

# 常见图片格式的魔数头部特征
MAGIC_SIGNATURES = {
    b'\x89PNG\r\n\x1a\n': '.png',
    b'\xff\xd8\xff': '.jpg',
    b'%PDF': '.pdf'
}

def validate_file_content(file_stream, filename):
    ext = os.path.splitext(filename)[1].lower()
    if ext not in ALLOWED_EXTENSIONS:
        return False, "不允许的文件扩展名"

    # 读取前 16 字节检测特征签名
    header = file_stream.read(16)
    file_stream.seek(0)  # 务必重置指针,避免后续保存时内容丢失

    is_valid_type = any(header.startswith(sig) for sig in MAGIC_SIGNATURES)
    if not is_valid_type:
        return False, "文件内部魔数与声明格式不符"

    return True, "校验通过"
2. 文件名重构与路径安全
攻击者常尝试在文件名中夹带 ../../../../etc/passwd 这类路径遍历字符,或者包含系统保留字符。即使使用 secure_filename 将文件名规范化,如果直接保留原始文件名,仍存在重名覆盖和多语言编码兼容问题。
推荐策略是:服务端丢弃原始文件名作为存储名,使用全局唯一标识符(UUID)加合法后缀进行重新命名。原始文件名如果需要展示给用户,应单独存入数据库对应字段。
import uuid

def generate_safe_filename(original_name):
    # 提取经过小写化的安全后缀
    ext = os.path.splitext(original_name)[1].lower()
    # 生成随机无序的新文件名,彻底杜绝路径穿越与重名
    return f"{uuid.uuid4().hex}{ext}"
四、大文件处理与性能优化:流式传输 vs 内存驻留
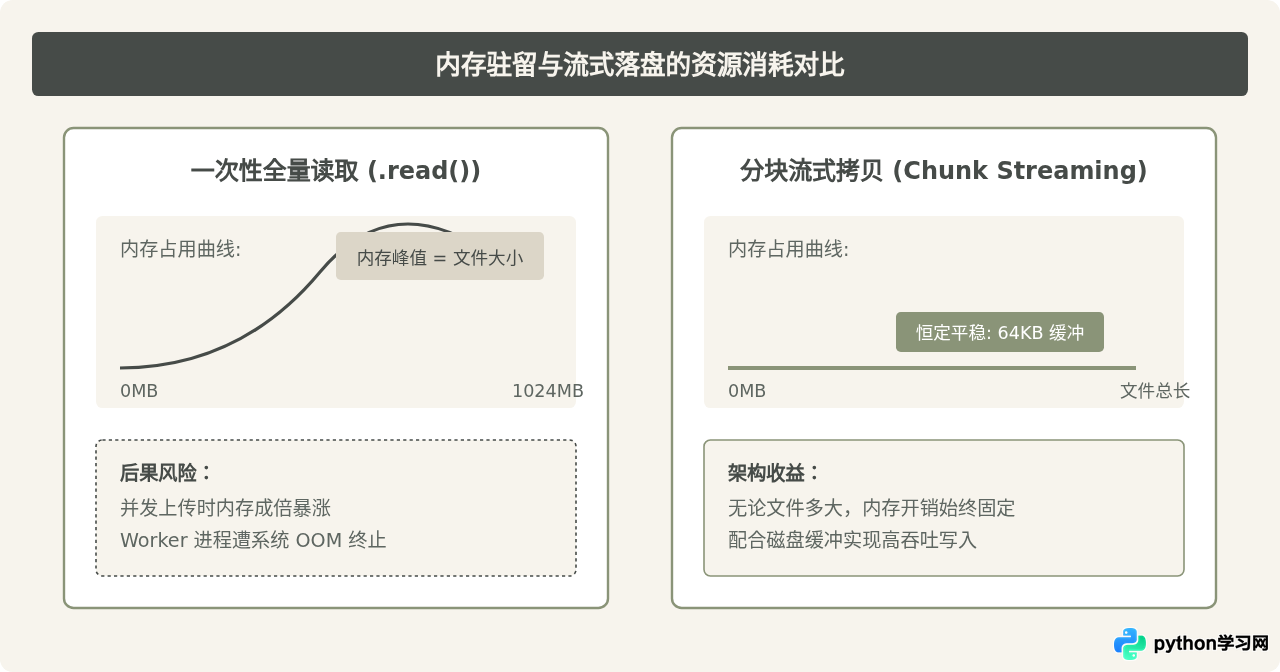
在处理上传文件时,最容易造成服务器宕机的原因是直接读取整个文件进入内存。如果开发者在代码中执行 content = file_obj.read(),对于 1GB 的视频文件,这 1GB 的数据将直接被加载进当前工作进程的物理内存中。当多个用户并发上传时,服务器可用内存会瞬间被耗尽并触发系统的 OOM(Out Of Memory)杀进程保护。
流式读取与写入最佳实现
正确的做法是设置一个合理的缓冲区大小(如 64KB 或 1MB),采用边读边写的方式:
def save_stream_chunked(source_stream, target_path, chunk_size=65536):
    """
    以 64KB 缓冲区分块流式写入,保持常数级物理内存消耗
    """
    with open(target_path, "wb") as target:
        while True:
            chunk = source_stream.read(chunk_size)
            if not chunk:
                break
target.write(chunk)如果生产环境使用 Nginx 代理 Python 应用(如 Gunicorn / Uvicorn),Nginx 默认限制上传包体为 1MB。若上传超过该大小,前端会直接收到
413 Request Entity Too Large 错误,且请求根本不会到达 Python。必须在 Nginx 配置中对应设置:
client_max_body_size 50M;
五、容易混淆的认知辨析
在日常开发与代码审查中,常能遇到一些看似合理但存在安全漏洞或设计缺陷的做法:
-
误区一:“只要在前端用
accept='.jpg,.png'限制了,后端就可以免做文件校验。”
辨析:前端的 HTML 属性限制和 JavaScript 校验纯粹属于提升用户体验的辅助手段,能够帮正常用户快速发现选错的文件。但 HTTP 请求本质上是无状态的原始网络流,任何攻击者都能使用 curl、Postman 或 Python 脚本直接组装含有.py或.sh脚本的 POST 请求绕过浏览器限制。因此,所有后端必须将来自客户端的输入视作完全不可信。 -
误区二:“只要通过
secure_filename()清洗过文件名,就可以直接作为最终文件名保存。”
辨析:secure_filename的核心功能是剔除可能引发路径穿越的特殊控制符和相对路径符号(如../),使字符串变为单纯的文件名。但如果两个用户先后上传同名文件(例如avatar.png),后上传的文件就会无声无息地覆盖先上传的文件。更为安全的工业级标准是:生成 UUID 作为磁盘文件名,同时将原始用户友好名称存储在数据库记录中。 -
误区三:“把上传文件存放在静态目录(如 Flask 的 static 文件夹)最方便用户直接访问。”
辨析:将用户上传的文件直接丢进由 Web 服务器或应用直接提供静态访问且具备执行权限的目录极其危险。一旦有恶意用户绕过校验上传了可解析的动态文件(或包含恶意脚本的 HTML/SVG 导致存储型 XSS),攻击者就可以直接通过浏览器访问该 URL 触发漏洞。安全的做法是将上传目录设置在 Web 根目录之外,通过专用的下载接口验证权限后,以send_from_directory或 Nginx 内部重定向(X-Accel-Redirect)流式输出。
六、实践总结与全景对照
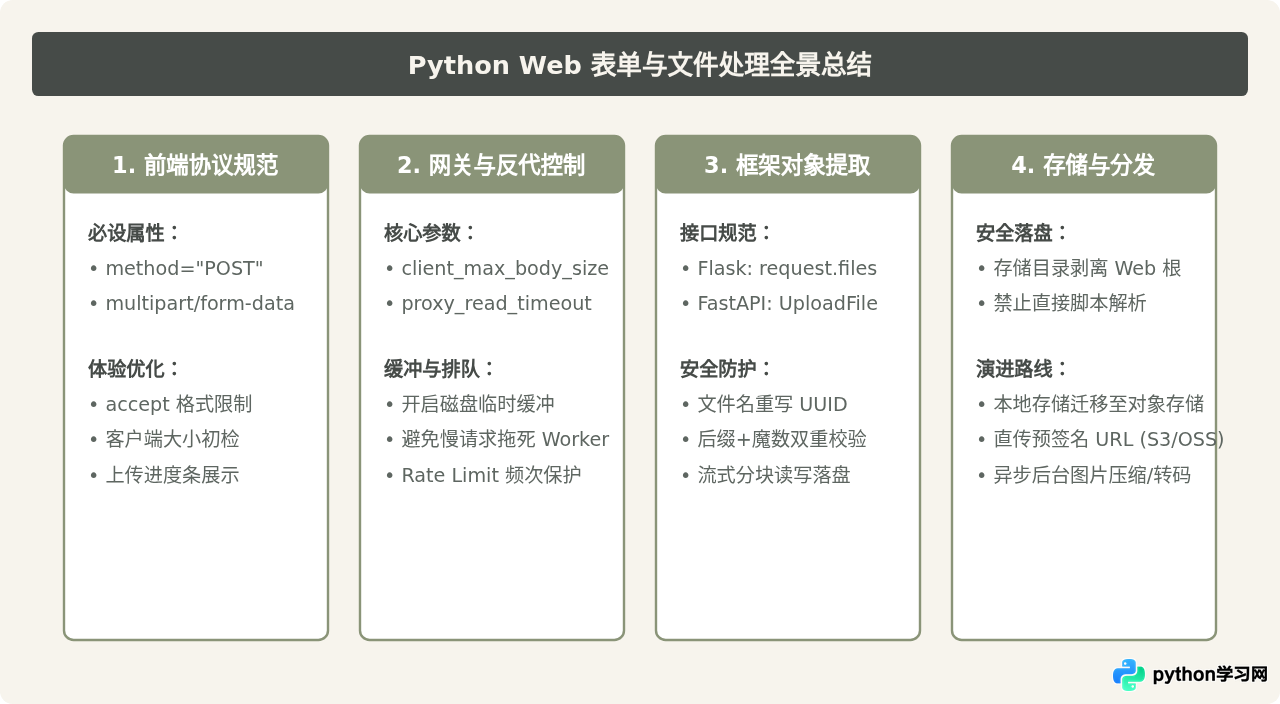
处理表单与文件上传是一个贯穿“协议层-网关层-框架层-存储层”的系统性工程。只要把握住“编码区分”、“白名单校验”、“流式持久化”与“权限隔离”四个基本点,就能构建出既健壮又安全的上传服务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









