

Python列表推导式批量提取符合规则的元素
本文详细讲解如何使用Python列表推导式高效、优雅地批量提取符合特定规则的列表元素,涵盖基础语法、复合条件、数据清洗及常见注意事项。
在日常数据处理中,从集合中快速筛选出符合特定条件的元素是一项极为高频的任务。Python 提供了列表推导式(List Comprehension)这一原生语法特性,允许开发者用一行声明式代码代替繁冗的 for 循环与条件判断,直接完成元素提取与过滤。本文将从核心语法构成、多重规则组合、类型与文本清洗等实用场景展开,详细拆解如何高效运用列表推导式完成批量元素提取。
一、核心语法与执行逻辑拆解
常规的批量提取逻辑通常包含三个要素:数据源、遍历过程、以及筛选条件。如果使用常规的 for 循环,我们需要先定义一个空列表,逐项检查元素是否满足要求,再通过 append() 方法追加。而列表推导式则将这个完整过程浓缩在方括号内,其标准筛选形式如下:
[目标表达式 for 变量 in 原始序列 if 过滤条件]在这个结构中,if 过滤条件 充当过滤网。Python 在遍历 原始序列 时,会逐一计算条件表达式的值。只有当条件结果为 True 时,对应的变量才会传递给最前面的 目标表达式,最终收集到生成的新列表中。
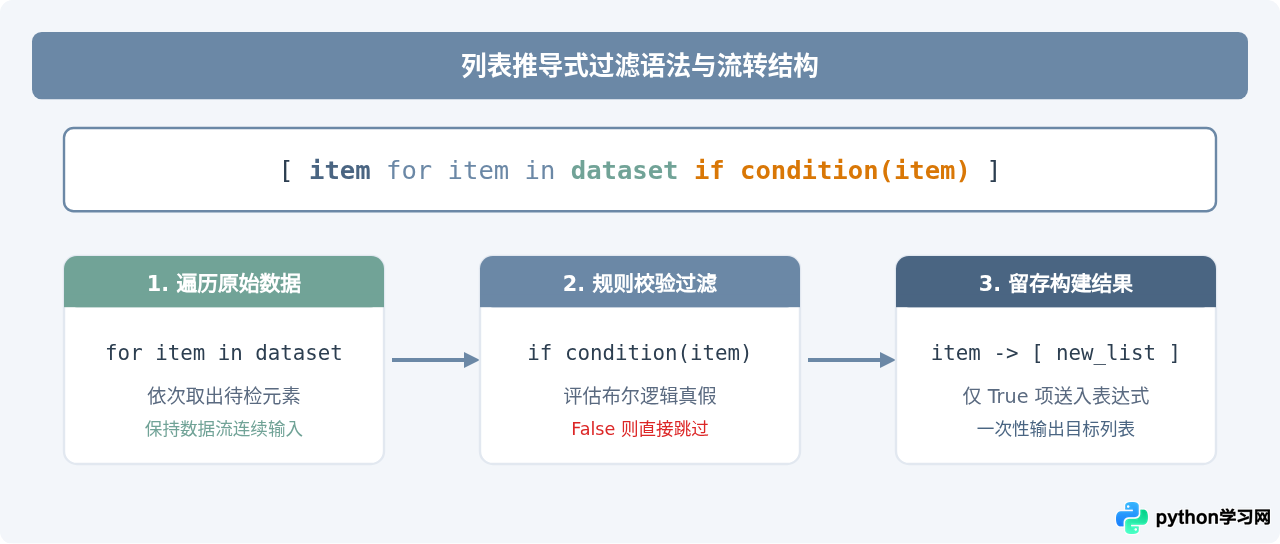
以提取列表中的所有偶数为例,通过列表推导式可以直观写出:
numbers = [12, 7, 19, 24, 30, 5, 8]

# 批量提取满足“被2整除”的元素
evens = [n for n in numbers if n % 2 == 0]

print(evens)  # 示例输出: [12, 24, 30, 8]
二、推导式与传统循环机制对比
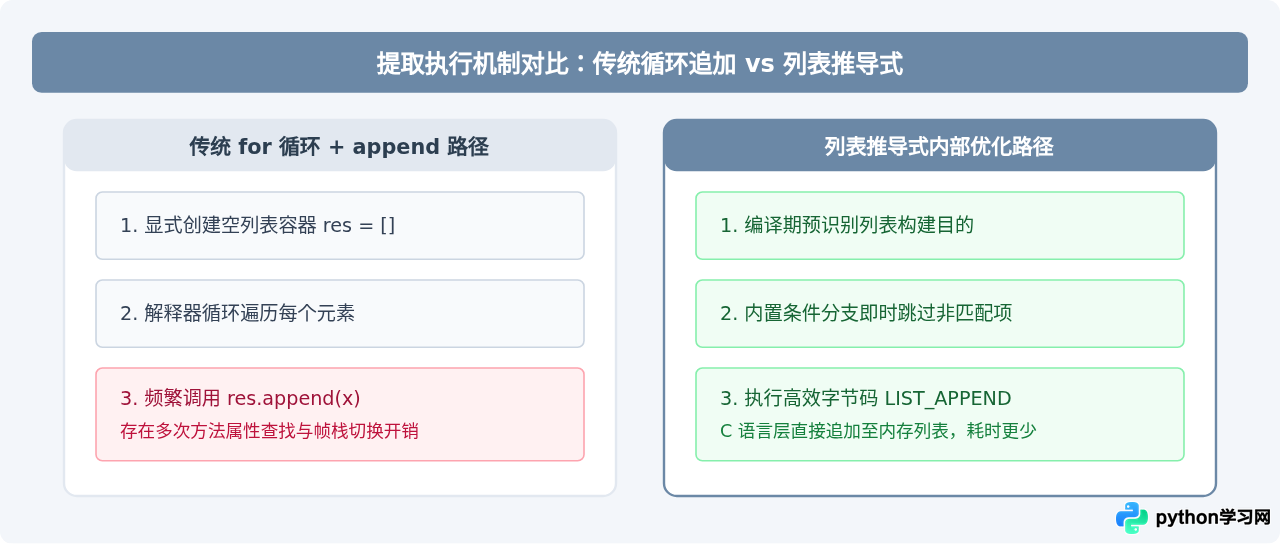
很多开发者初学时会疑惑:推导式除了书写简短外,相比常规循环还有什么实质区别?
在性能层面,传统 for 循环每次执行 list.append() 时,都在进行 Python 层面的方法查找与函数调用。而列表推导式在编译为字节码后,直接调用了底层的 LIST_APPEND 指令,循环状态维护也在 C 层面完成,省去了运行时的动态查找开销。此外在代码表达上,列表推导式是声明式的——它直接向读者说明“产物是什么样的元素子集”,而非交代具体的迭代步骤与装填过程。
三、批量提取实战:复合规则与数据清洗
在实际应用中,筛选规则往往不止一个简单的数值判断。常见的场景包括多条件组合、针对文本特征的提取以及脏数据过滤。
1. 复合条件逻辑提取(与/或运算)
若需要同时满足多个条件,可以在 if 子句中使用标准的布尔运算符 and 或 or,也可以直接链式编写多个 if(多个连续 if 等价于 and 逻辑)。
records = [15, -3, 82, 45, 0, 98, -12, 60]

# 提取正数中大于等于 50 的及格/高分值(and 组合)
high_scores = [x for x in records if x > 0 and x >= 50]
print(high_scores)  # 示例输出: [82, 98, 60]

# 也可以连续写多个 if,效果完全等价
high_scores_alt = [x for x in records if x > 0 if x >= 50]
print(high_scores_alt)  # 示例输出: [82, 98, 60]
2. 文本规则与前缀/后缀提取
在处理日志、路径或名称列表时,可以借助字符串的内置方法(如 startswith()、endswith()、isalnum() 等)作为过滤规则:
file_list = ["data.csv", "report.pdf", "image.png", "notes.txt", "data_backup.csv", "raw.CSV"]

# 批量提取所有 CSV 文件名(忽略大小写)
csv_files = [f for f in file_list if f.lower().endswith(".csv")]
print(csv_files)  # 示例输出: ['data.csv', 'data_backup.csv', 'raw.CSV']
3. 混合类型数据的守卫与清洗
真实数据集中常包含 None、非预期数据类型或空字符。在提取目标元素前,通常需要设置“前置守卫规则”以防止报错(例如对 None 调用方法会导致 AttributeError):
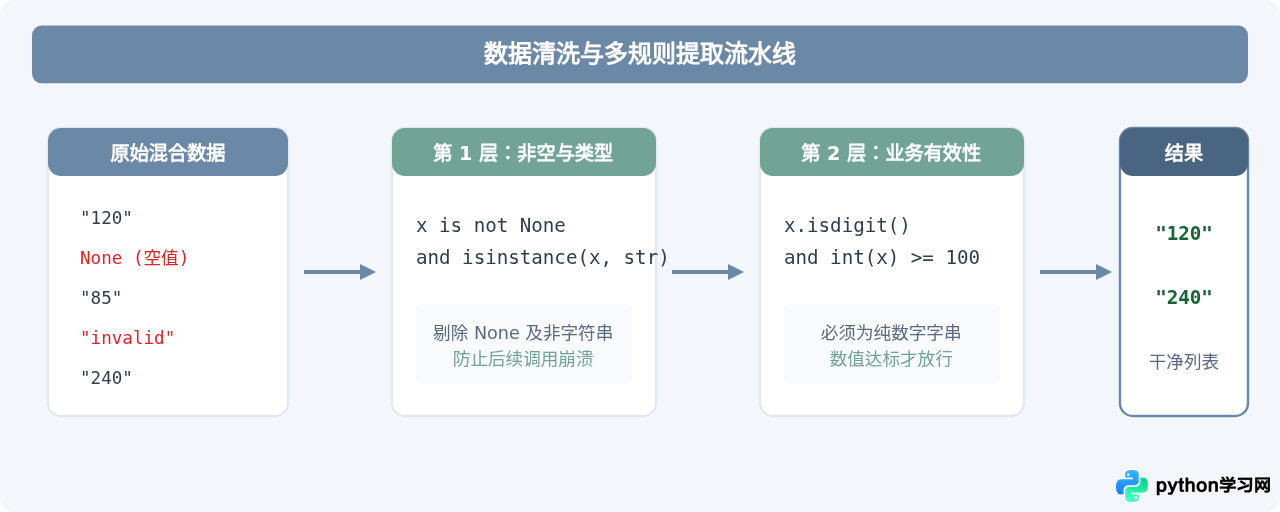
对应的 Python 实现代码如下:
raw_entries = ["120", None, "85", "invalid", "240", "", 500]

# 安全提取:非空、必须为字符串、全数字且数值不低于 100
valid_items = [
    item for item in raw_entries
    if item is not None
    if isinstance(item, str)
    if item.isdigit() and int(item) >= 100
]

print(valid_items) # 示例输出: ['120', '240']if 或使用 and 连接的条件遵循“短路求值”机制。确保将基础类型判断(如 item is not None、isinstance(...))写在前面,能够避免后续方法调用在空对象或错误类型上引发异常。
四、易混淆语法:条件过滤 vs 三元转换
很多初学者容易将“条件过滤”与“条件转换(三元表达式)”混淆,误将 if-else 放在末尾而导致语法错误:
- 末尾的 if 是过滤规则:
[x for x in data if 条件]。只有满足条件的元素才会被提取,不满足的直接丢弃,列表长度可能会变短。末尾不能加else。 - 开头的 if-else 是映射转换:
[表达式1 if 条件 else 表达式2 for x in data]。每个元素都会被保留,只是根据条件转换为不同的形式,列表长度保持不变。
data = [10, 15, 20, 25]

# 1. 过滤提取:只留下大于 15 的数(长度变为 2)
filtered = [x for x in data if x > 15]
print(filtered)  # 示例输出: [20, 25]

# 2. 映射转换:大于 15 的保留原值,否则标记为 0(长度依旧为 4)
transformed = [x if x > 15 else 0 for x in data]
print(transformed)  # 示例输出: [0, 0, 20, 25]
五、使用建议与场景决策
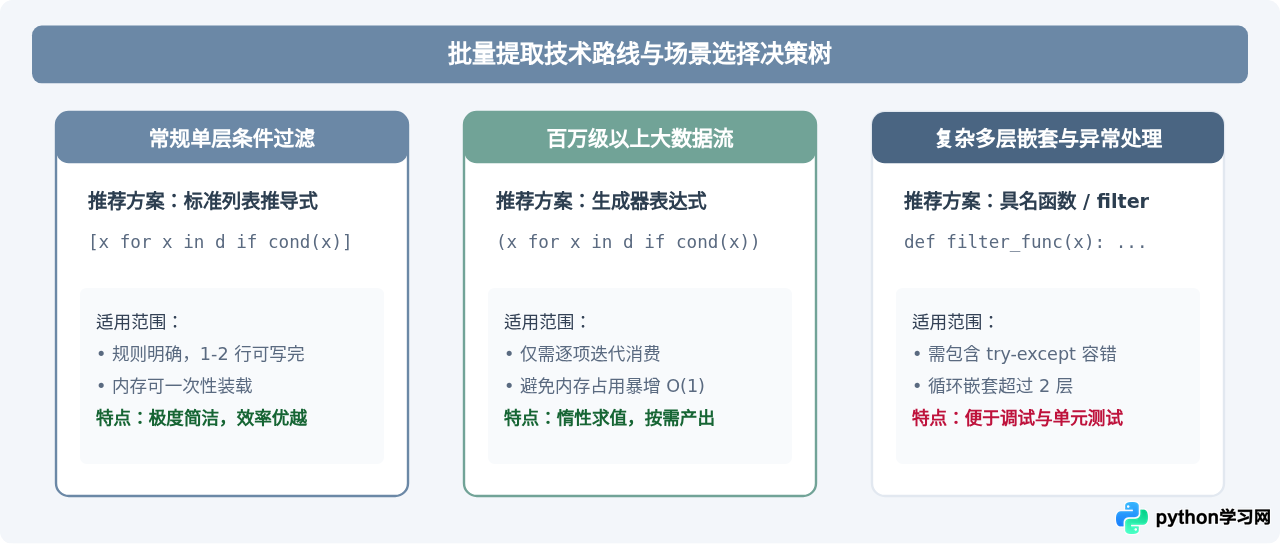
列表推导式虽然精简高效,但并非适合所有提取场景。根据数据规模、逻辑复杂度和内存要求,选择合适的技术手段能够保证代码的可读性与健壮性。
实践总结
- 优先表达意图: 对于中小型列表的规则提取,优先使用
[x for x in data if 条件]。语法直观且执行速度快。 - 警惕过度紧凑: 当单条推导式跨越超过两行或出现复杂的嵌套三元操作时,应主动拆分为常规函数配合循环,保证团队协同的可维护性。
- 善用生成器: 若提取出的元素仅用于遍历求和(如
sum(...))或逐行写入文件,可将方括号换为圆括号(...),以极低的内存开销完成流式处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









