

Python嵌套数据结构遍历:当字典值包含列表时怎么处理
深入讲解在Python中遍历“字典的值为列表”这一常见嵌套数据结构的方法,涵盖标准双重循环、列表推导式、边界防御及多层复杂嵌套处理。
dict.items()),再通过内层循环依次访问列表内部的每一个元素。
一、认识“字典值包含列表”的数据结构
在日常开发与数据处理任务中,我们经常遇到一对多的分组关系。例如用户与其拥有的权限列表、班级与其学生名单、商品分类与其下的商品编号。这类数据在Python中通常表示为键为字符串或数字、值为列表的字典结构。
下面是一个典型的示例数据:
department_members = {
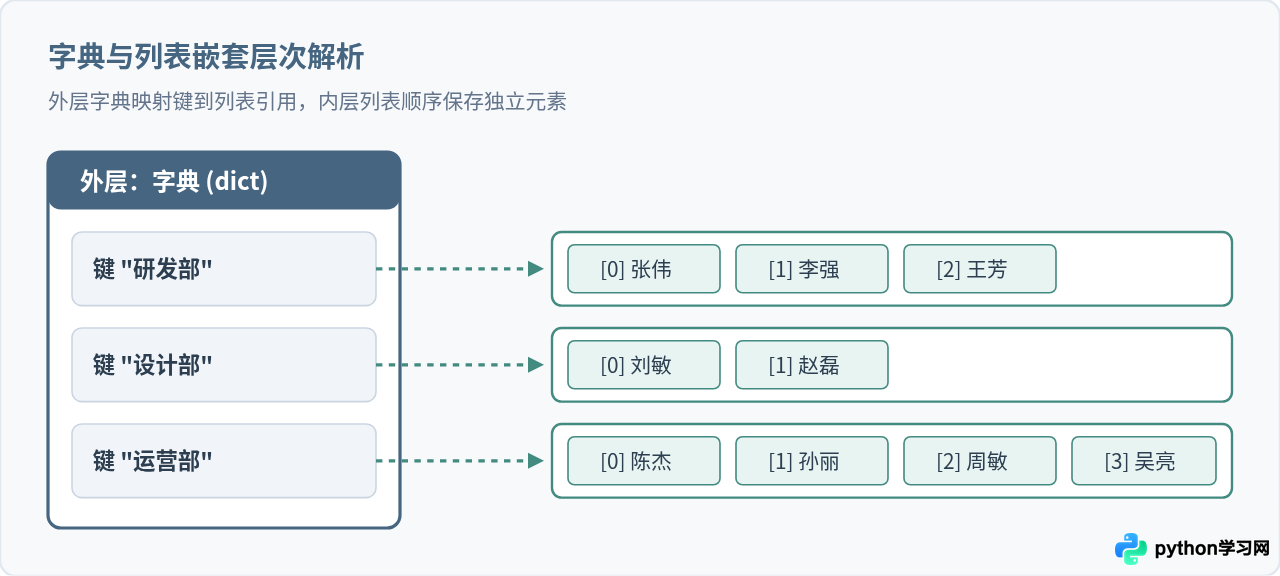
    "研发部": ["张伟", "李强", "王芳"],
    "设计部": ["刘敏", "赵磊"],
    "运营部": ["陈杰", "孙丽", "周敏", "吴亮"]
}
外层的字典负责根据分类键(如“研发部”)组织分组;内层的列表则保持顺序并存储具体的值。理解这层逻辑关系,是设计合理遍历逻辑的基础。
二、基础解法:标准双重循环
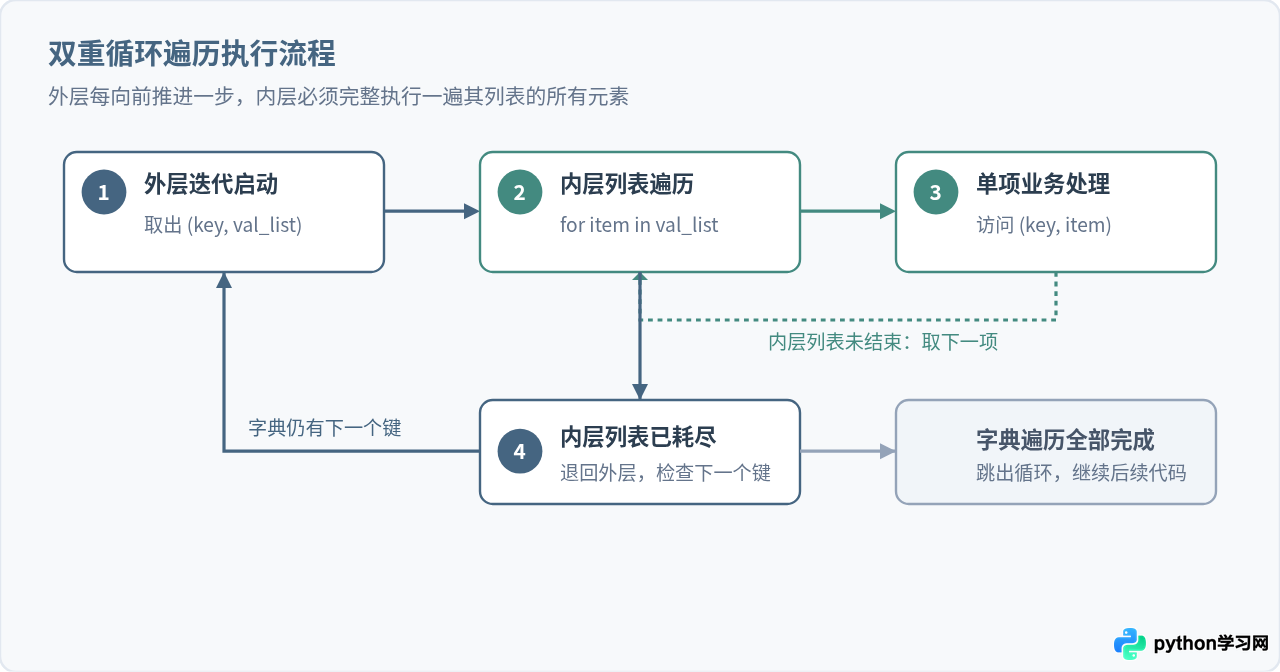
遍历这种结构的最核心工具是两层嵌套的 for 循环。外层负责解开字典,内层负责解开列表。
1. 使用 .items() 同步获取键与列表
在遍历字典时,推荐直接调用 .items() 方法,这样可以在外层循环迭代时同时解包出部门名称(Key)与该部门对应的列表对象(Value)。紧接着在内层循环中,直接对该列表对象进行常规迭代。
department_members = {
    "研发部": ["张伟", "李强", "王芳"],
    "设计部": ["刘敏", "赵磊"],
    "运营部": ["陈杰", "孙丽", "周敏", "吴亮"]
}

for dept, members in department_members.items():
    print(f"【{dept}】共有 {len(members)} 人:")
    for member in members:
        print(f"  - 姓名: {member}")
示例输出:
【研发部】共有 3 人:
  - 姓名: 张伟
  - 姓名: 李强
  - 姓名: 王芳
【设计部】共有 2 人:
  - 姓名: 刘敏
  - 姓名: 赵磊
【运营部】共有 4 人:
  - 姓名: 陈杰
  - 姓名: 孙丽
  - 姓名: 周敏
  - 姓名: 吴亮
2. 循环执行机制与步骤推导
为了直观展现双重循环在执行过程中的状态转移,下图展示了从外层取键值对,到内层迭代推进,再返回外层的整个流水线过程:
3. 需要索引时的处理方式:使用 enumerate
如果业务不仅需要元素本身,还需要知道该元素在当前列表中的次序(例如生成排名或序号),可以在内层使用 enumerate():
for dept, members in department_members.items():
    print(f"{dept} 排序名单:")
    for index, member in enumerate(members, start=1):
        print(f"  第 {index} 位: {member}")
三、常见衍生需求与实用模式
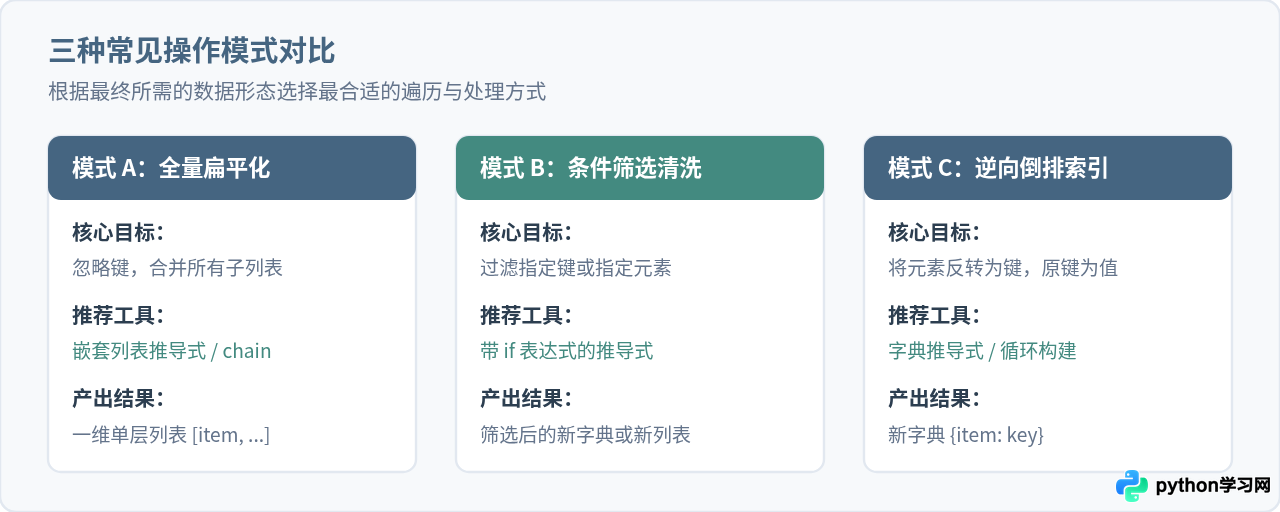
在实际工程中,除了逐行打印外,针对此类结构通常有以下三种典型的高频操作需求:提取扁平化列表、带条件过滤筛选、构建逆向映射字典。
1. 模式 A:将所有子列表打平为单个列表
如果你不需要保留部门归属,仅仅想把所有员工姓名汇总到一个列表里,有两种高效写法。
方法一:嵌套列表推导式
# 语法顺序与双重循环书写顺序一致:先外后内
all_members = [
    member
    for members in department_members.values()
    for member in members
]
print(all_members)
# 示例输出: ['张伟', '李强', '王芳', '刘敏', '赵磊', '陈杰', '孙丽', '周敏', '吴亮']
方法二:使用标准库 itertools.chain
对于数据量较大的场景,使用 itertools.chain.from_iterable 是性能极优的迭代器合并方式:
from itertools import chain

all_members_iter = chain.from_iterable(department_members.values())
# 转换或直接遍历
for member in all_members_iter:
    pass # 逐个惰性处理,无额外内存开销
2. 模式 B:带条件的筛选提取
在遍历过程中,我们可以对键(分类)或值(列表内单项)施加过滤条件。例如:只提取“运营部”以外的且字数大于等于3个字符的姓名:
filtered_result = []

for dept, members in department_members.items():
    if dept == "运营部":
        continue  # 跳过运营部
    for member in members:
        if len(member) >= 2:
            filtered_result.append((dept, member))
3. 模式 C:构建逆向映射(倒排字典)
当频繁需要通过“人名”快速查询“所在部门”时,原有的 {部门: [人名]} 查询效率为 O(N)。通过遍历,我们可以构建一个 {人名: 部门} 的反向字典,使后续查询变为 O(1):
person_to_dept = {
    member: dept
    for dept, members in department_members.items()
    for member in members
}

print(person_to_dept["赵磊"])
# 示例输出: 设计部
四、边界场景与防御性编程
在读取外部 JSON、数据库或第三方 API 时,数据可能并不像预想的那样规范。直接运行双重循环可能引发异常,以下列出必须防范的三大常见边界问题。
1. 字典值为 None 或其他非列表类型
当某个键的值是 None 或数值时,直接进入内层 for item in members: 会抛出 TypeError: 'NoneType' object is not iterable。
isinstance(members, (list, tuple, set)) 进行类型检查,或者使用 or [] 提供保底默认值。
dirty_data = {
    "组A": ["小明", "小红"],
    "组B": None,           # 脏数据:为 None
    "组C": [],             # 空列表
    "组D": "不是列表"       # 脏数据:字符串
}

for group, members in dirty_data.items():
    # 安全判断:确保为列表或元组,并且不为空
    if isinstance(members, list):
        for member in members:
            print(f"{group} - {member}")
    else:
        print(f"警告:{group} 的数据格式非列表,已跳过处理。")
2. 遍历中切勿直接修改正在迭代的容器
如果在遍历列表的过程中直接使用 members.remove(item),由于列表索引的实时变动,会导致部分元素被跳过。如果修改字典键本身,甚至会抛出 RuntimeError: dictionary changed size during iteration。
members[:] 上进行安全遍历。
五、多层复杂嵌套:当列表内还包含字典
在真实业务(如电商订单或接口报文)中,嵌套层级可能继续延伸:字典的值是列表,列表里的每个元素又是一个字典。例如:
company = {
    "技术部": [
        {"name": "张伟", "role": "架构师", "skills": ["Python", "Go"]},
        {"name": "李强", "role": "前端", "skills": ["Vue", "TypeScript"]}
    ],
    "市场部": [
        {"name": "王芳", "role": "策划", "skills": ["SEO", "文案"]}
    ]
}面对更深层次的结构,核心原则依然不变:由外向内逐层解包。每一层循环对应一层容器类型(字典看 items,列表看下标或元素):
for dept, staff_list in company.items():
    print(f"=== {dept} ===")
    for staff in staff_list:
        name = staff.get("name")
        role = staff.get("role")
        skills = ", ".join(staff.get("skills", []))
        print(f"  员工: {name} | 职位: {role} | 技能: {skills}")
六、遍历策略决策与总结
为了在实际编写代码时快速决定采用哪种遍历方式,可参考下面的决策路线图:
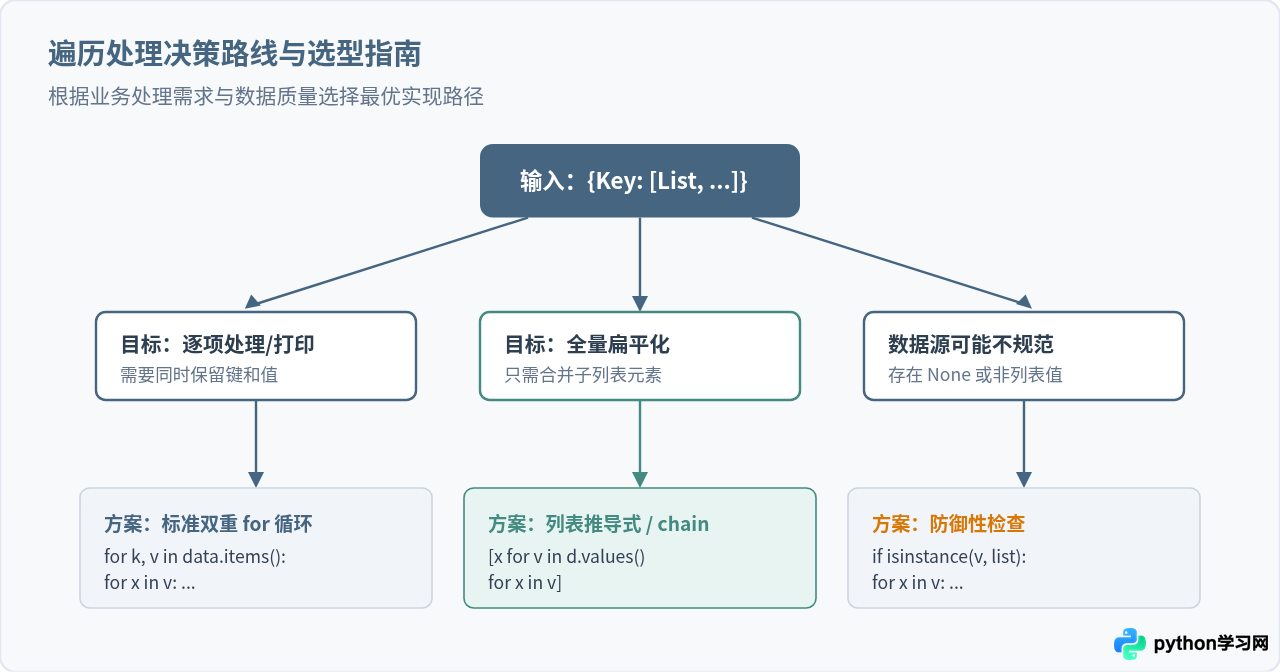
| 应用场景 | 推荐语法形式 | 优势与适用边界 |
|---|---|---|
| 分级展示、逐行写入、复杂逻辑处理 | for k, v in d.items(): |
最易读、调试方便,支持对键和单项进行完整操作 |
| 获取全体元素合并列表 | [x for v in d.values() for x in v] |
语法紧凑,运行速度快,适合纯数据转换 |
| 大数据量合并(内存敏感) | itertools.chain.from_iterable(d.values()) |
惰性求值,避免一次性生成大列表占用内存 |
| 构建值到键的反查索引 | {x: k for k, v in d.items() for x in v} |
将后续查询时间复杂度由 O(N) 降至 O(1) |
| 外部非信任数据源 | 加入 isinstance(v, list) 过滤 |
避免 NoneType 异常,增强工程健壮性 |
综上所述,当字典的值包含列表时,核心思路是“外层解字典、内层解列表”。在日常编写中,优先保证数据类型安全,再根据最终需要的数据结构选择最直接的循环或推导式即可稳健处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









