

数据分析项目应该用哪个Python版本最稳妥
针对数据分析项目如何选择最稳妥的Python版本进行深入剖析,对比主流版本生命周期、核心三方库支持现状,提供版本评估流程与实操配置建议。
开展一个新的数据分析项目时,直接采用“当前最新发布的Python版本减去1到2个小版本”(即 N-1 或 N-2 原则)是最稳妥的选择。具体到当前生产与分析实践,Python 3.11 或 Python 3.12 是兼具成熟生态与执行性能的黄金版本。盲目追新会导致核心科学计算库缺少预编译轮子(Wheel)而安装失败,而坚守已停止维护的陈旧版本则会面临安全缺陷以及无法使用新算法库的窘境。
一、为什么数据分析对Python版本要求如此苛刻?
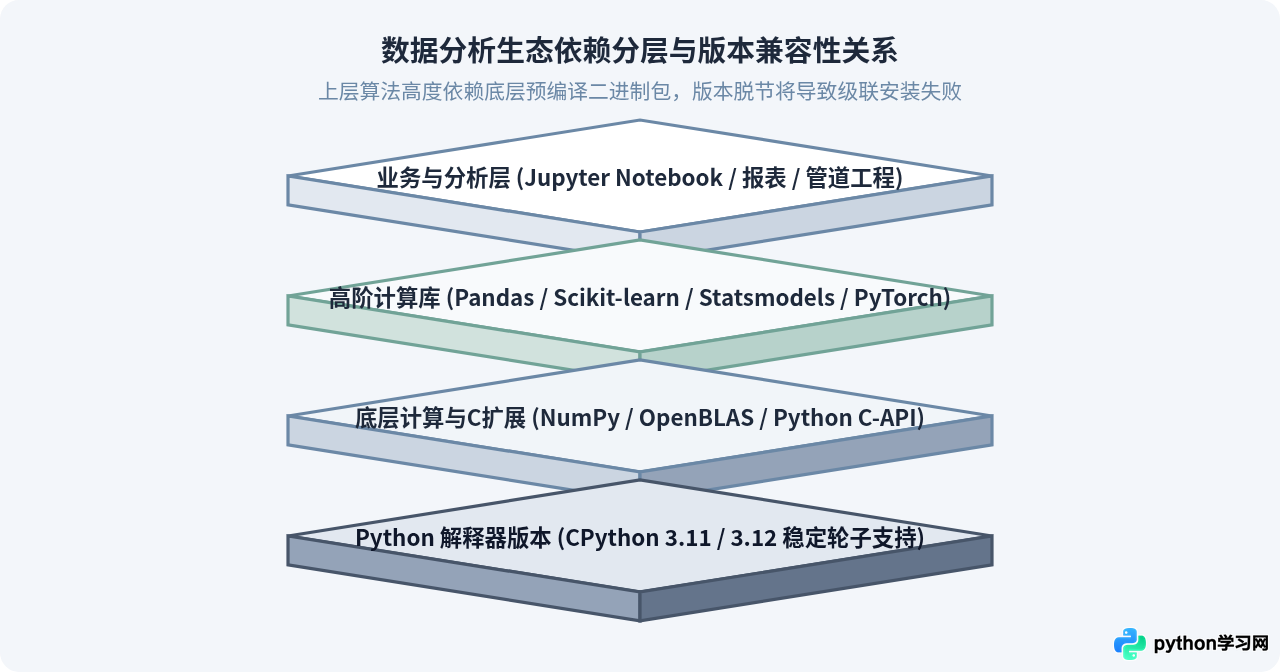
常规的Web开发或自动化脚本往往能轻松迁移至最新的Python版本,但数据分析领域的底层逻辑截然不同。数据分析强依赖于NumPy、Pandas、SciPy、Scikit-learn、PyTorch等基础计算框架。这些库的核心运算逻辑大多使用C、C++、Cython或Fortran编写,以突破Python自身的GIL锁和性能瓶颈。
当官方发布新的Python次版本(例如Python 3.13)时,底层的C API往往会有变动甚至重大调整。三方库作者需要时间重新编译针对各大操作系统(Windows、macOS、Linux各个架构)的预编译二进制包(Wheel)。如果在缺少Wheel的环境下直接通过pip install安装,系统将尝试调用本地C/C++编译器进行源码编译。本地缺失对应编译链或依赖头文件时,安装流程便会直接报错中断。
二、主流Python版本生命周期与支持现状评估
评估一个版本是否“稳妥”,不能单看个人喜好,必须依据Python官方的生命周期支持策略(PEP 602)以及主要三方库(NEP 29等约定)的支持范围。
| Python 版本 | 官方状态 | 科学计算库兼容性 | 稳妥等级与建议 |
|---|---|---|---|
| Python 3.8 及更早 | 已彻底停更 (EOL) | 主流新版本库已停止支持 | 极不建议,存在严重漏洞风险 |
| Python 3.9 / 3.10 | 仅安全更新阶段 | 全面兼容,但性能较低 | 老项目维护可选,新项目不优先推荐 |
| Python 3.11 | 维护期 (Bugfix/Security) | 各平台Wheel极为齐全,性能提升显著 | 极度推荐 (最稳妥候选之一) |
| Python 3.12 | 常规活跃维护期 | 全部主流库已提供预编译包 | 极度推荐 (当前及未来兼顾首选) |
| Python 3.13 / 3.14 | 最新发布 / 开发中 | 大量计算与GPU库尚在适配中 | 暂不稳妥,仅限实验尝鲜 |
1. 为什么推荐 Python 3.11 和 3.12?
第一,生态全面就绪。无论是NumPy 2.x、Pandas 2.x还是LightGBM、XGBoost、PyTorch等机器学习扩展,均已在PyPI上提供了针对Linux、macOS(含Apple Silicon)和Windows的Wheel包。安装耗时仅需几秒钟,杜绝编译故障。
第二,原生性能飞跃。Python官方自3.11起启动了“Faster CPython”项目,在字节码内联缓存、函数调用优化等方面做了大幅重构,常规Python数据清洗与循环处理比3.10提速10%~30%以上。兼顾了稳定性与运行效率。
三、如何为你的数据分析项目确定确切版本?
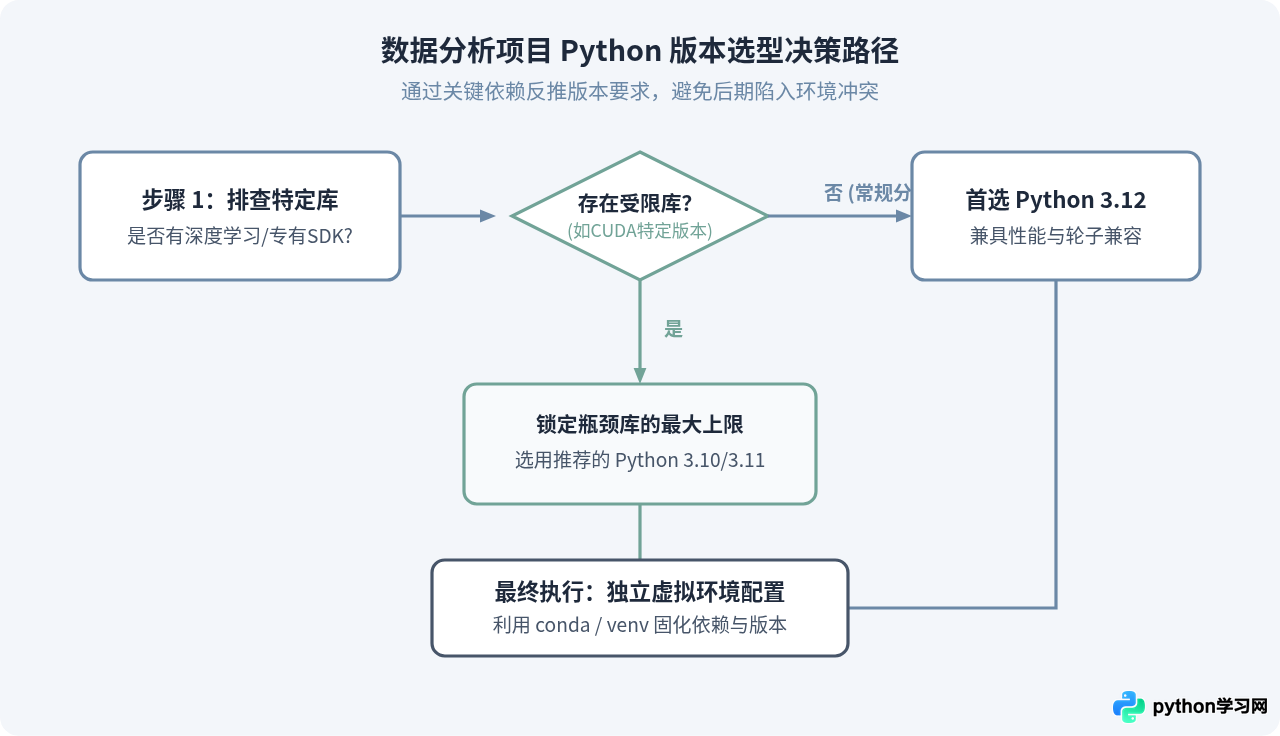
在实际工程中,团队可以按照以下决策路径来确定版本。该流程从最严苛的硬件依赖和专有模型包入手,逐步向下收敛到通用的Python版本。
四、配置稳妥运行环境的标准操作步骤
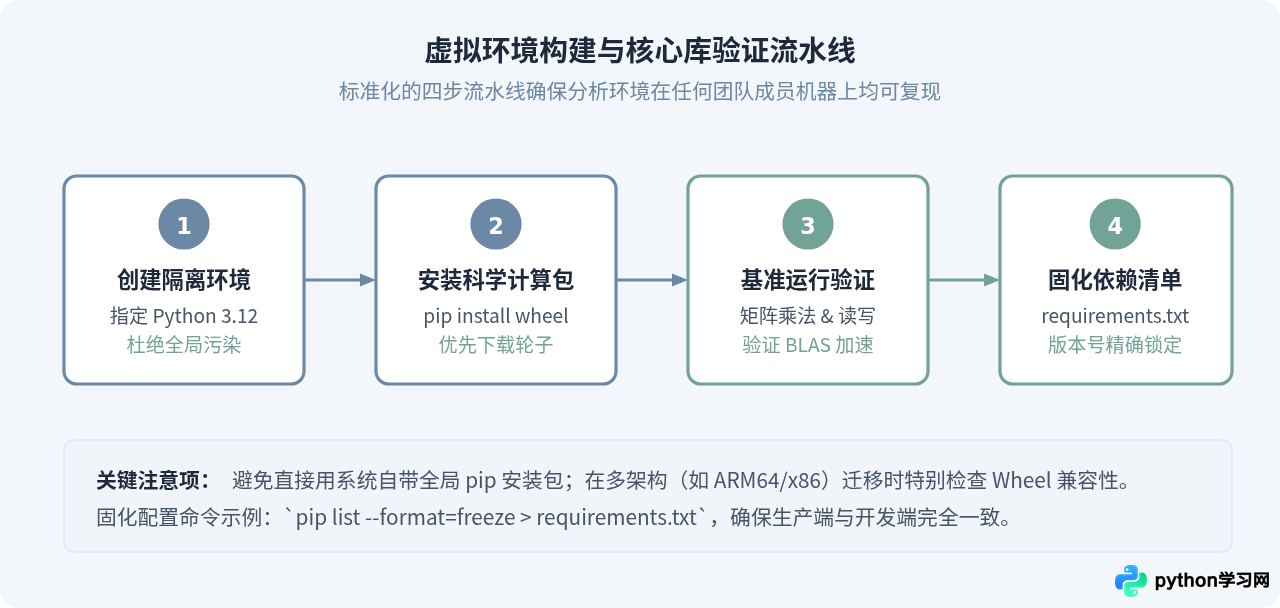
决定了采用的版本后,绝不能直接使用系统自带的全局Python环境。数据分析项目中保持“稳妥”的关键实践是:为每个项目建立专属的隔离虚拟环境。
步骤 1:安装环境管理器并创建指定版本的环境
推荐使用基于 Miniconda 或 pyenv + venv 的环境管理工具。以 Conda 为例,在终端执行以下命令创建以 Python 3.12 为基准的环境:
# 1. 创建名为 data_project 且指定 python=3.12 的隔离环境
conda create -n data_project python=3.12 -y

# 2. 激活新建的环境
conda activate data_project
运行完成后,可以通过执行 python --version 确认当前环境的Python解释器版本:
# 示例预期输出:
Python 3.12.7
步骤 2:安装基础分析库并验证预编译轮子
在已激活的虚拟环境中,直接通过包管理器安装核心依赖:
pip install numpy pandas matplotlib seaborn scikit-learn jupyterlab在安装控制台输出中,观察下载的文件名后缀。如果显示 Downloading ...-cp312-cp312-manylinux...whl 或 ...win_amd64.whl,说明成功命中了官方预编译的Wheel包,没有在本地执行编译,安装过程稳定可靠。
步骤 3:编写测试脚本验证核心运行库
在项目中创建简单的验证脚本 check_env.py:
import sys
import numpy as np
import pandas as pd

print(f"当前Python版本: {sys.version.split()[0]}")
print(f"NumPy版本: {np.__version__}")
print(f"Pandas版本: {pd.__version__}")

# 执行简单的向量计算以验证底层BLAS链接
arr = np.random.randn(1000, 1000)
res = np.dot(arr, arr)
print(f"运算验证成功,矩阵均值: {res.mean():.4f}")
执行该脚本后输出版本号及正常数值,即表明当前Python版本与底层数学运算库完全协同,可以安心开始业务分析代码的编写。
五、常见避坑指南与总结
pip install pandas 时,往往会遇到海量红字编译错误。请主动前往 Releases 列表,选择已经经过数轮小版本修复(如 3.12.5+)的成熟版本。
最后,我们将版本稳妥性的决策准则精炼为一套速记模型:
- 基准选择:首选 Python 3.12(针对日常表格清洗、可视化分析、通用机器学习)。
- 保守后退:如果有特殊的深度学习框架驱动或历史专有库,后退至 Python 3.11。
- 防线坚守:永远不跨越至尚未完成 Wheel 全覆盖的尝鲜版本(如刚发布的次版本),坚决淘汰已停止维护的 EOL 版本。
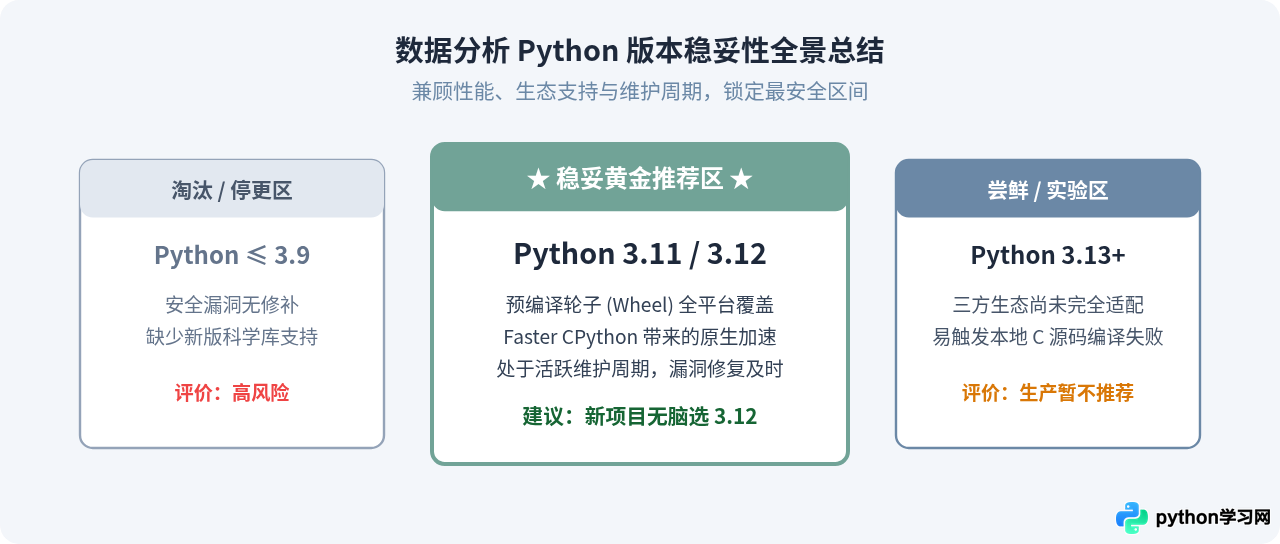
只要遵循“首选稳妥版本、使用隔离虚拟环境、固化依赖版本”这三大准则,数据分析项目便能将因Python解释器版本带来的环境冲突和排错成本降到最低,让精力集中在数据洞察与业务建模本身。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









