

怎么在Python矩阵的指定行或列插入新数据

在 Python 中对矩阵进行指定行或列的插入操作,核心取决于矩阵的数据载体是 NumPy 数组 还是 原生嵌套列表。在科学计算与数据分析场景中,矩阵通常使用 NumPy 的二维数组表示,标准做法是调用 np.insert() 函数,通过指定 axis=0 插入行、指定 axis=1 插入列;如果是在纯原生 Python 环境中使用嵌套列表(list of lists),行插入可以直接使用列表内置的 insert() 方法,列插入则需要结合列表推导式逐行插入元素。本文将结合具体的代码、维度匹配规则和示意图,逐项介绍两类场景的操作方法与关键细节。
一、理解矩阵插入的轴向与维度机制
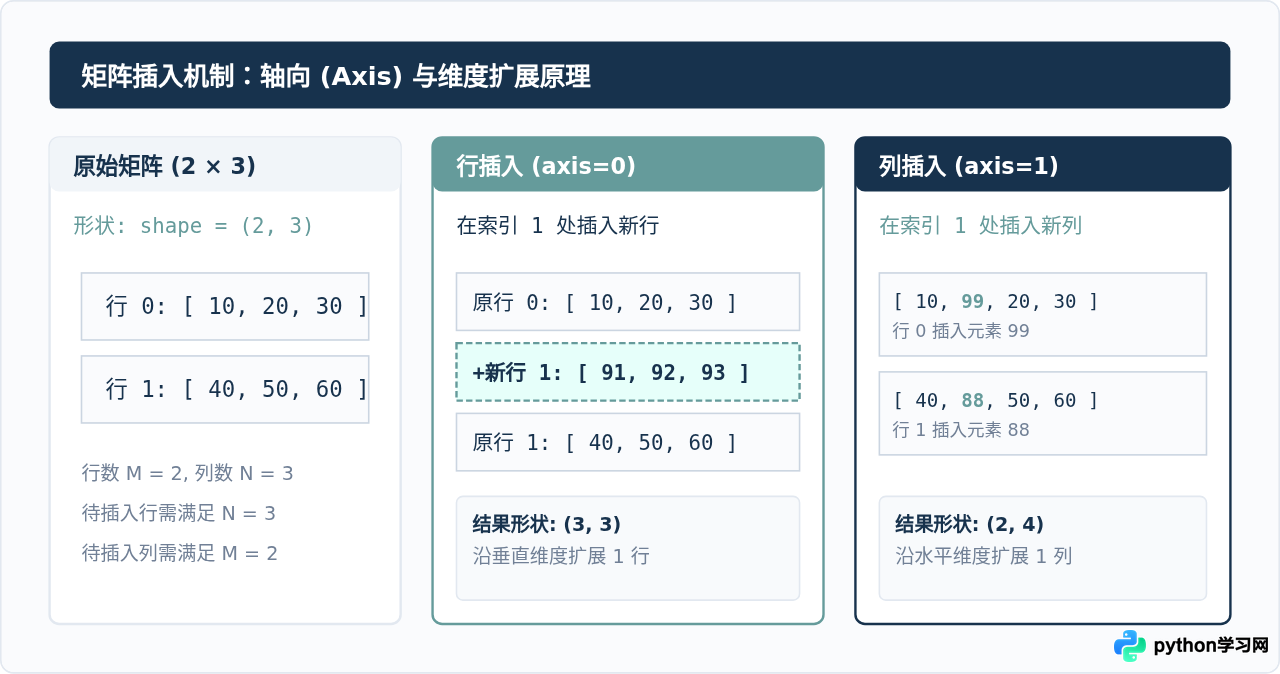
在向矩阵插入数据前,理解两个关键概念是避免报错的前提:插入轴(Axis) 与 维度对齐(Shape Match)。在 NumPy 的二维矩阵中,第 0 轴(axis=0)代表行方向,沿垂直方向移动;第 1 轴(axis=1)代表列方向,沿水平方向移动。
当插入新行时,待插入数据的元素数量必须与矩阵原有的列数一致;当插入新列时,待插入数据的元素数量必须与矩阵原有的行数一致。如果数据维度与既有矩阵边界不匹配,Python 将无法确定广播或填充的方式,进而抛出形状异常。
二、使用 NumPy 的 np.insert() 插入行或列
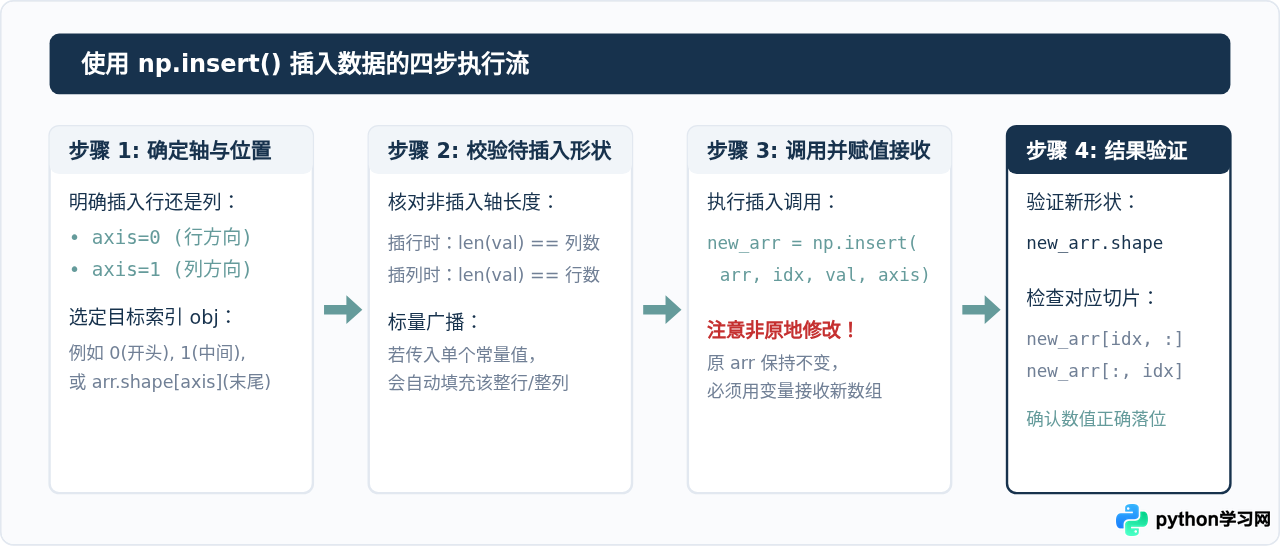
NumPy 提供了专门的数组插入接口 numpy.insert(arr, obj, values, axis=None)。其中各参数的定义如下:
arr:输入的源矩阵(ndarray)。obj:插入的目标索引位置。例如传入0表示插在最前,传入1表示插在第 1 项之后成为新索引 1,支持负数索引。values:准备插入的数据。可以是一维数组、同形状的切片或标量(支持广播)。axis:指定的维度轴。axis=0代表行,axis=1代表列。若不传则会将数组展平后插入。
1. 在指定行插入新行(axis=0)
假设我们有一个 2×3 的矩阵,希望在第 1 行位置(即原有第 0 行和第 1 行之间)插入一行新数据 [70, 80, 90]:
import numpy as np

# 1. 创建 2x3 的初始矩阵
matrix = np.array([
    [10, 20, 30],
    [40, 50, 60]
])

# 2. 定义待插入的新行,元素个数必须与当前矩阵的列数(3)一致
new_row = np.array([70, 80, 90])

# 3. 指定在索引 1 处插入行 (axis=0)
result_matrix = np.insert(matrix, 1, new_row, axis=0)

print("插入新行后的矩阵:")
print(result_matrix)
print("新矩阵形状:", result_matrix.shape)
示例输出如下:
插入新行后的矩阵:
[[10 20 30]
 [70 80 90]
 [40 50 60]]
新矩阵形状: (3, 3)
2. 在指定列插入新列(axis=1)
同样对于上述 2×3 的矩阵,如果希望在第 2 列位置插入一列新数据,该新列必须拥有 2 个元素(与行数对应)。此时可以传入一维序列或列向量:
import numpy as np

matrix = np.array([
    [10, 20, 30],
    [40, 50, 60]
])

# 待插入的数据:包含 2 个元素,分别分配给第 0 行和第 1 行
new_col = np.array([99, 88])

# 在索引 2 处插入新列 (axis=1)
result_matrix = np.insert(matrix, 2, new_col, axis=1)

print("插入新列后的矩阵:")
print(result_matrix)
print("新矩阵形状:", result_matrix.shape)
示例输出如下:
插入新列后的矩阵:
[[10 20 99 30]
 [40 50 88 60]]
新矩阵形状: (2, 4)值得注意的是,np.insert 在 axis=1 插入一维列表 [99, 88] 时,会自动将其按顺序分配到各个行对应的列位置上,不需要手动通过 reshape(-1, 1) 转为二维列向量。
三、使用原生 Python 二维列表(Nested Lists)操作
如果不使用第三方库 NumPy,仅依靠标准库中的嵌套列表构建矩阵,插入行与列的实现方式存在本质差异。
1. 在二维列表中插入行
二维列表的外层本质是一个包含各行子列表的一维列表。因此,向矩阵插入整行只需直接调用外层列表的 insert(index, element) 方法即可,这属于原位修改操作:
# 初始二维列表(2x3 结构)
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

new_row = [70, 80, 90]

# 在索引 1 的位置插入整行(原地修改)
matrix.insert(1, new_row)

print("原生列表插入行结果:")
for r in matrix:
    print(r)
示例输出如下:
原生列表插入行结果:
[10, 20, 30]
[70, 80, 90]
[40, 50, 60]
2. 在二维列表中插入列
原生列表没有类似二维数组的“列”实体对象。矩阵的每一行都是独立的列表实例,要给矩阵插入一列,必须逐行遍历并在每行的指定索引处插入对应的元素:
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

# 准备插入的列数据,元素数量必须与当前行数(2)相同
new_col = [99, 88]
col_index = 1  # 打算插入在第 1 列的位置

# 方法 A:使用 for 循环原地修改各行
for row, val in zip(matrix, new_col):
    row.insert(col_index, val)

print("原生列表逐行修改插入列:")
for r in matrix:
    print(r)
如果希望像 NumPy 一样保持原列表不被破坏、生成一个新的列表副本,可使用列表推导式:
# 方法 B:使用列表推导式生成新矩阵副本
clean_matrix = [
    [10, 20, 30],
    [40, 50, 60]
]
new_col = [99, 88]
col_index = 1

new_matrix = [
    row[:col_index] + [val] + row[col_index:]
    for row, val in zip(clean_matrix, new_col)
]

print("生成新列表副本:")
for r in new_matrix:
    print(r)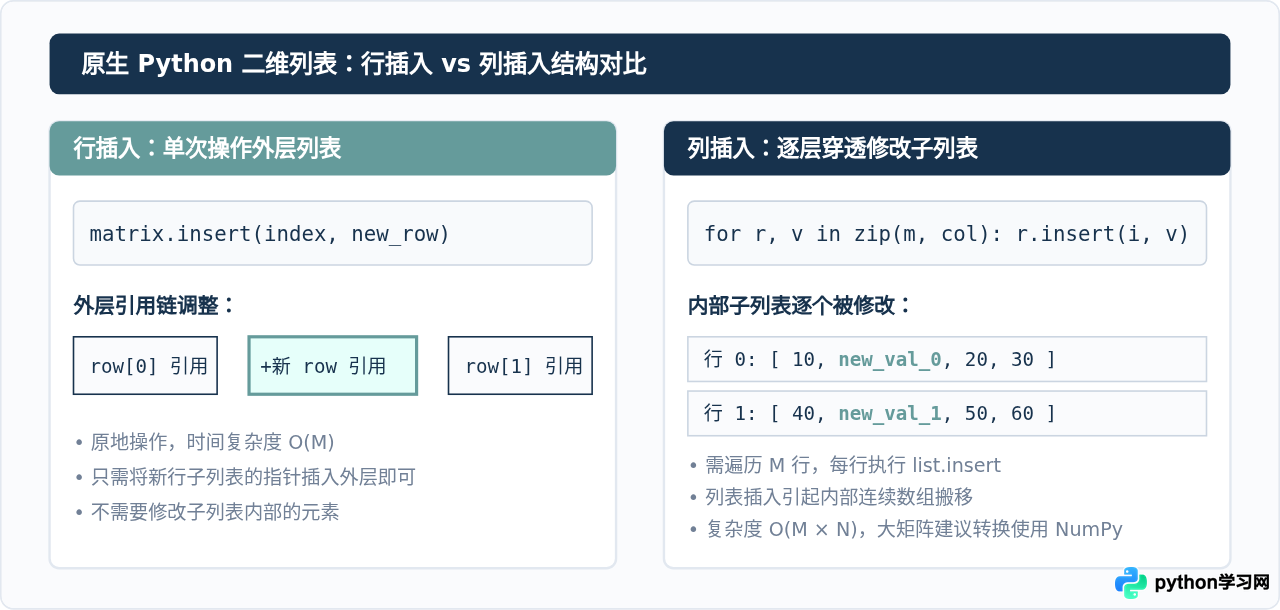
四、关键细节与常见避坑指南
避坑点 1:误以为 np.insert 是原地修改
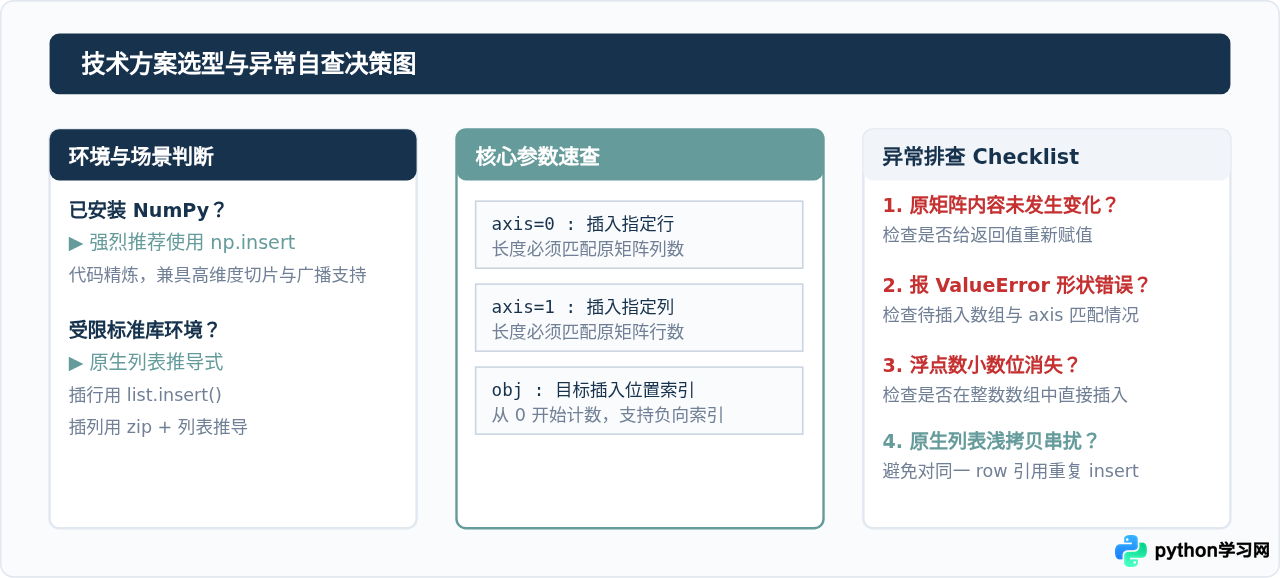
初学者极易写出 np.insert(matrix, 0, new_row, axis=0) 后直接打印 matrix 的代码,然后发现原矩阵毫无变化。NumPy 数组在内存中由一段固定大小的连续内存块支持,一旦初始化其总尺寸不可动态扩展。np.insert 在底层会申请一块更大的全新内存,将原数据和新数据拷贝进去,并返回新的数组副本。因此必须用变量接收返回值:matrix = np.insert(matrix, ...)。
避坑点 2:维度与轴向不匹配(ValueError: could not broadcast)
当向矩阵插入列时,若提供的数组长度不等于行数,会触发广播错误。例如一个 (2, 3) 矩阵在 axis=1 插入 [1, 2, 3],由于传入了 3 个元素而行数仅为 2,系统无法对齐维度。在调用前,务必先通过 matrix.shape 检查行数与列数。
避坑点 3:数据类型的隐式转换(dtype 统一性)
NumPy 数组要求所有元素必须保持相同的 dtype。若原矩阵为整型(如 int64),向其中插入包含小数的浮点数 3.14,新数据会被默认向下截断为整数 3,导致精度丢失。如需保留小数,应在插入前显式升级矩阵类型:matrix = matrix.astype(float)。
五、方案选型与总结
综合上述两种技术路径,下表列出了 NumPy 与原生二维列表在矩阵插入任务中的关键对比:
| 对比维度 | NumPy (np.insert) | 原生嵌套列表 (list of lists) |
|---|---|---|
| 适用场景 | 数值矩阵、科学计算、图像矩阵、大型数据处理 | 无需安装三方库、轻量脚本、异构数据 |
| 原地性 | 非原地修改,返回全新 ndarray 副本 | 行插入可原地修改;列插入需遍历修改或推导新列表 |
| 多行/多列插入 | 原生支持(obj 可传入切片或索引列表) |
需要多次调用或较为复杂的推导式逻辑 |
| 性能表现 | 底由 C 语言连续内存块优化,计算与搬移速度极快 | 指针寻址与频繁的内部数组平移,大规模数据较慢 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









