

除了Web和AI,Python还有哪些实用框架?爬虫与自动化运维框架介绍
一、网络数据采集:从静态解析到动态驱动
数据采集不仅是数据分析与模型训练的前提,也是竞品监测、内容聚合系统必不可少的基础设施。Python 的爬虫技术栈经历了从简单的 requests + BeautifulSoup 脚本,向模块化工业级采集框架与现代无头浏览器驱动演进的过程。
1. 工业级异步抓取中枢:Scrapy
Scrapy 是 Python 生态中最经典的工业级爬虫框架。它基于异步网络引擎 Twisted 构建,将请求调度、网络下载、数据解析与持久化存储完全解耦,具备极高的并发吞吐量与强大的扩展能力。
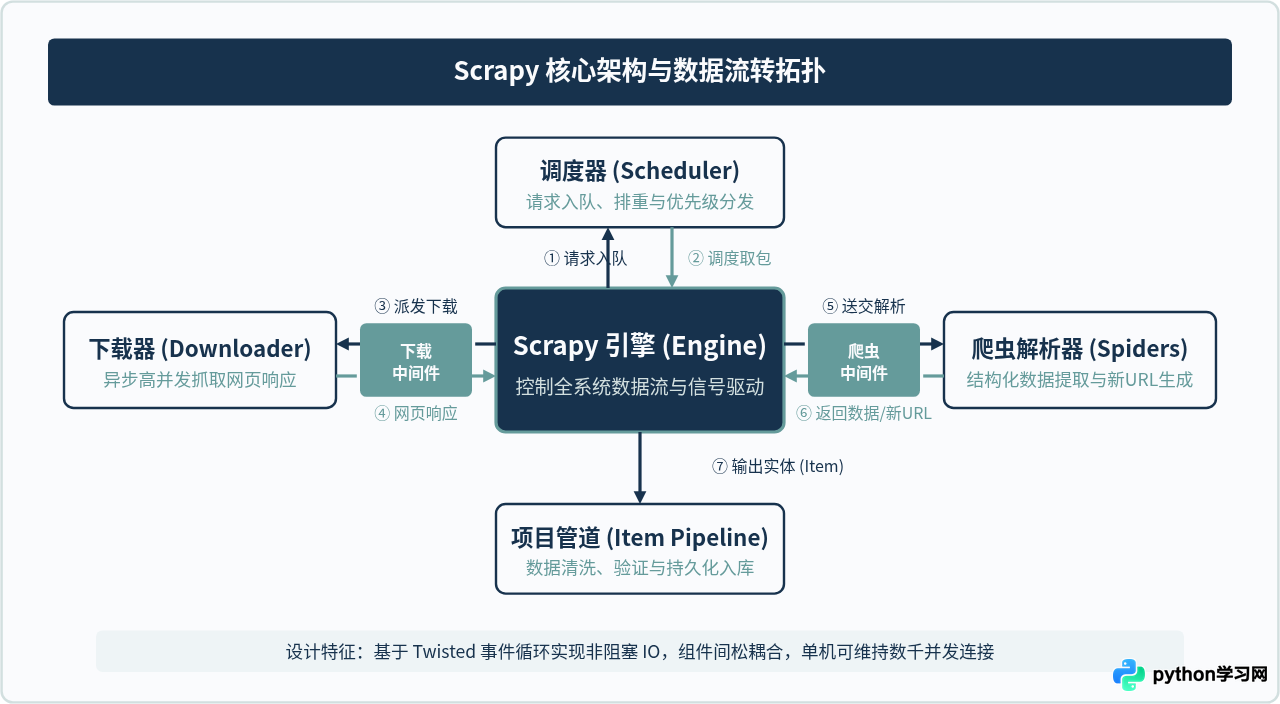
在 Scrapy 项目中,开发者通常只需关注两个核心部分:负责提取数据的 Spider 和负责存储清洗的 Pipeline。以下为一个抓取产品目录的最小化完整示例:
# myspider.py - 定义抓取规则与数据抽取
import scrapy

class ProductItem(scrapy.Item):
    title = scrapy.Field()
    price = scrapy.Field()
    url = scrapy.Field()

class CatalogSpider(scrapy.Spider):
    name = "catalog"
    start_urls = ["https://example.com/products?page=1"]

    def parse(self, response):
        # 使用 CSS 选择器解析列表项
        for card in response.css("div.product-card"):
            item = ProductItem()
            item["title"] = card.css("h2.title::text").get("").strip()
            item["price"] = card.css("span.price::text").get("").strip()
            item["url"] = response.urljoin(card.css("a::attr(href)").get(""))
            yield item

        # 自动翻页处理
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
抓取到的实体会直接流向 pipelines.py,完成去重与数据库写入:
# pipelines.py - 数据清洗与持久化
from scrapy.exceptions import DropItem

class PriceCleanerPipeline:
    def process_item(self, item, spider):
        price_raw = item.get("price", "")
        if not price_raw:
            raise DropItem(f"缺少价格字段: {item}")
        # 清洗特殊货币符号并转为浮点数
        cleaned_price = price_raw.replace("¥", "").replace(",", "").strip()
        try:
            item["price"] = float(cleaned_price)
        except ValueError:
            raise DropItem(f"非法价格格式: {price_raw}")
        return item
优势:高并发吞吐、低内存占用、生态成熟(拥有完善的代理管理、自动重试、User-Agent 轮换插件体系)。
局限:Scrapy 原生仅支持静态 HTTP 请求,对于由 React、Vue 构建或强依赖 JavaScript 动态渲染、Canvas 混淆的现代页面,无法直接获取 DOM,需要结合无头浏览器扩展(如 scrapy-playwright)。
2. 现代动态渲染与反爬突破:Playwright for Python
对于重度依赖前端渲染、复杂交互或 WebSocket 通信的目标站点,传统 HTTP 请求无法获取真实 DOM。微软开发的 Playwright 已成为当前 Python 动态抓取与自动化测试的事实标准,正逐步替代老旧缓慢的 Selenium。
与 Selenium 通过 WebDriver 协议远程驱动浏览器不同,Playwright 直接通过 Chrome DevTools Protocol (CDP) 以及对应内核协议与 Chromium、Firefox、WebKit 进程通信,原生支持异步 asyncio、网络请求拦截、自动智能等待(Auto-wait)与多上下文(BrowserContext)会话隔离。
# playwright_scraper.py - 异步动态渲染抓取示例
import asyncio
from playwright.async_api import async_playwright

async def scrape_dynamic_page():
    async with async_playwright() as p:
        # 启动无头 Chromium 浏览器实例
        browser = await p.chromium.launch(headless=True)
        # 创建独立上下文,可自定义视口尺寸与 User-Agent
        context = await browser.new_context(
            viewport={"width": 1280, "height": 800},
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        )
        page = await context.new_page()

        # 访问目标动态单页应用 (SPA)
        await page.goto("https://example.com/dashboard", wait_until="networkidle")

        # 等待异步渲染的骨架屏消失,目标列表可见
        await page.wait_for_selector("div.dynamic-item-list")

        # 提取渲染完成后的完整 DOM 内容
        cards = await page.locator("div.item-row").all()
        results = []
        for card in cards:
            name = await card.locator(".item-title").inner_text()
            metric = await card.locator(".item-value").inner_text()
            results.append({"name": name, "metric": metric})

        print(f"成功抓取动态渲染数据 {len(results)} 条")
        await browser.close()
        return results

if __name__ == "__main__":
    asyncio.run(scrape_dynamic_page())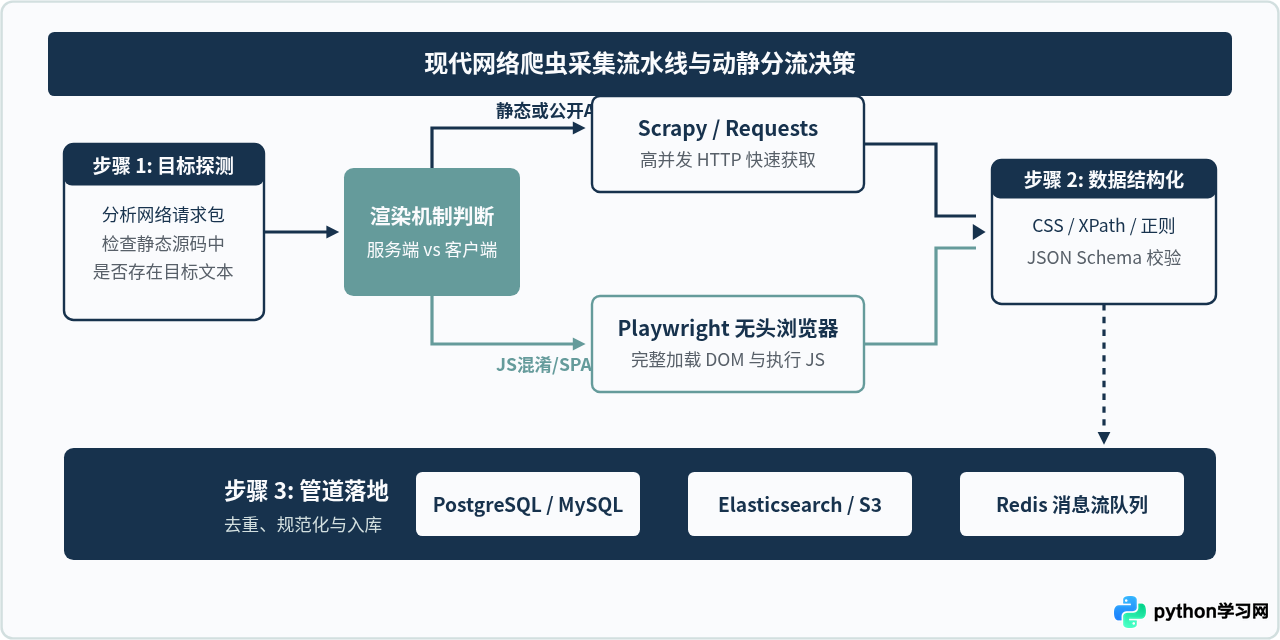
二、自动化运维:服务器配置、批量管理与异步编排
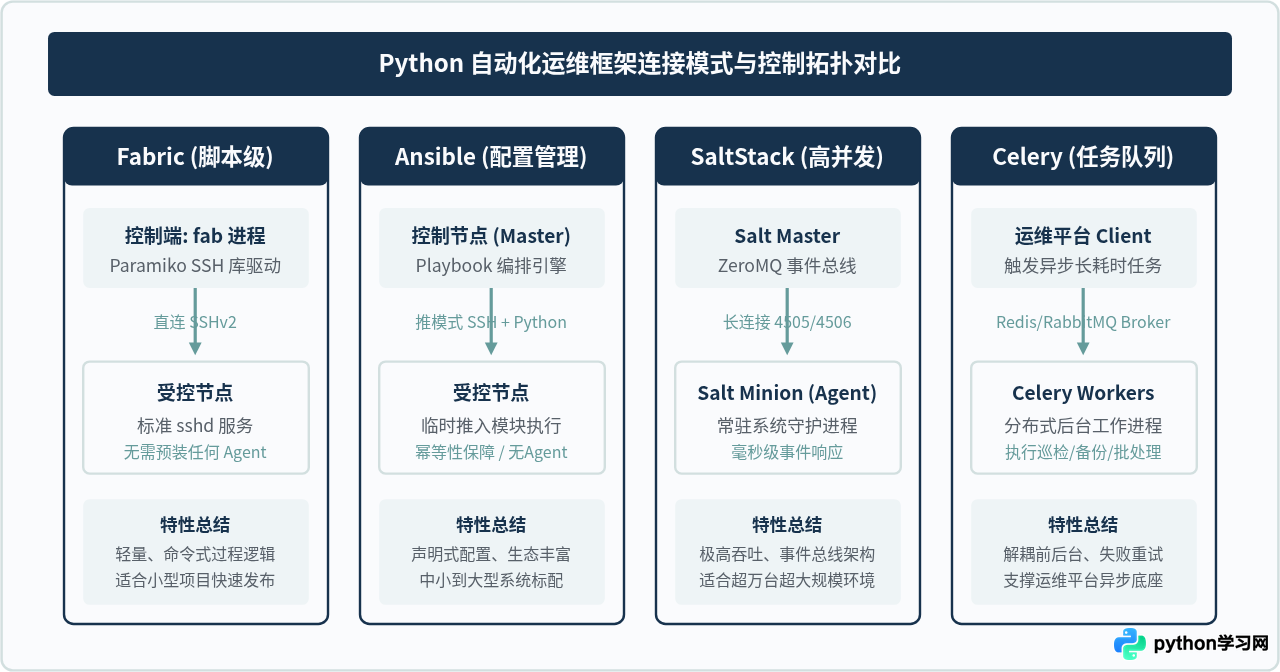
在云计算与微服务时代,数十台至上万台服务器的系统初始化、软件包管理、代码持续发布与状态检查如果依赖人工 SSH 登录,既不可持续且极易发生人为差错。Python 在运维领域诞生了多套具有统治地位的工具与框架,覆盖轻量自动化到超大规模高并发管理。
1. 声明式配置管理与批量执行标杆:Ansible
Ansible 虽然作为独立 CLI 工具广为人知,但其底层完全由 Python 编写,其核心模块与扩展均采用 Python 开发。Ansible 最大的技术优势在于无客户端(Agentless)架构:目标主机无需安装专用守护进程,控制节点只需通过原生 SSH 连接,将打包的 Python 脚本推送到受控端 /tmp 目录下执行后返回 JSON 结果。
Ansible 强调幂等性(Idempotence),即无论 Playbook 运行多少次,只要目标系统的当前状态符合设定描述,就不会重复变更或触发非预期副作用。
# deploy_stack.yml - 声明式 Playbook 示例
---
- name: Web 与代理集群标准化部署
  hosts: webservers
  become: yes
  vars:
    app_version: "v2.4.1"
    install_root: "/opt/services/app"

  tasks:
    - name: 确保运行依赖环境完备
      apt:
        name:
          - nginx
          - python3-venv
          - libpq-dev
        state: present
        update_cache: yes

    - name: 建立部署目标目录结构
      file:
        path: "{{ install_root }}"
        state: directory
        owner: www-data
        group: www-data
        mode: '0755'

    - name: 下发标准化 Nginx 配置文件
      template:
        src: templates/nginx_app.conf.j2
        dest: /etc/nginx/sites-available/app.conf
        mode: '0644'
      notify: Reload Nginx

  handlers:
    - name: Reload Nginx
      service:
        name: nginx
        state: reloaded
2. 轻量级 Python 原生运维与发布:Fabric
对于不需要重型声明式配置管理的中小型项目,如果运维人员希望在 Python 代码中完全自由地编写远程命令执行、文件上传下载及环境管理逻辑,Fabric 是最灵活的工具。
Fabric 基于 Paramiko(Python 的 SSHv2 协议实现)构建,通过简单的装饰器和面向对象接口,将复杂的远程交互简化为直接的 Python 函数调用。
# fabfile.py - Fabric 自动化部署任务
from fabric import task

@task
def deploy(c, branch="main"):
    """自动化拉取代码、重载服务并验证健康度"""
    deploy_dir = "/opt/backend/api-service"

    print(f"--> 连接远程主机: {c.host}")
    with c.cd(deploy_dir):
        # 执行远程 git 更新
        c.run(f"git fetch origin && git checkout {branch} && git pull origin {branch}")

        # 在远程虚拟环境中更新依赖
        c.run("./venv/bin/pip install -r requirements.txt")

        # 重启 Systemd 管理的后端进程
        c.run("sudo systemctl restart api-service.service")

        # 本地验证健康检查接口
        res = c.run("curl -s -o /dev/null -w '%{http_code}' http://127.0.0.1:8000/health")
        if res.stdout.strip() == "200":
            print(f"主机 {c.host} 部署验证成功,状态码 200")
        else:
            raise RuntimeError(f"健康检查失败,返回: {res.stdout}")
通过命令行执行 fab -H web1.prod,web2.prod deploy --branch=release-1.2 即可批量对指定集群按序或并发执行该部署任务。
3. 高并发事件驱动配置中心:SaltStack
当受控节点规模扩大到数万台时,基于 SSH 线性建连的机制会在网络握手与高并发下遇到连接数瓶颈。SaltStack(基于 Python 开发)采用了 Master-Minion 架构,节点间基于高吞吐的消息队列 ZeroMQ 维持持久长连接。
SaltStack 具备极高的并发推送速度(几秒内可广播指令至上万台主机),并内建强大的 Grains(静态系统硬件属性提取)与 Pillar(动态敏感参数仓库)系统,是大型数据中心基础设施编排的核心支柱。
4. 分布式任务队列与后台任务分发:Celery
在运维自动化平台(如自研 CMDB、自动化发布平台、工单流转系统)中,长耗时的批处理操作(如全网配置检查、批量备份、证书更新、日志归档)必须从前端响应流程中剥离。Celery 是 Python 生态中最成熟的分布式任务队列框架。
通过 RabbitMQ 或 Redis 作为消息中间件(Broker),Celery 能够将庞大的批量运维任务异步分发到多个分布在不同机房的 Worker 节点上执行,并支持重试、定时计划(Celery Beat)与任务工作流(Canvas 链式调用)。
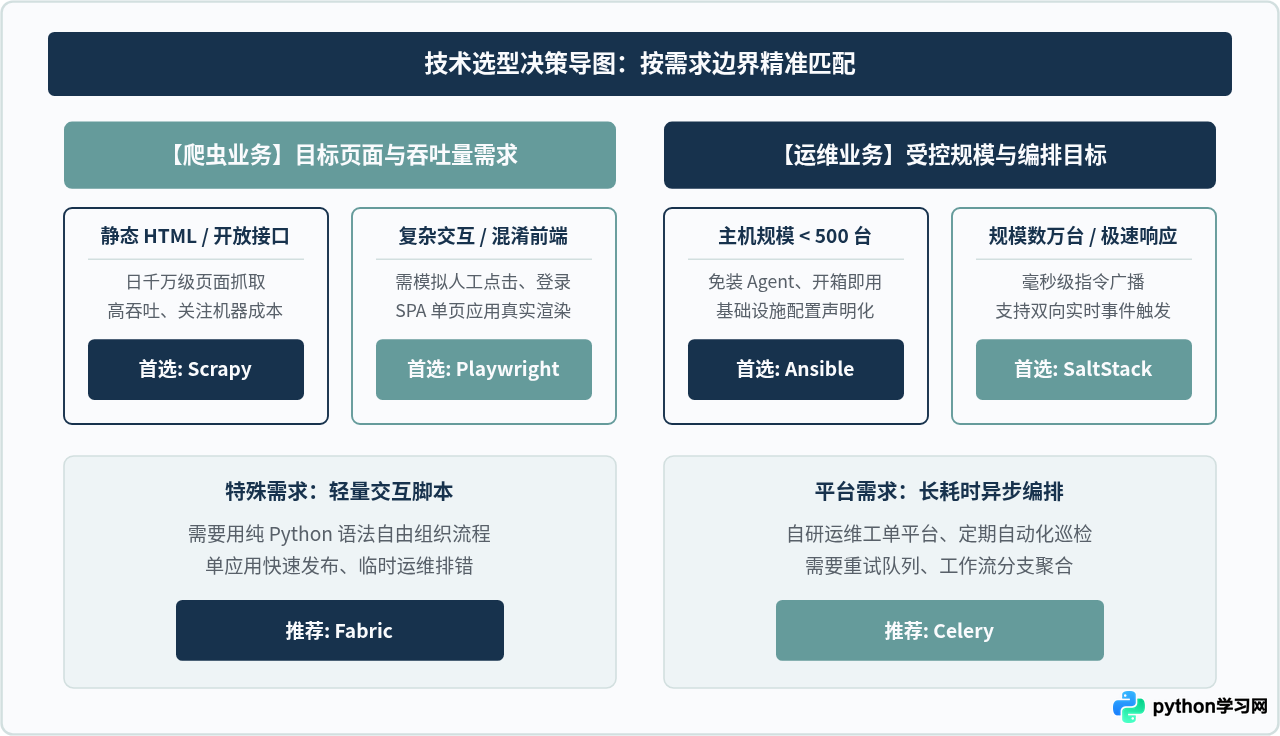
三、综合技术选型与工程决策指南
在实际项目落地中,框架的优劣并非绝对,关键在于技术选型是否契合团队的规模、系统基础设施架构以及维护成本。
| 框架名称 | 所属领域 | 核心架构模式 | 典型适用场景 | 首要考虑约束 |
|---|---|---|---|---|
| Scrapy | 网络爬虫 | Twisted 异步非阻塞 IO | 大规模静态网站、API 批量采集 | 不支持原生 JS 渲染,需扩展支持 |
| Playwright | 网络爬虫 / 测试 | CDP 协议无头浏览器控制 | 重度动态 SPA、反爬对抗、滑块与行为模拟 | 内存与 CPU 消耗远高于普通 HTTP 请求 |
| Ansible | 自动化运维 | Agentless (SSH) + 幂等 YAML 模块 | 多主机标准化配置管理、基础设施即代码 | 超大规模集群(数千台)并发响应受 SSH 瓶颈影响 |
| Fabric | 自动化运维 | Paramiko 直连命令式脚本 | 中小规模日常上线发布、一键运维补丁 | 缺乏内置状态管理,需人工保证脚本幂等 |
| SaltStack | 自动化运维 | Master-Minion (ZeroMQ 事件驱动) | 超大规模集群、毫秒级批量实时响应 | 各受控机需安装和守护 Minion 进程,维护成本高 |
| Celery | 任务调度 | Broker-Worker 异步分布式架构 | 运维平台后台任务、定时报表、巡检流水线 | 需依赖外部消息中间件(RabbitMQ / Redis) |
四、工程落地注意事项
在实际将上述框架投入生产环境时,还需要针对以下四项核心工程规范制定相应策略:
-
并发与限流控制:在爬虫工程中,盲目拉高并发不仅容易引起目标站点的防护熔断(IP 封禁、验证码拦截),还会对下游存储系统造成瞬时写入冲击。使用 Scrapy 时建议配置
DOWNLOAD_DELAY与AUTOTHROTTLE_ENABLED动态自适应限速;使用 Playwright 时应严格限制并行无头浏览器上下文数量,避免服务器内存溢出(OOM)。 - 生产环境的幂等性设计:无论是 Ansible 编写 Playbook 还是 Fabric 组织发布脚本,必须假定网络可能在任意一条指令中间中断。所有针对磁盘文件、系统配置与服务启动的操作均应保证重复执行产生一致结果,避免二次执行造成数据覆盖或冲突。
-
密钥与访问凭证治理:自动化运维框架涉及大量目标主机的最高管理权限。避免在 Playbook 或 Python 源码中明文硬编码 SSH 私钥、数据库凭据与 API Key。应结合
ansible-vault或 HashiCorp Vault 实施凭据集中管理与动态注入。 -
资源隔离与生命周期管理:Celery Worker 与 Playwright 进程在长周期运行后容易出现隐性资源泄漏。在生产环境中应设置 Worker 执行一定任务数后自动回收重启(例如 Celery 的
max_tasks_per_child参数),并依托 Systemd 或 Supervisord 实现进程守护与健康重启。
结语
Python 生态的深厚生命力,不仅体现在前沿的 Web 开发与人工智能领域,更体现在其为底层工程基础设施提供的坚实支撑。从高并发的分布式数据抓取到超大规模集群的自动化控制,Scrapy、Playwright、Ansible、Fabric、SaltStack 与 Celery 共同构成了现代工程师应对复杂自动化场景的专业工具箱。理解各框架的底层运行原理与适用边界,能够帮助技术团队在选型时做出更稳健、更高效的工程决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









