

Python内置函数input()与print()的高级格式化技巧
深入解析Python内置函数input()与print()的高级格式化技巧,涵盖格式规范微语法、终端动态行刷新、I/O缓冲流控制及健壮用户交互输入管道。
在日常 Python 开发中,input() 与 print() 常被当作最简单的控制台调试工具使用。然而,这两个内置函数在格式规范微语法(Format Specification Mini-Language)、底层 I/O 流缓冲控制、同屏动态进度重绘以及交互式输入管道构建方面,均包含非常强大的工程化能力。本文将绕开浅层的基本用法,深入解析这两个函数的高级格式化与控制技巧,帮助你在不引入庞大第三方 CLI 框架的前提下,编写出优雅、鲁棒且具备专业展示效果的终端交互程序。
一、print() 与格式规范微语法的高阶排版技巧
格式化输出的核心依托于 Python 的格式规范微语法。结合现代 f-string 语法,print() 能够在不借助外部对齐库的情况下,实现精细的数据网格化渲染与排版。
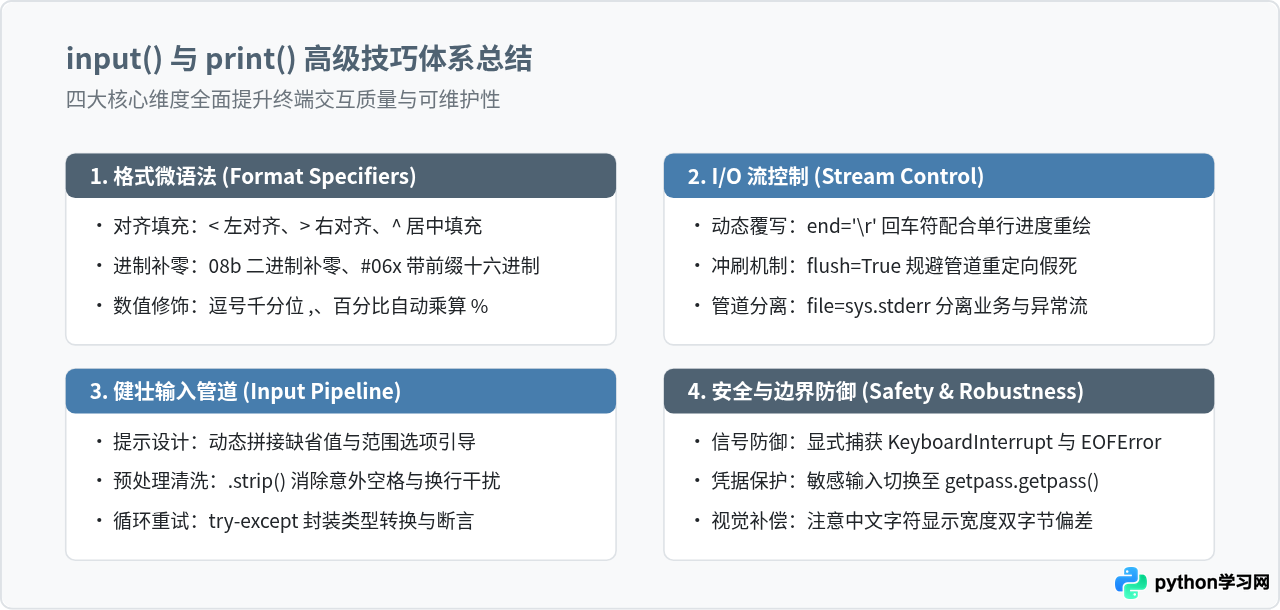
1. 填充、对齐与固定宽度控制
格式语法的标准结构由 [fill][align][width] 构成,其中 < 表示左对齐,> 表示右对齐,^ 表示居中对齐,前面可紧跟任意填充字符:
# 演示不同填充符与对齐方式
title = "SYSTEM REPORT"
print(f"{title:=^40}")  # 用等号填充,居中对齐,总宽40

items = [("CPU使用率", 32.5), ("内存占用", 78.12), ("磁盘读取", 5.4)]
for name, val in items:
    # 标题左对齐占15格,数值右对齐占10格并保留2位小数
    print(f"| {name:<15} | {val:>10.2f}% |")
示例输出:
=============SYSTEM REPORT==============
| CPU使用率          |      32.50% |
| 内存占用            |      78.12% |
| 磁盘读取            |       5.40% |
2. 数值分隔符与进制补零
处理大型数值或底层二进制数据时,可以使用下划线 _ 或逗号 , 作为千分位分隔符,并通过进制标志与补零机制实现标准化输出:
num = 104857600
print(f"标准千分位: {num:,}")       # 104,857,600
print(f"下划线分组: {num:_}")       # 104_857_600

# 进制转换与前导零控制
flags = 42
print(f"8位补零二进制: {flags:08b}")   # 00101010
print(f"带前缀十六进制: {flags:#06x}")  # 0x002a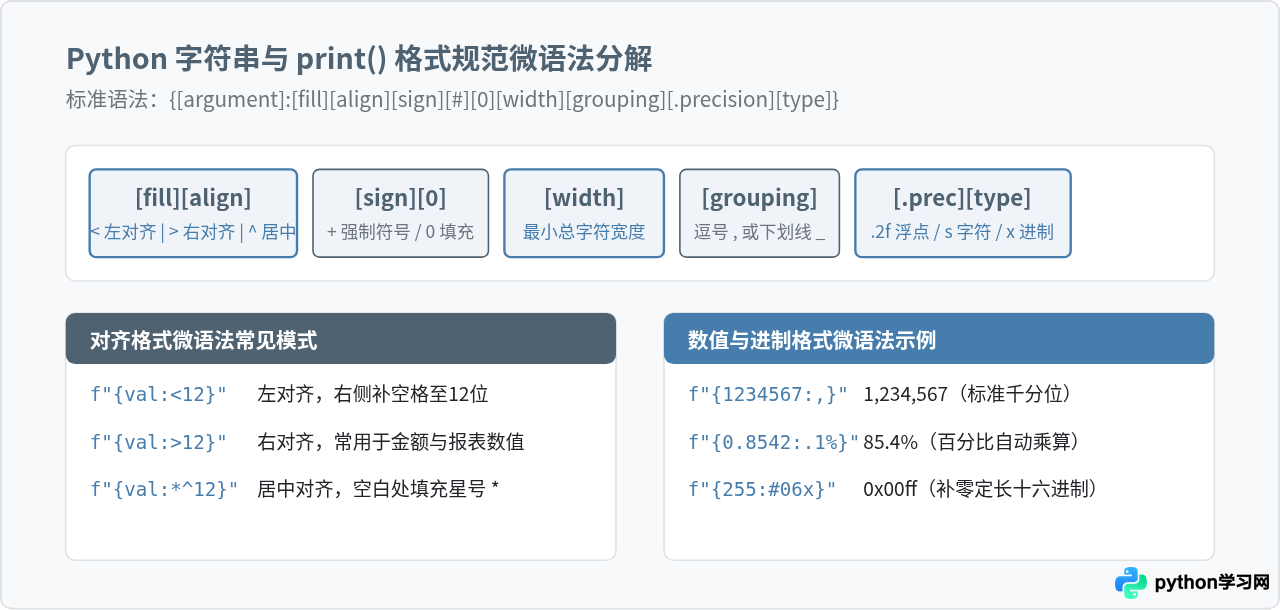
二、print() 输出流控制:sep、end、file 与 flush 底层机制
print() 的完整函数签名如下:
print(*objects, sep=' ', end='\n', file=None, flush=False)这四个关键字参数决定了文本如何组织、流向何处以及何时刷新到外部设备。
1. 多元素分隔符与结尾换行替代
sep 控制多个参数合并时的分隔符,end 控制单次调用结束时的尾缀字符。通过自定义这两个参数,可以避免繁琐的 str.join():
# 快速生成 CSV 格式行
print("2026-10-26", "Server-01", "CPU_LOAD", "45%", sep=",")

# 不换行连续输出
for i in range(5):
    print(f"[{i}]", end=" ")
print()  # 输出独立换行
2. 回车符(\r)与 flush=True 实现动态进度条
终端在输出字符时,\n(换行符)会将光标下移一行,而 \r(回车符)仅将光标移回当前行首。配合 flush=True 强制清空标准输出缓冲区,即可在单行内实现动态刷新,而无需刷屏:
import time

total_steps = 50
print("任务开始执行...")
for step in range(1, total_steps + 1):
    percent = (step / total_steps) * 100
    bar = "=" * (step // 2) + ">"
    # \r 让光标回到行首,end="" 阻止换行,flush=True 强制立即写出到终端
    print(f"\r进度: [{bar:<26}] {percent:>5.1f}%", end="", flush=True)
    time.sleep(0.04)
print("\n任务已圆满完成!")
3. 输出流重定向:file 参数
默认情况下,file=None 会输出至 sys.stdout。通过显式指定 file,可以将错误信息分流至标准错误 sys.stderr,或直接写入文件:
import sys

# 将告警信息重定向到标准错误流(避免污染管道传给下一进程的正常输出)
print("[ERROR] 数据库连接失败!", file=sys.stderr)

# 直接将格式化结果记录至日志文件
with open("audit.log", "a", encoding="utf-8") as f:
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 用户 root 登入系统", file=f, flush=True)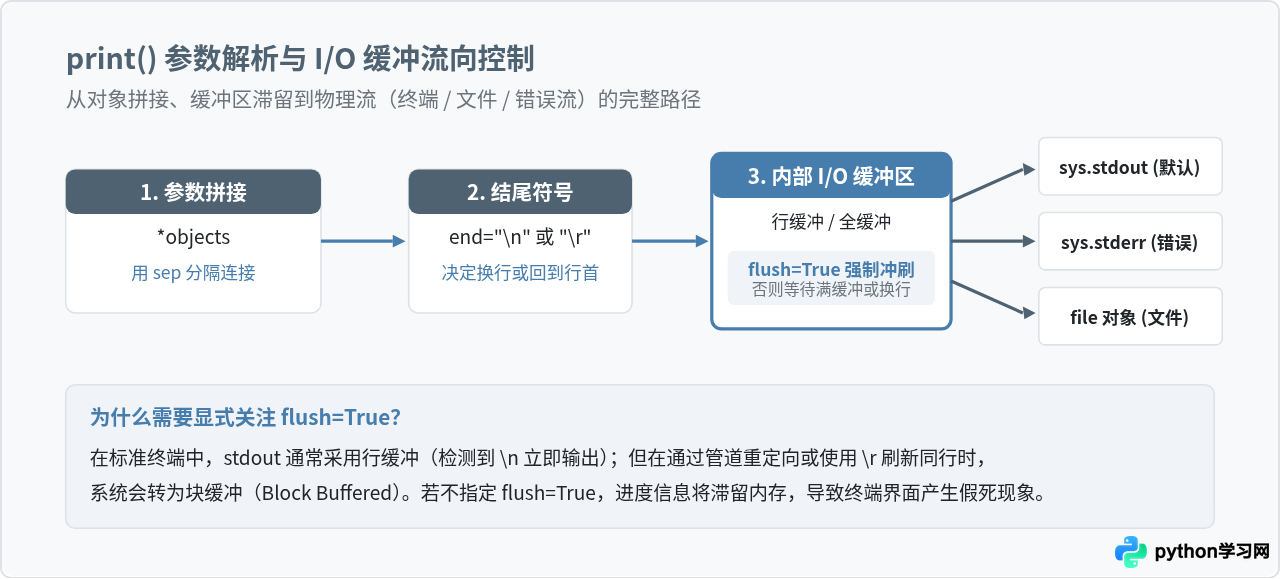
三、input() 的高级提示排版与健壮数据管道
input(prompt) 接收一个可选字符串作为提示,等待用户键入回车后返回字符串。虽然它的调用形式单一,但在工程实践中,必须通过提示排版与输入管道来解决两大问题:交互可读性与数据安全性。
1. 多行提示与动态引导格式化
input() 的 prompt 参数完全支持包含换行符与格式化占位符的字符串。可以利用多行文本构建清晰的引导菜单:
# 动态生成带有默认值与选项指引的 prompt
def ask_choice(prompt_text, default_val=None):
    if default_val:
        hint = f" [{default_val}]"
    else:
        hint = ""
    prompt_str = f">>> {prompt_text}{hint}: "
    val = input(prompt_str).strip()
    return val if val else default_val

port = ask_choice("请输入服务监听端口", default_val="8080")
print(f"最终确认端口号: {port}")
2. 构建类型安全与重试循环管道
原始 input() 总是返回 str。如果用户输入非法格式(例如字母代替整数)或触发中断键(Ctrl+C / Ctrl+D),直接类型转换会导致崩溃。标准做法是封装类型转换与验证管道:
def get_valid_input(prompt, validator, error_msg="输入不符合要求,请重试"):
    """
    鲁棒输入管道:处理清洗、校验、类型转换与异常重试
    """
    while True:
        try:
            raw = input(prompt).strip()
            # 执行类型验证与断言
            result = validator(raw)
            return result
        except ValueError:
            print(f"[提示] {error_msg}")
        except (KeyboardInterrupt, EOFError):
            print("\n[系统] 操作已取消,程序退出。")
            sys.exit(0)

# 使用示例:限制输入 1 到 65535 之间的合法端口
def port_validator(val):
    num = int(val)
    if 1 <= num <= 65535:
        return num
    raise ValueError

port = get_valid_input(
    prompt="请输入目标端口 (1-65535): ",
    validator=port_validator,
    error_msg="端口号必须为 1 到 65535 之间的整数"
)
print(f"成功获取有效端口: {port}")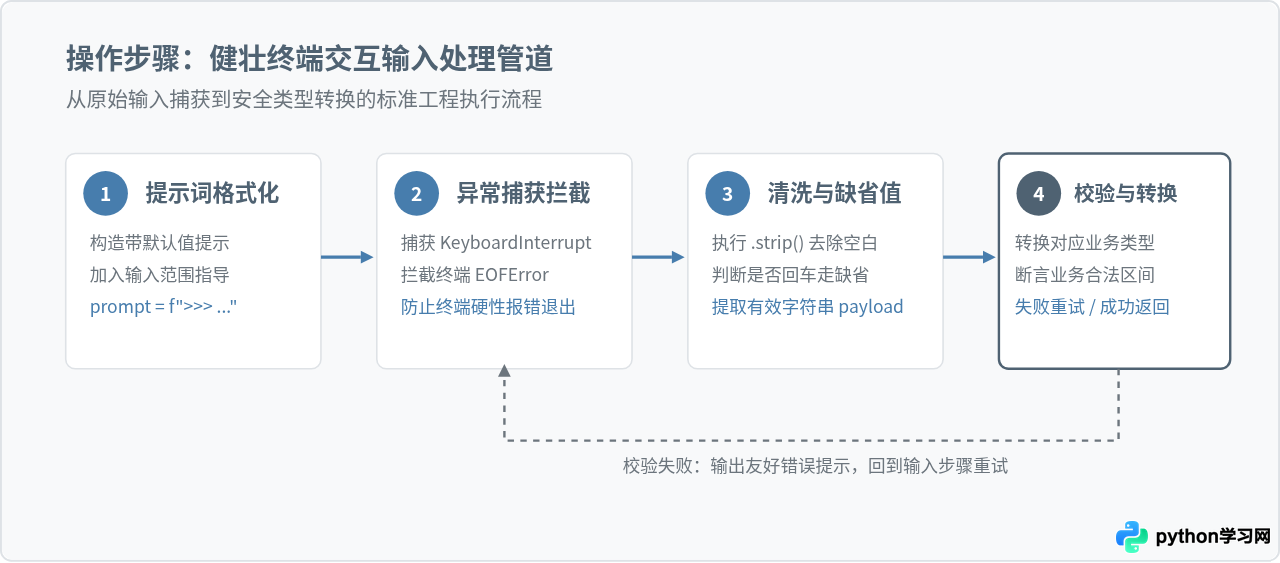
四、综合实践:构建交互式数据报表生成器
下面我们将 input() 的参数校验与 print() 的高级格式化结合,构建一个完整的交互式销售订单分析器。该示例展示了如何实现带有标题居中、固定宽度数字右对齐、千分位及百分比格式化的完整报表:
def run_report_generator():
    print("=" * 50)
    print(f"{'销售数据统计系统':^46}")
    print("=" * 50)

    # 1. 获取用户输入
    dept = input("请输入所属部门 [运营部]: ").strip() or "运营部"

    while True:
        try:
            target_str = input("请输入季度销售目标 (元): ").strip()
            target_amount = float(target_str)
            if target_amount > 0:
                break
            print("[警告] 目标金额必须大于 0!")
        except ValueError:
            print("[警告] 请输入合法的纯数字金额!")

    # 模拟订单明细
    records = [
        ("华北办事处", 342150.00),
        ("华东办事处", 894320.50),
        ("华南办事处", 562100.20),
        ("西南办事处", 215400.00),
    ]

    total_actual = sum(amount for _, amount in records)
    completion_rate = total_actual / target_amount

    # 2. 格式化输出分析报表
    print(f"\n{'-'*50}")
    print(f"部门: {dept:<15} 考核目标: {target_amount:>15,.2f} 元")
    print(f"{'-'*50}")
    print(f"| {'办事处':<14} | {'实际销售额 (元)':>16} | {'贡献占比':>8} |")
    print(f"|{'-'*18}|{'-'*20}|{'-'*12}|")

    for region, actual in records:
        share = actual / total_actual
        print(f"| {region:<14} | {actual:>18,.2f} | {share:>9.1%} |")

    print(f"{'-'*50}")
    print(f"实际汇总: {total_actual:>20,.2f} 元")
    print(f"目标达成率: {completion_rate:>18.2%}")
    print(f"{'='*50}")

if __name__ == "__main__":
    run_report_generator()
运行结果示例:
==================================================
                   销售数据统计系统
==================================================
请输入所属部门 [运营部]: 华东大区
请输入季度销售目标 (元): 1800000

--------------------------------------------------
部门: 华东大区             考核目标:    1,800,000.00 元
--------------------------------------------------
| 办事处             |       实际销售额 (元) |     贡献占比 |
|------------------|--------------------|------------|
| 华北办事处          |         342,150.00 |     17.0% |
| 华东办事处          |         894,320.50 |     44.4% |
| 华南办事处          |         562,100.20 |     27.9% |
| 西南办事处          |         215,400.00 |     10.7% |
--------------------------------------------------
实际汇总:         2,013,970.70 元
目标达成率:            111.89%
==================================================
五、常见问题排查与注意事项
避坑指南与性能考量:
- 中文字符宽度对齐偏移问题:在终端中,中文字符通常占用两个半角字符的显示宽度,但 Python 的
width规范以字符数量(Unicode Code Points)而非显示宽度(Monospace Display Cells)进行计算。若表格中混合了中英文字符,单纯依靠{:10}会发生错位。对于严格对齐的纯中英文混排,可通过unicodedata.east_asian_width计算视觉宽度,或通过填充全角空格进行补偿。 - 无回显密码输入:切勿使用
input("请输入密码: ")进行明文交互。应当使用标准库getpass.getpass("请输入密码: "),其通过系统调用禁用了控制台的回显(echo)机制。 - 大批量打印性能:若需要循环输出数十万行日志,反复调用
print()产生大量的系统 I/O 切换开销。推荐使用sys.stdout.write()配合行缓存,或先批量合并字符串后再调用print()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









