

Python汉诺塔递归调用过程是怎么执行的?
深入拆解Python汉诺塔递归调用的执行机制。从形参与实参的角色动态互换、三阶汉诺塔递归调用树的时序追踪,到解释器内存调用栈的压栈与弹栈,全面揭示递归运行本质。
从一段仅有六行的标准实现切入
在 Python 中,解决汉诺塔问题的经典代码极其简练,甚至常让人怀疑它是否少写了移动盘子的细节逻辑。我们先看这段基础实现:
def hanoi(n, source, target, auxiliary):
    if n == 1:
        print(f"移动盘子 1: {source} -> {target}")
        return

    # 步骤一:将前 n-1 个盘子从源柱移动到辅助柱
    hanoi(n - 1, source, auxiliary, target)

    # 步骤二:将剩下的第 n 个最大盘子移动到目标柱
    print(f"移动盘子 {n}: {source} -> {target}")

    # 步骤三:将辅助柱上的 n-1 个盘子移动到目标柱
    hanoi(n - 1, auxiliary, target, source)

# 执行示例:移动 3 个盘子,从 A 柱经由 B 柱移到 C 柱
hanoi(3, 'A', 'C', 'B')
在这段代码里,真正产生终端输出的只有两处:if n == 1 时的基础输出,以及夹在两次递归调用中间的单步输出。整段算法没有使用任何 for 或 while 循环,却能分毫不差地按照数学最优路径依次打印出 7 次移动。这背后的核心枢纽,就是“三步任务分解”与“柱子逻辑角色的动态置换”。
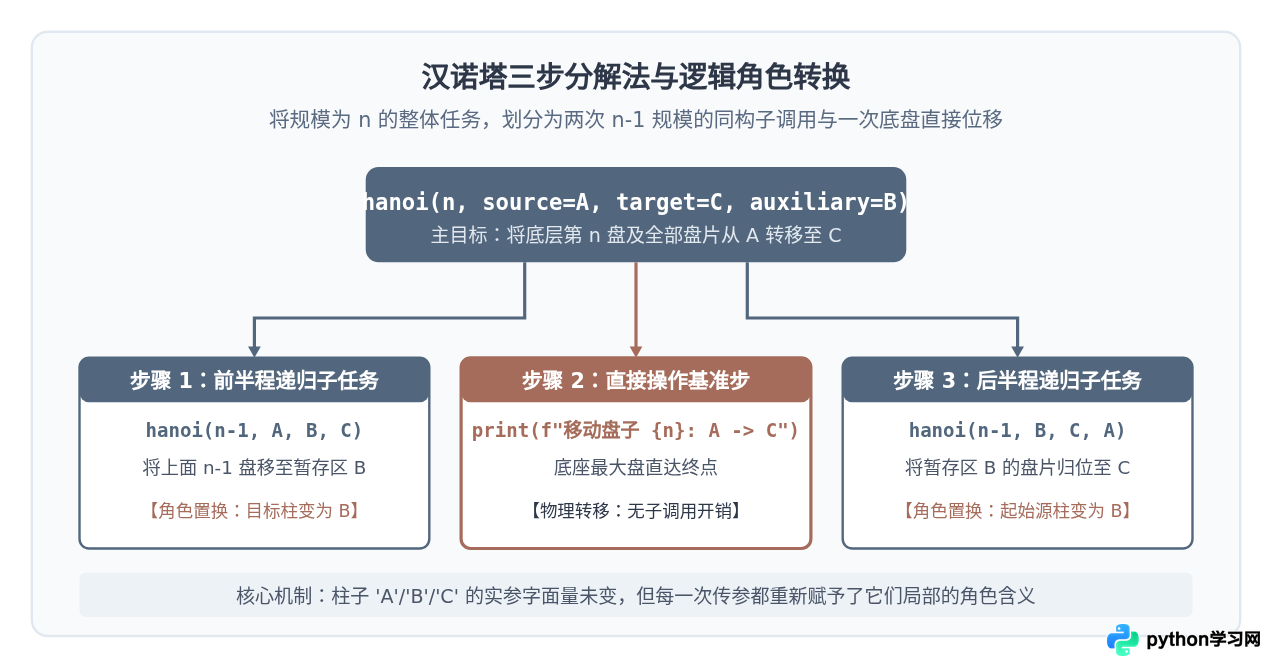
递归分解模型:形参与实参的角色置换
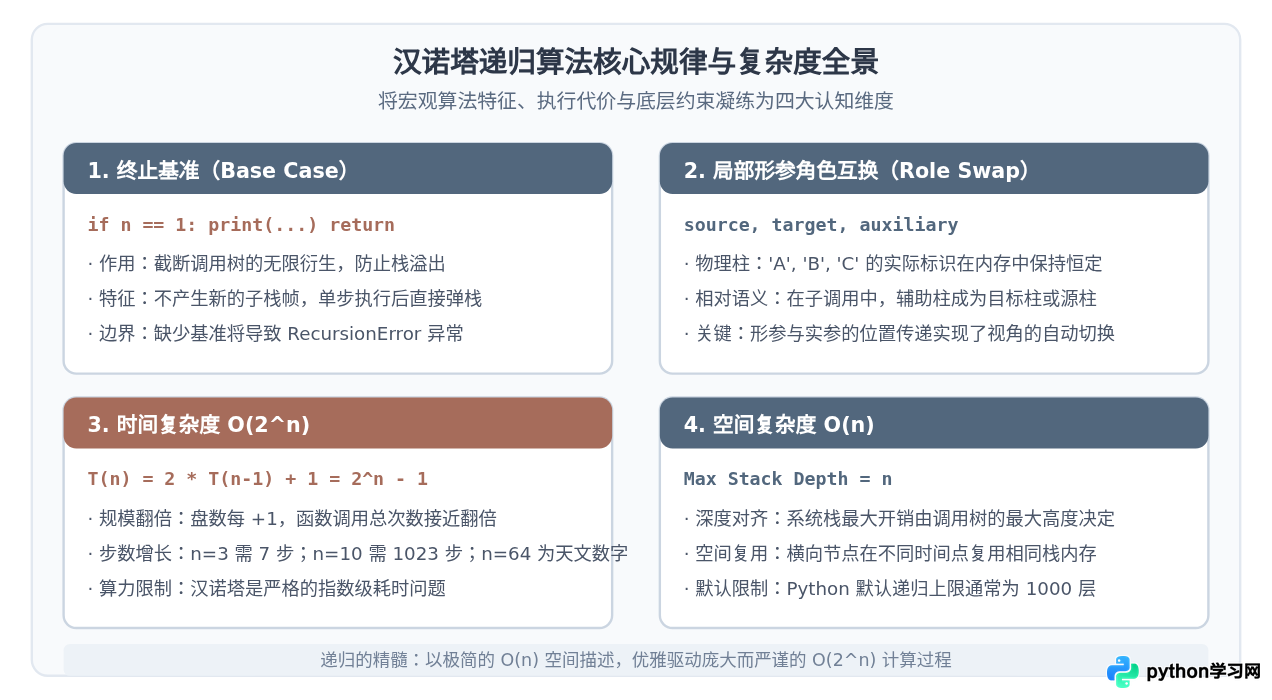
初学者阅读 hanoi 函数时,最大的认知障碍往往是参数位置的变化。函数定义中的四个形参分别是 source(源柱)、target(目标柱)和 auxiliary(辅助柱)。物理世界中的三根柱子通常被固定命名为 'A'、'B'、'C',但在递归调用链条中,同一根物理柱子在不同层级所扮演的逻辑角色是不断翻转的。
对于宏观问题“把 n 个盘子从 A 移到 C”,必须满足两个不可违背的物理前提:底部的最大盘子要想去往 C,上面必须空无一物;目标柱 C 的底部也必须是空的才能容纳最大盘。这就倒逼出了唯一可行的解题策略:
- 前半程子问题:先把上方的
n-1个盘子移到暂存区auxiliary。在这个子任务中,auxiliary临时充当了“目标”,而原本的target则退化成了“辅助通道”。 - 中间基准动作:最大盘子直接从
source放到target,无需任何递归,一步到位。 - 后半程子问题:再把暂存在
auxiliary上的n-1个盘子搬运到target。此时auxiliary变成了“发货源头”,而之前的source变成了“辅助通道”。
3阶汉诺塔的单步执行时序与调用树
为了看清 Python 是如何一步一步跑完这套逻辑的,我们以 hanoi(3, 'A', 'C', 'B') 为例,完整还原控制流的跳转轨迹。
在计算机中,递归并不是并行执行的,而是由单线程严格按照深度优先搜索(DFS)的方式依序进行。当一个函数内部再次调用自己时,当前函数的执行现场会被完整冻结,CPU 立即跳转到新函数的入口执行,直到新函数返回,先前冻结的代码才得以苏醒并继续往下执行。
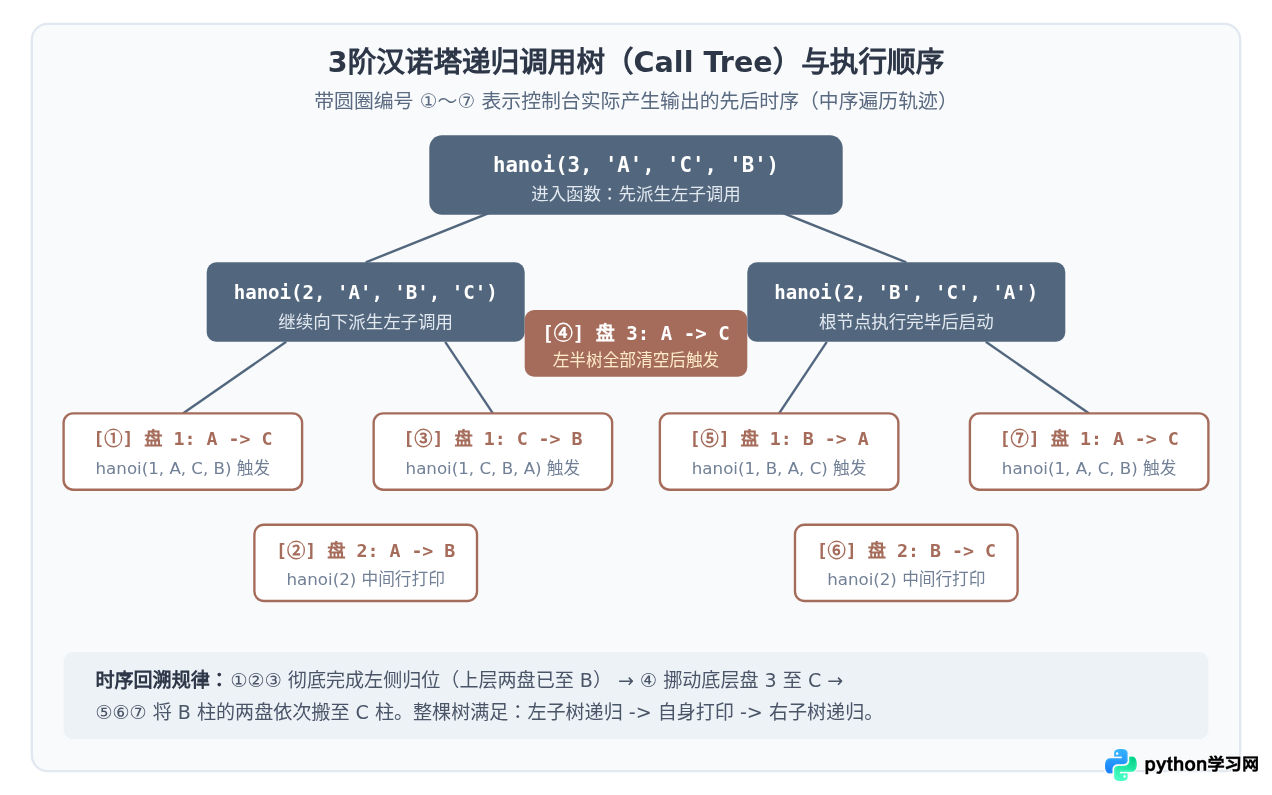
观察图 2 中的调用树可以发现一个明确的数学对应关系:当 n = 3 时,调用树的叶子节点与非叶子节点的打印动作刚好构成了 7 个步骤(即 \(2^3 - 1\))。
- 首先,最外层的
hanoi(3, 'A', 'C', 'B')被触发,它发现n != 1,于是执行前半段:发起hanoi(2, 'A', 'B', 'C')。此时根节点的代码停留在第 6 行,进入等待状态。 - 新的
hanoi(2, ...)进入后,同样发现n != 1,于是再次向下发起hanoi(1, 'A', 'C', 'B')。hanoi(2)也被挂起在自己的第 6 行。 hanoi(1, ...)进入后,命中基准判断n == 1,直接在控制台输出移动盘子 1: A -> C,然后通过return结束生命周期。这就是时序中的第 ① 步。- 子调用结束,控制权弹回上一级
hanoi(2)。挂起的代码苏醒,执行第 9 行的单步打印:移动盘子 2: A -> B(时序第 ② 步)。随后,它执行第 12 行的后半段递归:hanoi(1, 'C', 'B', 'A')。 - 该子调用再次命中基准,输出
移动盘子 1: C -> B(时序第 ③ 步)并返回。至此,hanoi(2)的三行代码全部走完,返回销毁。 - 此时,根节点
hanoi(3)的前半段才算真正执行完毕!解释器从挂起点苏醒,打印第 9 行:移动盘子 3: A -> C(时序第 ④ 步)。紧接着,它启动后半段的庞大子树hanoi(2, 'B', 'C', 'A'),以完全相同的镜像逻辑依次完成 ⑤、⑥、⑦ 步。
深入底层:Python 调用栈的压栈与弹栈机制
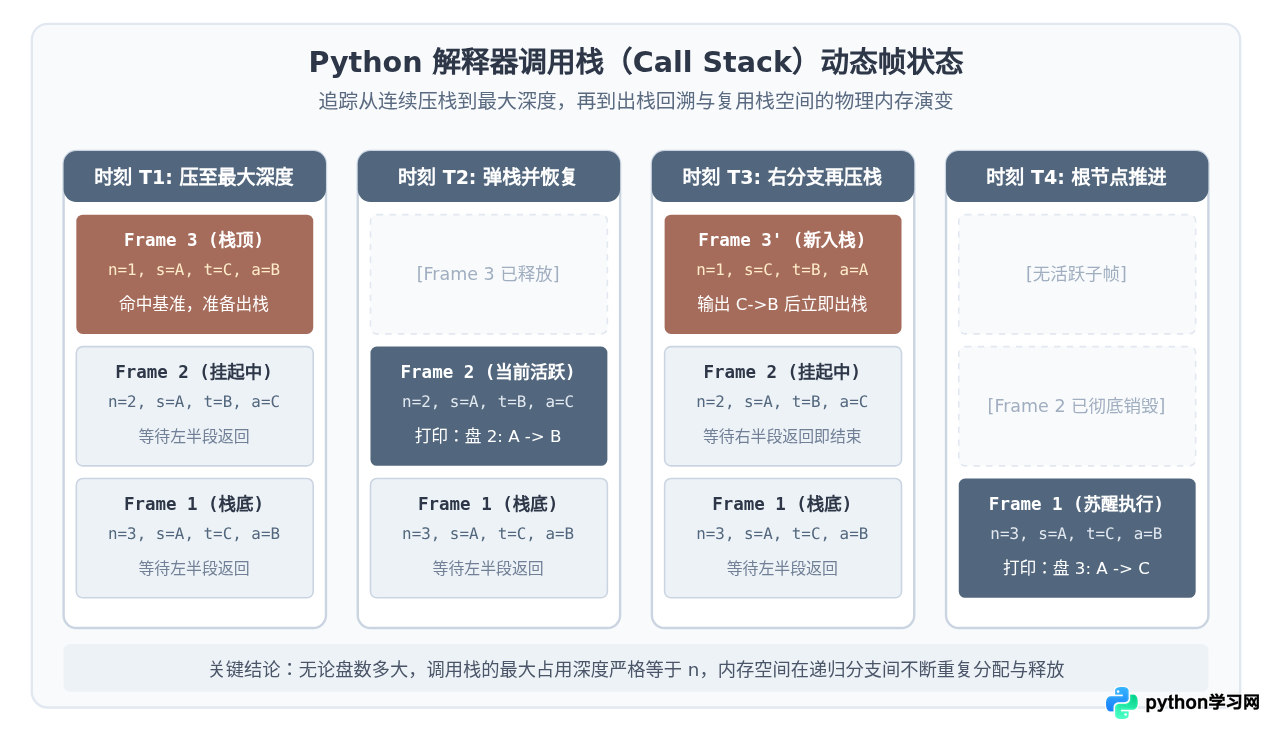
许多人在脑中模拟递归时会感到“内存不够用”,是因为试图在脑海中同时记住多层函数的变量状态。但在真实的 Python 解释器(CPython)中,这一工作由系统调用栈(Call Stack)全自动完成。
每当 Python 执行一次函数调用,解释器就会在内存中分配一个栈帧对象(Frame Object)。每个栈帧包含以下几个不可或缺的核心数据:
- 局部变量空间:保存当前调用专有的
n、source、target、auxiliary引用。不同栈帧中的同名变量互不相干。 - 字节码指令指针(f_lasti):记录当前函数执行到了哪一行字节码指令。被挂起时,指针记录断点位置;恢复时直接从下一个偏移量继续运行。
- 上一级栈帧指针(f_back):形成一条链表,指向调用它的父级栈帧,保证函数
return时能准确找到回家的路。
思维跃迁:如何避免陷入人肉追踪的误区
理解了执行过程后,更重要的一步是建立正确的思维模型。在实际开发和算法设计中,如果对每一个递归问题都试图在脑海中追踪每一根树枝、每一个栈帧,大脑很容易产生信息过载。
数学家和资深程序员看待汉诺塔执行过程的方式,其实是基于数学归纳法的信任机制:
1. 验证基准条件(Base Case): 当 n = 1 时,函数是否能正确无误地完成单盘转移?答案是显而易见的,直接打印 source -> target。
2. 建立归纳假设: 假设 hanoi(n - 1) 已经被别人实现得毫无差错,能够把任意 n - 1 个盘子从起点转移到指定终点。
3. 构建主问题逻辑: 基于上述假设,把 n 个盘子移到终点,只需要把上面的 n - 1 个盘子交给子函数移走,自己把底盘移到目的地,再叫子函数把 n - 1 个盘子盖上来。
只要基准步正确、推导关系成立,整个递归链条在数学上就必然成立。计算机负责处理繁琐枯燥的进栈、出栈、指针维护,而人类只需要负责定义好拆解规则与终止边界。
工程实践中的边界与注意事项
在 Python 中实际使用递归解决类似问题时,还有两个与底层执行密切相关的工程细节需要格外注意:
- 递归深度上限:Python 解释器为了防止 C 语言层面的调用栈崩溃,设置了软性递归保护(可通过
sys.getrecursionlimit()查询,默认一般为 1000)。虽然汉诺塔在 \(n=1000\) 之前就早已因为运行时间无法承受而失去实际意义,但在树状或深层链式数据结构的递归处理中,触碰该限制会导致RecursionError: maximum recursion depth exceeded。 - 尾递归优化的缺失:某些函数式语言(如 Scheme、Erlang)或优化编译器支持“尾调用消除”(Tail Call Elimination),可以将满足尾递归模式的调用直接转化为迭代循环,不再新增栈帧。然而 CPython 官方明确不支持尾递归优化,其核心哲学是为了保留完整、清晰的回溯异常堆栈(Traceback),以便开发者准确定位 bug。因此在 Python 中,每一次递归调用都会实打实地产生一个栈帧。
搞清了 Python 汉诺塔的执行过程,其实就等于拿到了通往高级树状算法的钥匙。二叉树的前序、中序、后序遍历,分治算法归并排序,乃至回溯搜索的底层执行逻辑,无一不是遵循着这种“函数入栈暂存局部状态、抵达基准回弹控制权、重构参数继续右分支”的标准运行机制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









