

Python高效遍历字典的技巧与最佳实践

.values() 或 .items()),坚决避免在循环体内部进行重复的二次哈希查表,并在需要修改或删除字典项时通过快照或推导式隔绝迭代状态。
一、核心遍历方式与底层视图机制
Python 3 的字典(dict)内部采用了紧凑哈希表实现,键与值存储在有序的连续数组中。字典对象提供了三种内置视图方法:keys()、values() 与 items()。这些视图对象不会复制任何底层数据,而是以 \(O(1)\) 的空间复杂度直接提供对内部散列表条目的动态窗口。
1. 仅需键:直接遍历字典对象
当业务逻辑仅需要检查键或基于键列表做判断时,最地道且开销最小的方式是直接对字典本身进行迭代,而无需显式调用 .keys():
config = {"host": "127.0.0.1", "port": 8080, "timeout": 30}

# 推荐:直接迭代字典本身
for key in config:
    print(f"参数项: {key}")

# 等价但多了属性查找开销
for key in config.keys():
    print(f"参数项: {key}")
直接使用 for key in config 会直接调用字典内部的 __iter__ 槽位,省去了一次属性查找和视图对象实例化的微小开销。
2. 需同时访问键与值:使用 dict.items()
如果循环中既要使用键也要使用对应的值,应当始终优先使用 dict.items() 进行解包遍历:
# 推荐:单次解包获取键与值
for key, value in config.items():
    print(f"{key} => {value}")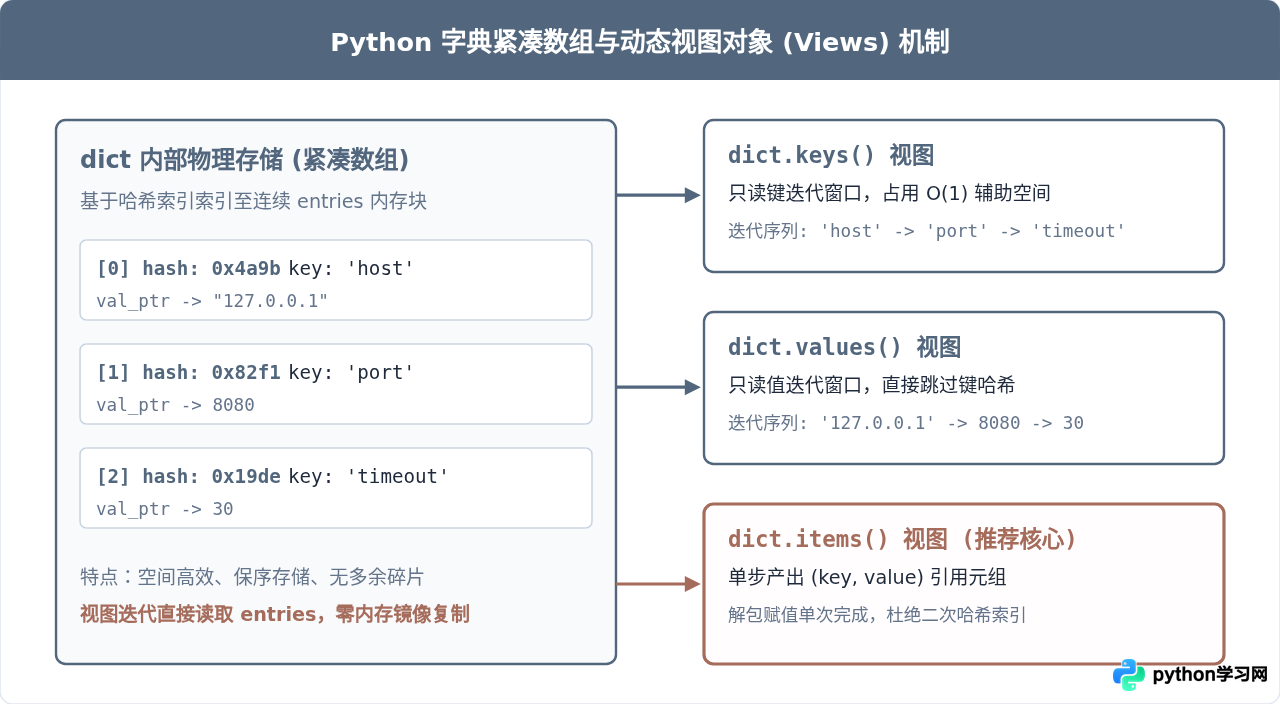
二、性能深度解析:为什么必须摒弃“二次寻址”反模式
初学者常写出以下形式的遍历代码:
# 常见低效写法:通过键重新索引字典
for key in config:
    value = config[key]  # 触发多余的哈希计算与查找
    process(key, value)
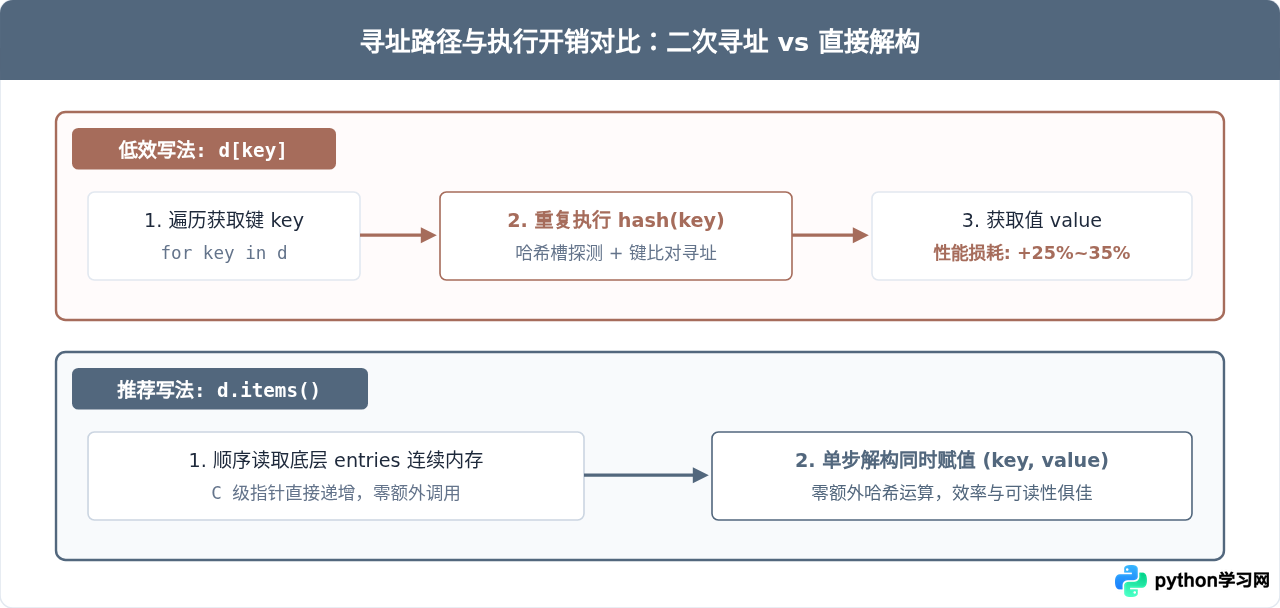
表面上看,字典的读取操作是 \(O(1)\),似乎并无大碍。但实际上,每次执行 config[key] 都包含以下步骤:
- 重新调用
hash(key)计算哈希值; - 在字典哈希索引表中进行模运算定位存储槽位;
- 进行冲突探测与键对象等值比对(
PyObject_RichCompareBool); - 从条目中取出值指针并返回。
而在 for key, value in config.items() 中,迭代器直接在 C 语言层面顺序推进底层数组指针,一次性将 key 和 value 的引用解包传递给变量。在大规模数据遍历时,二次寻址会导致耗时增加 25% 至 35%。
三、遍历中动态修改与删除字典项的安全实践
Python 字典维护着一个修改计数器(ma_version_tag)。在直接迭代字典的过程中,如果字典的大小发生改变(添加或删除键),迭代器会立刻抛出致命异常:
data = {"a": 1, "b": 2, "c": 3, "d": 4}

# 错误示范:直接在迭代中删除元素
for key, value in data.items():
    if value % 2 == 0:
        del data[key]
# 抛出: RuntimeError: dictionary changed size during iterationdata[key] = new_value),因为字典大小和哈希结构未发生变更。但只要涉及增删“键”,就必须使用隔离策略。
最佳解决方案 1:基于键快照就地删除
如果需要对原字典进行就地修改(In-Place Modification),只需用 list() 将键打包为一个独立的临时列表快照:
# 正确做法:使用 list() 隔离迭代器
for key in list(data.keys()):
    if data[key] % 2 == 0:
        del data[key]

# 此时原字典安全更新为: {'a': 1, 'c': 3}
list(data.keys()) 仅复制了键对象的指针,内存开销较小,且完全阻断了字典大小突变对迭代器的影响。
最佳解决方案 2:字典推导式快速过滤
在追求高吞吐、函数式或需要保留不可变约定的场景下,利用字典推导式生成新字典不仅代码清晰,而且在底层直接调用专门的构建指令,性能极佳:
# 正确且高效:字典推导式过滤
cleaned_data = {k: v for k, v in data.items() if v % 2 != 0}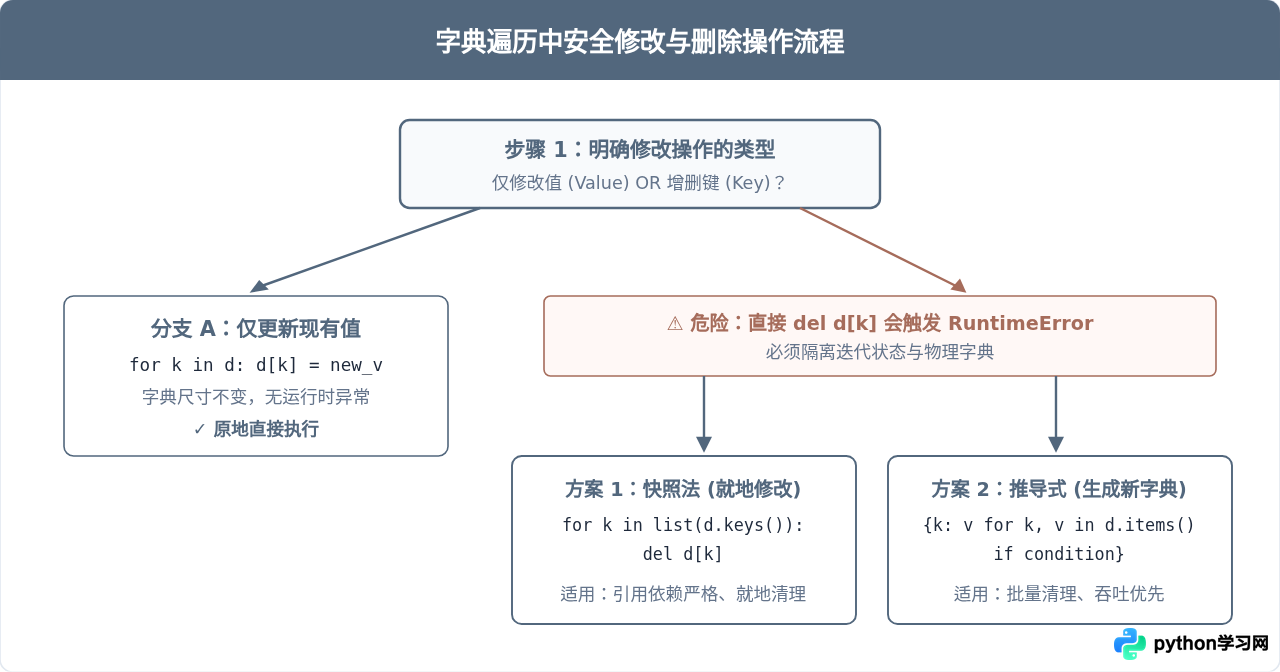
四、进阶场景的最佳实践与组合技巧
1. 保持有序与排序遍历
Python 3.7+ 保证了字典的原生插入顺序。若需按特定业务规则排序遍历,结合 sorted() 处理 items():
scores = {"Alice": 92, "Bob": 85, "Charlie": 98, "Diana": 88}

# 场景 A:按字典键 (名字) 字母顺序遍历
for name, score in sorted(scores.items()):
    print(f"{name}: {score}")

# 场景 B:按字典值 (成绩) 降序排列遍历
for name, score in sorted(scores.items(), key=lambda item: item[1], reverse=True):
    print(f"名次排名: {name} -> {score}")
2. 需带递增序号的遍历:使用 enumerate()
在输出带行号的报表或处理特定批次时,许多人习惯手动维护计数器,但利用 enumerate() 包裹 items() 更加优雅高效:
# 优雅获取索引序号、键、值
for index, (key, value) in enumerate(config.items(), start=1):
    print(f"[{index}] {key}: {value}")
3. 多字典级联遍历:collections.ChainMap
当存在默认配置与用户覆盖配置多个字典时,切忌使用 dict.update() 或 {**d1, **d2} 创建合并副本,这会带来额外内存分配。使用 ChainMap 可以进行零内存拷贝的逻辑链式遍历:
from collections import ChainMap

defaults = {"theme": "light", "fontSize": 14, "autoSave": True}
user_prefs = {"theme": "dark", "fontSize": 16}

# 逻辑合并,遍历时不复制数据
combined = ChainMap(user_prefs, defaults)
for setting, val in combined.items():
    print(f"{setting} = {val}")
五、常见遍历方式与场景决策对比
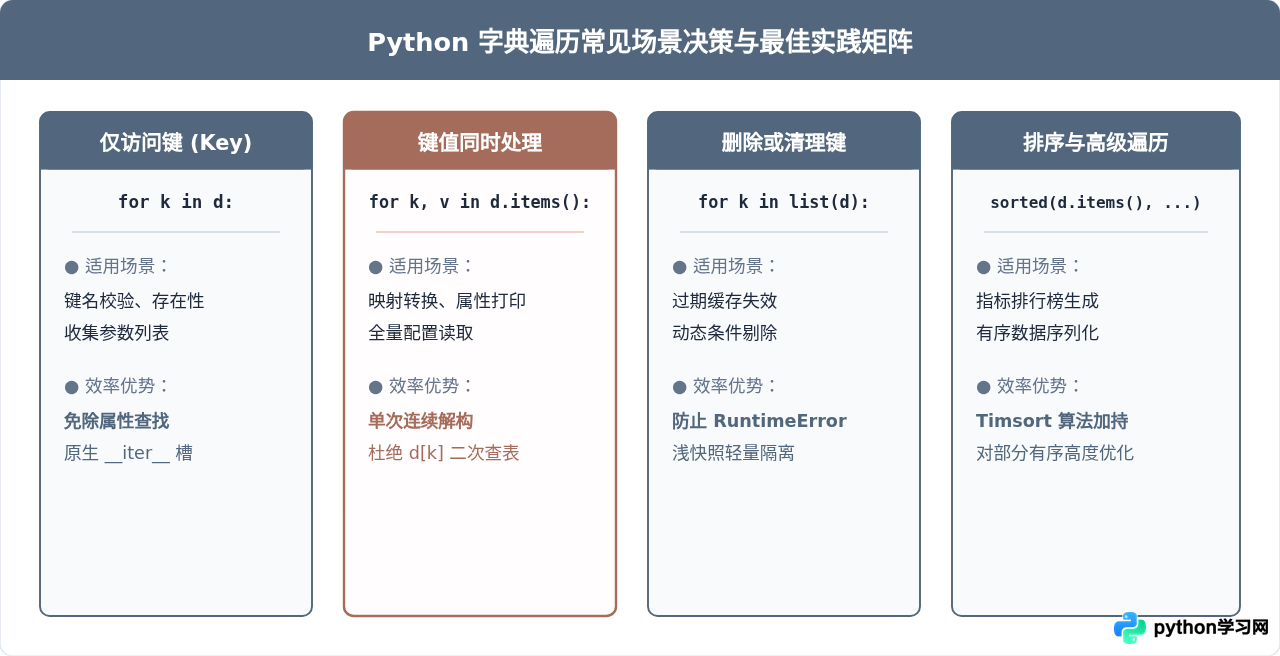
下表总结了在不同工程场景下最推荐的遍历模式及其性能边界:
| 遍历目标 | 推荐写法 | 底层开销 | 推荐理由与注意事项 |
|---|---|---|---|
| 仅需键 | for k in d: |
最小(仅 __iter__) |
比 d.keys() 更精简,无多余属性寻址。 |
| 仅需值 | for v in d.values(): |
低(顺序读取指针) | 跳过键提取,语义清晰直观。 |
| 同时需键和值 | for k, v in d.items(): |
极高效率(单次解构) | 彻底杜绝 d[k] 二次哈希查表损耗。 |
| 遍历中删除键 | for k in list(d): |
轻微(浅拷贝键列表) | 安全避免 RuntimeError 字典大小变更异常。 |
| 大批量键值过滤 | {k: v for k, v in d.items() if ...} |
单次高效构建 | 利用专用字节码构建,速度通常快于逐个 pop()。 |
六、总结
编写高效 Python 代码的关键在于贴合运行时的底层设计。遍历字典时,将 for k, v in d.items() 作为需要键值对时的首选习惯,使用直接迭代 for k in d 处理纯键逻辑,并在遇到动态增删诉求时果断采用 list(d) 浅快照或字典推导式,便能使代码在保持高可读性的同时,拥有最佳的执行性能与内存利用率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









