

非程序员为什么要学Python?财务、运营岗位的提效实战案例
深入解析财务与运营岗位学习Python的核心动力与实践场景,结合银行流水自动化对账、多渠道投放数据批量汇总两套完整代码实战,界定非程序员的实用技能边界与极简学习路径。
非程序员学习Python的终极目的从来不是转型成为软件工程师,而是获得一套在海量数据面前随时调用的“批量计算与自动化处理杠杆”。当日常办公中频繁遭遇数十万行数据跨表核对卡死、每天机械重复下载整理多个系统后台报表时,一段仅有几十行的Python脚本就能将数小时的手工搬运压缩为几秒钟的确定性计算,同时消除人工疲劳带来的录入差错。
一、Excel不够用了吗?业务岗位的工具边界与真实瓶颈
很多非技术岗位在被推荐学习编程时,常常会产生一个疑问:日常使用的表格软件功能已经十分丰富,透视表、条件格式与公式函数足以应对大部分统计,为什么还要额外学习一门计算机语言?
这个问题的答案并不在于工具的高低之分,而在于数据形态与作业规模的临界点。当业务发生以下变化时,常规表格软件的工作模式会迅速触碰瓶颈:
- 单表数据量与计算负载上限:日常使用的表格单表上限通常为1048576行。当单表记录超过10万行并嵌套多个VLOOKUP、XLOOKUP或SUMIFS公式时,文件计算耗时成倍增加,频繁出现界面无响应或闪退现象。
- 多源文件的异构与割裂:企业的真实业务数据极少集中在单一工作簿中。财务人员面对的是不同银行网银导出的不同排版格式流水,运营人员面对的是多个流量投放平台各不相同的报表字段。人工逐个打开、另存、复制、对齐字段的过程本质是低效搬运。
- 流程复用性与防错机制:人工在表格中拖拽公式、手动筛选和修改单元格,操作步骤无法形成防篡改的确定性日志。一旦原表数据发生行偏移或公式被意外覆盖,排查错误往往需要从头推倒重算。
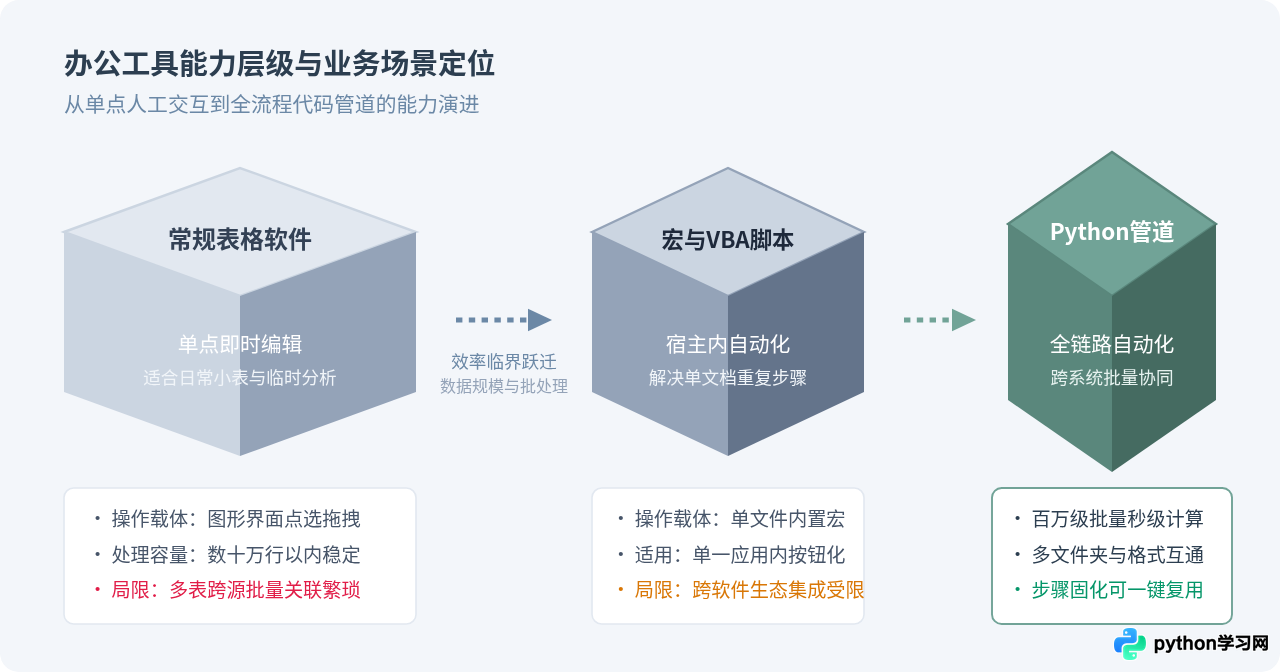
因此,非程序员学习Python的定位不是替代Excel进行所有的日常查看,而是作为**数据流水线的后台搬运工与清洗引擎**:把杂乱、分散、体量庞大的原始源文件经过固定脚本秒级清洗合并,直接输出最终整齐的汇总表交由业务人员审阅或汇报。
二、财务实战:银行对账单与内部ERP明细的自动化毫秒级核对
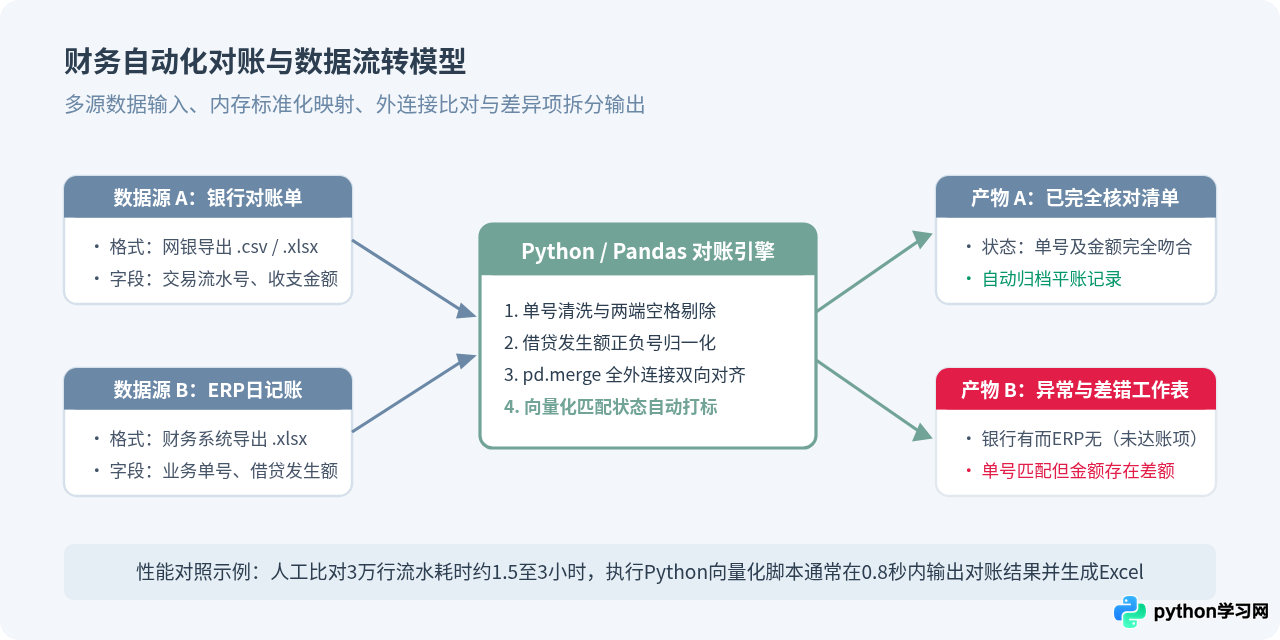
月末资金核对与发票核销是财务工作中最典型的重复性高耗时任务。以银行流水与企业内部ERP日记账核对为例,两边记录往往多达数万条,且存在两类常规难题:
- 格式不对齐:网银导出的流水中,交易流水号带有额外的前缀字母或空格;而ERP系统导出的单号去除了前缀;交易金额一侧记录为正负数,另一侧分为“借方”与“贷方”两列。
- 未达账项排查:财务人员需要在数万条明细中,迅速找出“ERP已记但银行未到账”以及“银行已扣款但ERP尚未入账”的差异项,同时对双方单号一致但金额有偏差的异常记录进行警报。
手工比对时,财务人员往往先用公式清洗字符串,再用VLOOKUP进行双向比对,最后手工筛选未匹配值并复制到差异表。一旦发现漏导了一张银行账户凭证,整个流程必须全部重做一次。
对账实操:基于Pandas的完整实现脚本
完成这个任务只需要安装Python的第三方数据处理库pandas与Excel支持库openpyxl。在命令行终端执行:
pip install pandas openpyxl随后编写如下对账脚本。代码通过merge(how='outer')实现全外连接,一次性标记出匹配成功、单边存在及金额不一致的全部情况:
import pandas as pd
import numpy as np

def run_reconciliation(bank_file, erp_file, output_file):
    # 1. 读取双方数据源
    df_bank = pd.read_excel(bank_file)
    df_erp = pd.read_excel(erp_file)

    # 2. 字段标准化清洗:去除单号空格,统一转为大写字符串
    df_bank['单号'] = df_bank['交易流水号'].astype(str).str.strip().str.upper()
    df_erp['单号'] = df_erp['业务凭证号'].astype(str).str.strip().str.upper()

    # 统一提取核对金额(保留两位小数避免浮点精度干扰)
    df_bank['银行金额'] = df_bank['交易金额'].round(2)
    df_erp['ERP金额'] = df_erp['发生额'].round(2)

    # 只保留核对所需字段
    b_clean = df_bank[['单号', '交易日期', '银行金额', '交易摘要']]
    e_clean = df_erp[['单号', '记账日期', 'ERP金额', '科目名称']]

    # 3. 使用全外连接 (Outer Join) 进行双向比对
    merged = pd.merge(b_clean, e_clean, on='单号', how='outer')

    # 4. 自动判定匹配状态
    conditions = [
        # 情况一:两边都有,且金额完全一致
        (merged['银行金额'].notna()) & (merged['ERP金额'].notna()) & (merged['银行金额'] == merged['ERP金额']),
        # 情况二:两边都有,但金额存在差异
        (merged['银行金额'].notna()) & (merged['ERP金额'].notna()) & (merged['银行金额'] != merged['ERP金额']),
        # 情况三:仅银行有记录(未入账或未达账)
        (merged['银行金额'].notna()) & (merged['ERP金额'].isna()),
        # 情况四:仅ERP有记录(银行尚未扣划)
        (merged['银行金额'].isna()) & (merged['ERP金额'].notna())
    ]
    choices = ['完全匹配', '金额不符', '银行单边存在', 'ERP单边存在']
    merged['核对状态'] = np.select(conditions, choices, default='其他异常')

    # 计算差额(若有一方为空则填充0后相减)
    merged['金额差异'] = (merged['银行金额'].fillna(0) - merged['ERP金额'].fillna(0)).round(2)

    # 5. 拆分工作表导出为统一的Excel审计报告
    with pd.ExcelWriter(output_file, engine='openpyxl') as writer:
        # Sheet 1: 异常差错汇总(优先关注)
        errors = merged[merged['核对状态'] != '完全匹配']
        errors.to_excel(writer, sheet_name='异常与未达账项', index=False)

        # Sheet 2: 完整平账记录
        matched = merged[merged['核对状态'] == '完全匹配']
        matched.to_excel(writer, sheet_name='核对一致记录', index=False)

    print(f"对账完成!总记录: {len(merged)} 条,异常差错: {len(errors)} 条。报告已输出至: {output_file}")

# 调用执行示例
if __name__ == "__main__":
run_reconciliation("2024_03_银行流水.xlsx", "2024_03_ERP日记账.xlsx", "资金对账审计报告.xlsx")pd.merge(how='outer')在底层一次遍历即可完成双向全集合并,无论数据增加到5万条还是50万条,代码行数与处理逻辑完全不变。
三、运营实战:多渠道投放日报的“一键合并与清洗”
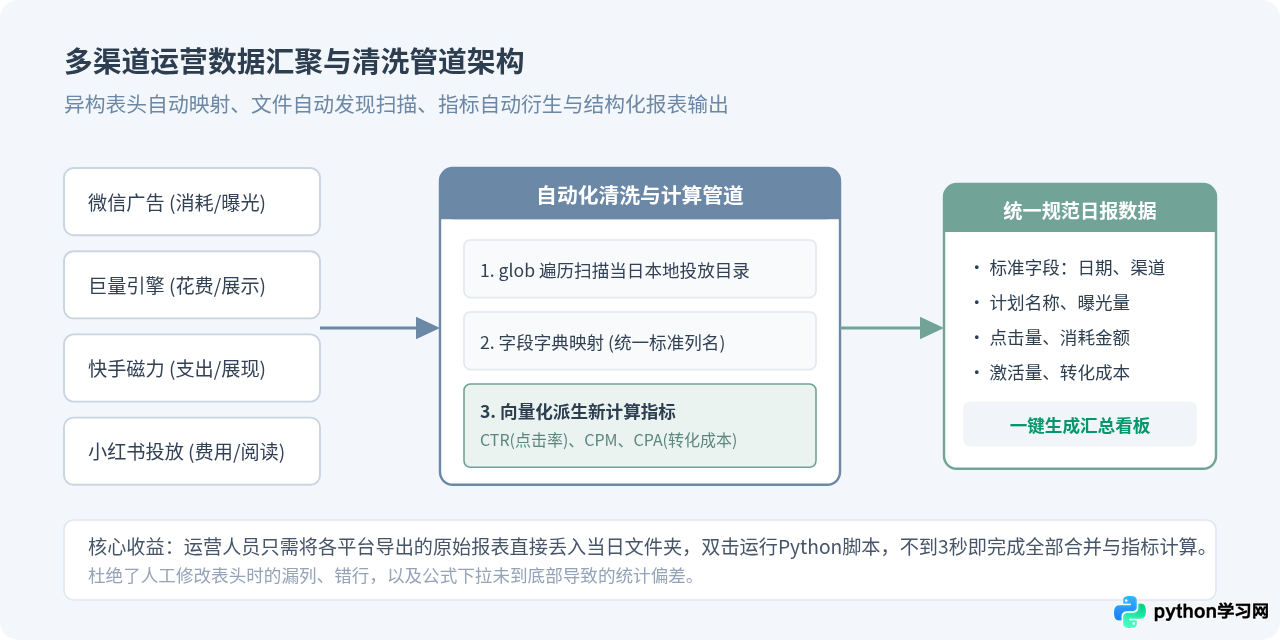
运营人员最常耗费时间的场景之一,是每个工作日上午整理跨渠道的推广数据。电商或增长团队通常同时在多个平台投放广告,例如巨量引擎(抖音)、微信朋友圈、小红书和快手。
每个广告平台后台导出的CSV或Excel报表有着各自独立的导出规范:
- 表头命名不统一:消耗金额在巨量叫“花费”,在微信广告叫“消耗”,在快手叫“账面支出”;展示量有的叫“展示数”,有的叫“展现次数”。
- 日期与维度混乱:日期格式有的带有斜杠(
2024/03/01),有的带横杠(2024-03-01),有的甚至带中文年月日;不同平台导出的汇总行经常混杂在数据底部。
如果依靠手工复制,运营人员每天需要逐个打开几十个文件,手动删除表头表尾、统一表头名称、复制粘贴进同一张工作表,再拖拽公式计算“千次展示成本(CPM)”与“转化成本(CPA)”。
运营实战:基于字典映射的自动化批处理脚本
以下脚本演示了如何使用Python自带的glob与os库扫描文件夹,配合pandas的字段重命名映射字典,实现多平台文件的无感自动合流:
import os
import glob
import pandas as pd

# 1. 建立各平台表头与标准列名的映射规则字典
COLUMN_MAPPING = {
    # 微信广告后台字段
    '消耗': '花费',
    '曝光量': '展示数',
    '点击数': '点击数',
    '广告计划': '计划名称',

    # 巨量引擎后台字段
    '消耗金额': '花费',
    '展示次数': '展示数',
    '广告组名称': '计划名称',
    '转化数': '激活数',

    # 快手磁力后台字段
    '账面支出': '花费',
    '展现数': '展示数',
    '封面点击数': '点击数',
    '行为数': '激活数'
}

def merge_channel_reports(raw_folder_path, output_excel_path):
    all_files = glob.glob(os.path.join(raw_folder_path, "*.*"))
    data_list = []

    for file_path in all_files:
        # 仅处理 csv 与 xlsx 文件
        if not (file_path.endswith('.csv') or file_path.endswith('.xlsx')):
            continue

        # 识别所属渠道(通过文件名约定,例如 "微信_20240301.csv")
        filename = os.path.basename(file_path)
        channel_name = filename.split('_')[0]

        # 读取文件
        if file_path.endswith('.csv'):
            df = pd.read_csv(file_path, encoding='utf-8-sig')
        else:
            df = pd.read_excel(file_path)

        # 重命名表头并剔除空行
        df = df.rename(columns=COLUMN_MAPPING)
        df['渠道名称'] = channel_name

        # 统一日期格式为 YYYY-MM-DD
        if '日期' in df.columns:
            df['日期'] = pd.to_datetime(df['日期']).dt.strftime('%Y-%m-%d')

        data_list.append(df)

    if not data_list:
        print("未检测到有效数据文件,请检查文件夹路径。")
        return

    # 纵向合并所有渠道数据
    full_df = pd.concat(data_list, ignore_index=True)

    # 补齐关键列并填充缺失值为0
    target_cols = ['花费', '展示数', '点击数', '激活数']
    for col in target_cols:
        if col not in full_df.columns:
            full_df[col] = 0
        else:
            full_df[col] = pd.to_numeric(full_df[col], errors='coerce').fillna(0)

    # 自动计算核心运营指标(避免除以0)
    full_df['CTR(点击率)'] = (full_df['点击数'] / full_df['展示数'].replace(0, float('nan')) * 100).round(2).fillna(0).astype(str) + '%'
    full_df['CPM(千次展示成本)'] = (full_df['花费'] / full_df['展示数'].replace(0, float('nan')) * 1000).round(2).fillna(0)
    full_df['CPA(单个激活成本)'] = (full_df['花费'] / full_df['激活数'].replace(0, float('nan'))).round(2).fillna(0)

    # 导出整合后的标准报表
    full_df.to_excel(output_excel_path, index=False)
    print(f"合并完成!共汇总 {len(full_df)} 条投放明细,输出至: {output_excel_path}")

# 执行调用
if __name__ == "__main__":
    merge_channel_reports("./daily_raw_data/", "运营多渠道合并汇总日报.xlsx")
四、非程序员的学习路径剪枝:坚决不学什么?
许多非技术人员在尝试学习编程时中途放弃,根源通常不是智力或逻辑问题,而是选错了教材和目标。传统计算机专业的教学路径是从计算机组成原理、底层内存管理、算法复杂度分析(如红黑树、动态规划)讲起,随后进入面向对象封装、继承、设计模式与大型网络后端开发。
对于财务与运营岗位而言,这类知识几乎与日常提效毫无关联。如果不加筛选地全盘照搬,往往会在繁复的概念中耗尽热情。
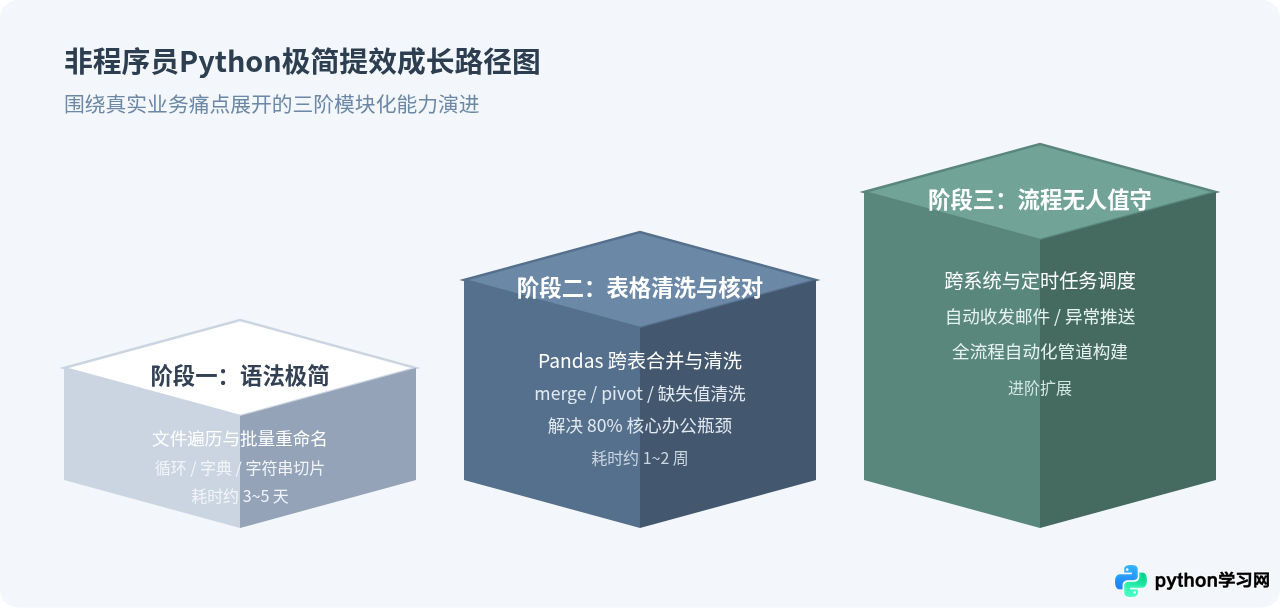
| 学习阶段 | 非程序员必须掌握的核心技能 | 可以坚决跳过的不相关内容 |
|---|---|---|
| 第一阶段:语法基础 | 变量类型(字符串、数字、布尔)、列表与字典的使用、for循环、if判断语句、函数的定义与调用。 | 面向对象高级特性(多重继承、元类)、装饰器底层原理、位运算、递归算法、底层垃圾回收机制。 |
| 第二阶段:表格数据处理 | pandas 基础结构(DataFrame)、列选取与过滤、透视表(pivot_table)、多表关联(merge/concat)、数据类型清洗。 | 复杂数据结构设计、二叉树算法、多线程高并发开发、数据库事务隔离级别。 |
| 第三阶段:办公工作流串联 | os 与 glob 批量扫描文件、读写 Excel / CSV / JSON、邮件自动发送(smtplib)、定时任务触发。 | Web 后端框架(Django / Flask)、全栈前端交互(Vue / React)、分布式微服务架构。 |
五、实操注意事项与避坑指南
在将代码应用到真实业务前,初学者应特别注意以下三个容易引发静默错误的技术细节:
- 文本编码与中文乱码:不同操作系统的默认编码存在差异。在Windows环境下,老旧系统导出的CSV常采用
GBK或ANSI编码,而现代软件普遍采用UTF-8或带BOM的utf-8-sig。在读取CSV时,如遇乱码报错,应明确指定encoding='utf-8-sig'或encoding='gbk'。 - 长数字单号被误转为科学计数法:银行流水单号、发票代码或快递单号通常长达15位以上。如果直接用默认方式读取,可能会被误当成浮点数处理为科学计数法(如
1.23457E+17),导致末尾数丢失。必须在读取时通过参数dtype={'业务单号': str}显式指定为文本类型。 - 原始数据保护原则:执行任何自动化脚本时,永远不要直接在原始文件上执行覆盖写入。应当始终建立单独的输出路径,保留输入源文件的只读状态,确保任何时候都能追溯原始审计依据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









