

Python怎么用id()函数打印变量的内存地址
详细讲解在Python中使用内置id()函数获取并打印变量内存地址的方法,包含十六进制转换技巧、变量引用本质、可变与不可变对象地址变化规则,以及小整数池与地址复用的底层陷阱。
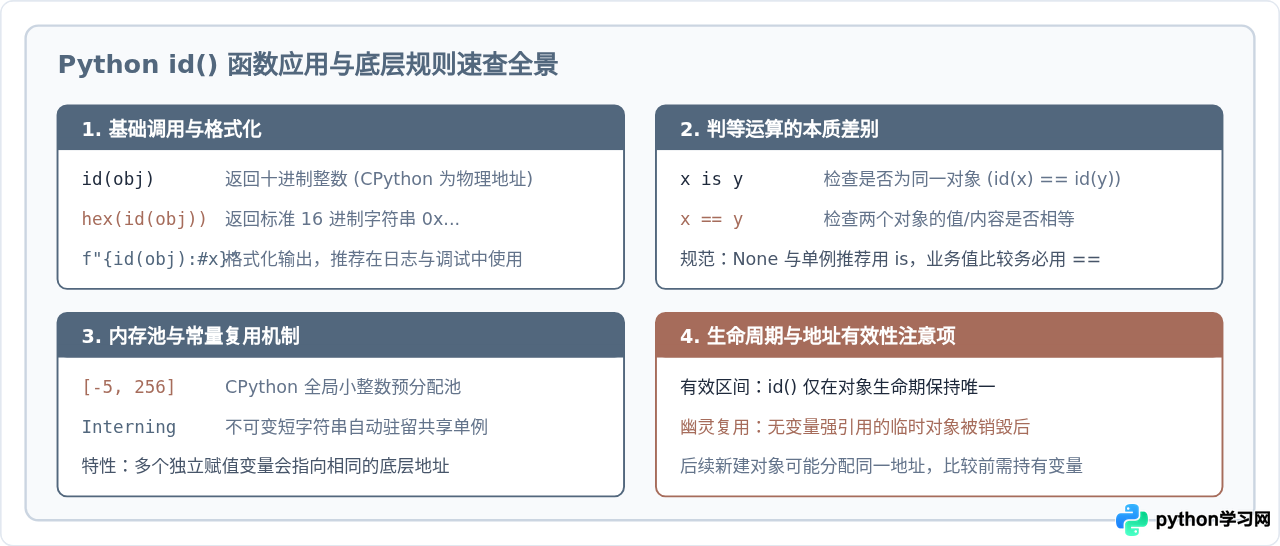
在 Python 中获取变量所指向对象的内存地址,最直接、标准的方式是使用内置函数 id()。调用 id(variable) 会返回该对象在生命周期内的唯一整数标识(在 CPython 解释器中即其实际内存地址);通过配合 hex() 函数或格式化字符串,可以方便地将其转换为程序员更熟悉的十六进制内存地址。
很多刚从 C/C++ 等编译型语言转向 Python 的开发者,往往习惯于“取地址符” &var 的思考方式。但在 Python 的世界里,变量名本质上只是指向堆中具体对象的“标签”或“引用”。要查看一个对象在底层的物理存放位置,官方提供的内置工具就是 id()。下面我们从最基础的调用开始,逐步掌握打印方法及背后的核心机制。
一、两行代码打印内存地址:基础操作与十六进制转换
在 Python 交互环境或脚本中,获取变量内存地址只需要两个步骤:将目标变量作为参数传递给 id(),随后通过打印函数输出。默认情况下,id() 返回的是一个十进制长整数。
# 基础用法:打印十进制内存标识
message = "Hello, Python"
address_dec = id(message)

print("十进制内存地址:", address_dec)在日常排查和调试中,阅读长串十进制数字并不直观。操作系统和调试器通常使用十六进制(如 0x1045aa370)表示内存指针。我们可以使用内置的 hex() 函数,或者直接借助 Python 的 f-string 语法将结果转为十六进制。
# 进阶用法:转换为规范的十六进制内存地址
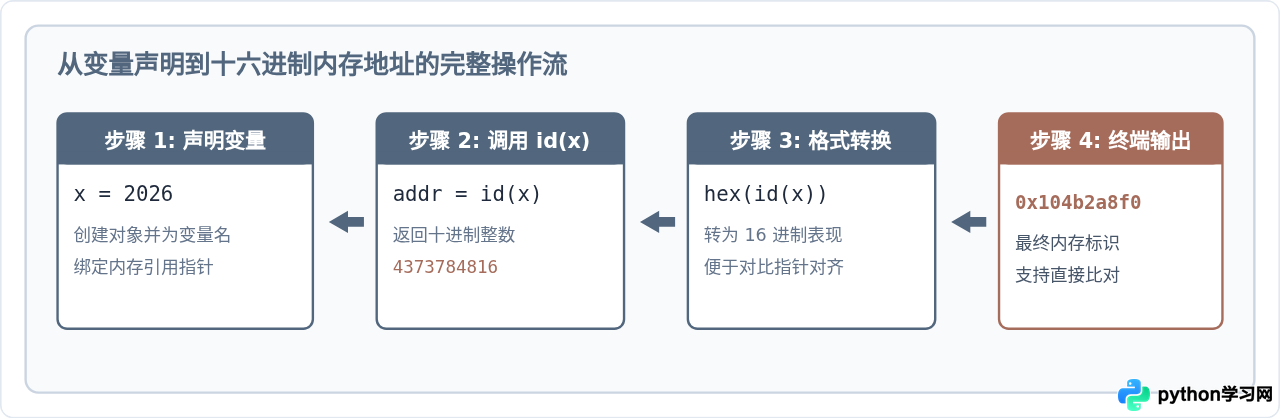
x = 2026

# 方法一:使用 hex() 函数
print("hex() 转换:", hex(id(x)))

# 方法二:使用 f-string 的 :#x 格式化(推荐,自带 0x 前缀)
print(f"f-string 转换: {id(x):#x}")f-string 转换: 0x104b2a8f0
二、变量与对象解耦:理解 id() 究竟在测什么
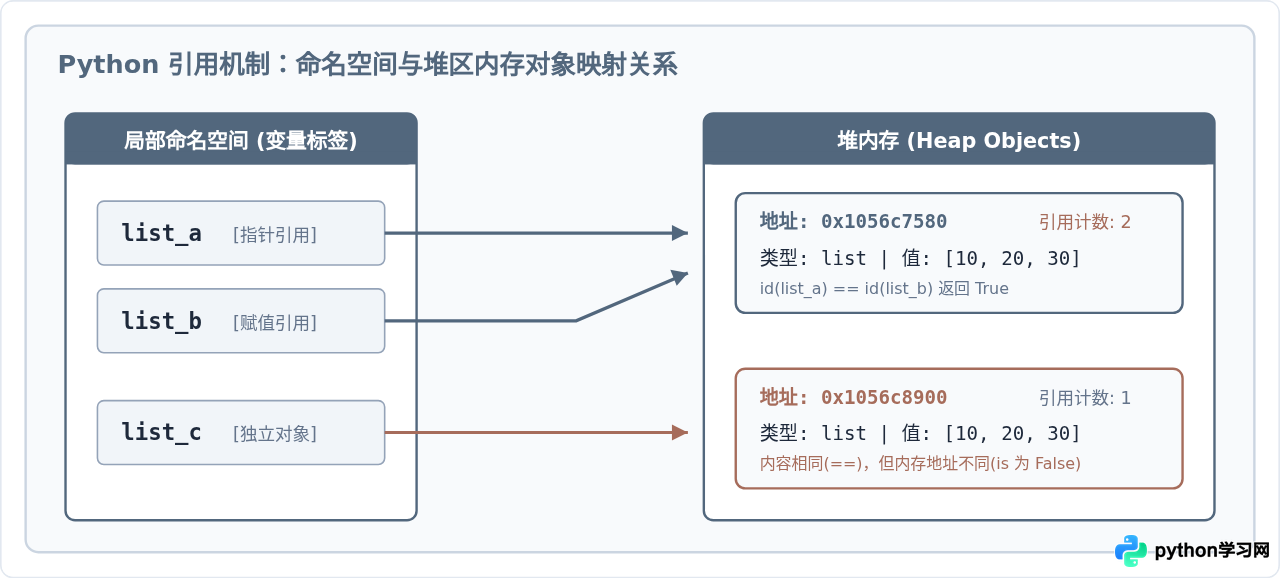
在 Python 中,id() 检测的并不是“变量名本身”的存储位置,而是变量名所引用的目标对象在内存堆中的地址。Python 内部并没有所谓“变量包含值”的容器模型,而是“对象在堆中存在,变量名只是指向该对象的引用”。
当我们把一个变量赋值给另一个变量时,例如 b = a,Python 并没有复制底层的内存数据,而是让 b 也指向 a 当前引用的同一个对象。因此,调用 id(a) 和 id(b) 得到的结果必然完全一致。
# 验证对象引用:多个变量指向同一内存实体
list_a = [10, 20, 30]
list_b = list_a  # 传递引用,而非深浅拷贝

print("list_a 内存地址:", hex(id(list_a)))
print("list_b 内存地址:", hex(id(list_b)))
print("是否指向同一对象:", list_a is list_b)list_b 内存地址: 0x1056c7580
是否指向同一对象: True
这里顺带引出了 Python 中两个常见操作符的本质区别:== 用于比较两个对象的内容(值)是否相等;而 is 关键字正是通过对比两者的 id() 是否相同,来确认它们是否为同一个内存实体。即 x is y 在底层等价于 id(x) == id(y)。
三、可变与不可变对象:为什么有时候地址会变?
在对变量进行修改操作后,再次调用 id(),可能会观察到截然不同的现象:有时内存地址始终不变,有时每次操作地址都在改变。这取决于变量所属的数据类型是可变对象(Mutable)还是不可变对象(Immutable)。
1. 不可变对象(int, float, str, tuple)
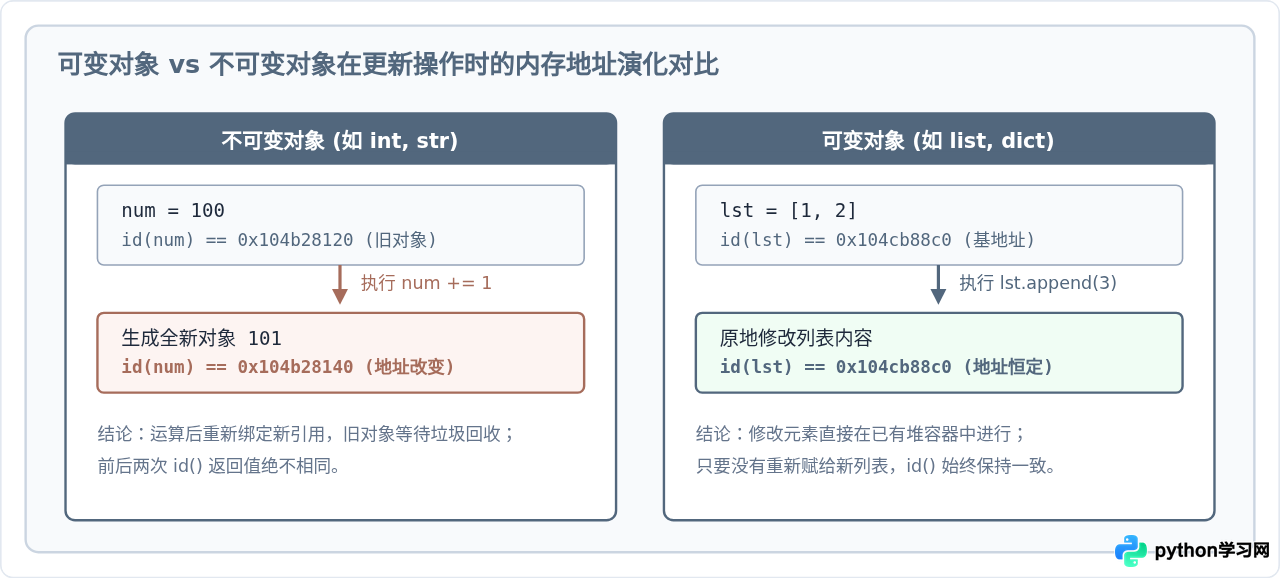
数值和字符串是不可变的。对一个整型变量执行 num += 1,并不是在原内存块上将数值修改,而是计算出新值后在内存中开辟一个新的整型对象,再把变量名绑定到新对象上。因此其 id() 一定会发生改变。
# 不可变对象每次修改都会生成新对象
counter = 100
print("运算前地址:", hex(id(counter)))

counter += 1
print("运算后地址:", hex(id(counter)))运算后地址: 0x104b28140
2. 可变对象(list, dict, set)
列表或字典允许“原地修改(In-place modification)”。当我们向列表中调用 append() 或修改字典键值时,Python 直接在原有内存区域中调整容器内容,变量名指向的依然是同一个容器对象,因此 id() 保持不变。
# 可变对象原地修改时保持相同地址
numbers = [1, 2]
print("append 前地址:", hex(id(numbers)))

numbers.append(3)
print("append 后地址:", hex(id(numbers)))append 后地址: 0x104cb88c0
四、底层特例与避坑提醒:小整数池与临时对象复用
在使用 id() 验证变量内存时,初学者经常会遇到两类反直觉的现象,理解它们有助于避免很多隐蔽的 bug。
1. 小整数对象池与常量缓存
如果在程序的不同地方分别创建两个值为 100 的整数,按常理应该分配两块独立内存,但测试会发现它们的 id() 完全相同:
val1 = 100
val2 = 100
print(id(val1) == id(val2))  # 输出: True
这是因为 CPython 在启动时预先开辟了一个全局静态对象池,预分配了范围在 [-5, 256] 之间的所有常用小整数。任何变量只要引用这个范围内的数值,都会直接指向该池中的单例对象。对于较短的字符串,CPython 也会触发类似的“字符串驻留机制(String Interning)”。
避坑提示:超出 [-5, 256] 的整数,在不同的代码块或交互式终端分步执行时,通常不会共享内存对象。因此在业务逻辑中,永远不要用 is 代替 == 判断数值或文本是否相等。
2. “幽灵”地址复用:未绑定变量的临时对象
观察下面这行看似荒谬的代码:
# 两个不同的空列表比较 id()
print(id([]) == id([]))  # 很多时候居然输出 True!
两个各自独立的空列表,为什么 id() 会相等?
原因在于对象的生命周期。当代码执行左侧的 id([]) 时,Python 在内存中创建了一个临时空列表,计算出它的内存地址后,因为没有任何变量引用它,该列表立刻被垃圾回收释放。随后执行右侧的 id([]),内存分配器发现刚才释放的那块内存正好空闲且合适,于是立刻复用了该物理地址。根据官方文档规范,id() 仅在对象的存活期内保证唯一,生命周期不重叠的对象复用同一块内存是完全合法的。
五、总结:id() 使用准则与核心要点
掌握 id() 函数不仅是为了打印一串内存数字,更是深入理解 Python 内存模型与引用传递的一把钥匙。在实际工作中,可以归纳为以下几条实践准则:
- 查看指针:首选
f"{id(x):#x}"或hex(id(x))获取标准十六进制表示。 - 判等本质:
a is b实质就是检查id(a) == id(b);比较值内容请一律使用==。 - 生存期约束:确保比较
id()时,参与比对的对象都被变量有效持有,防止临时变量释放导致地址被误复用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









