

为什么不建议在Python中滥用全局变量
深入解析在Python项目中滥用全局变量的核心弊端,涵盖隐式状态依赖、测试污染与并发隐患,并提供清晰的参数化与类封装重构路径。
在编写Python脚本时,直接在模块顶层定义全局变量并在函数内部通过 global 关键字修改它,往往看起来是最快捷的传参方式。然而,一旦代码规模从几十行的简单脚本扩展为多人协作或长期维护的项目,过度使用可变全局变量就会迅速演变成架构上的硬伤。不建议滥用全局变量的核心原因在于:它破坏了函数封装的自包含性,引入了隐式且不可控的执行时序依赖,使得单元测试难以隔离,并在多线程环境下产生难以复现的数据竞争。本文将详细剖析全局变量带来的具体隐患,并给出清晰规范的重构方案。
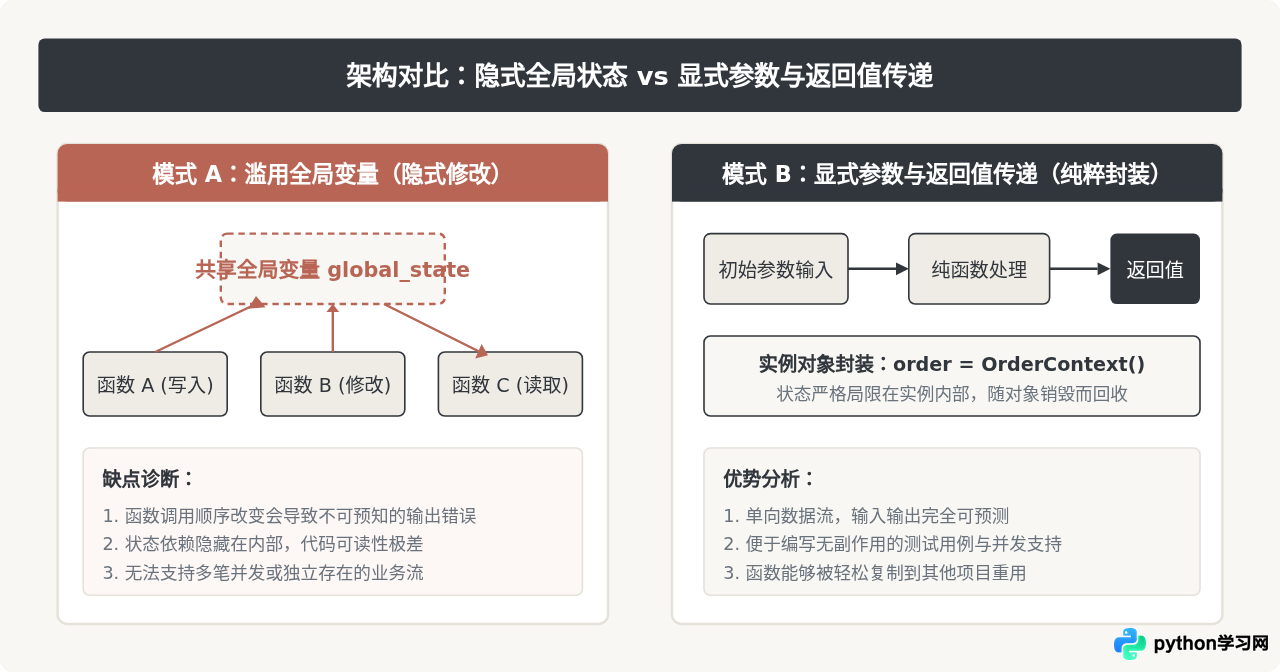
一、隐式数据流与被破坏的函数封装
编写高质量代码的一个基本准则是让函数的输入和输出保持清晰。一个良好的函数就像一个透明的处理器:输入通过参数传递,处理结果通过返回值输出。当函数开始依赖或修改外部全局变量时,这种清晰的关系就被彻底破坏了。
来看一个典型的反面示例:
# 反面示例:通过全局变量维持状态
order_items = []
total_amount = 0.0

def add_item(name, price):
    global total_amount
    order_items.append(name)
    total_amount += price

def apply_discount(rate):
    global total_amount
    total_amount *= rate

def print_receipt():
    print(f"商品清单: {order_items}, 应付总额: {total_amount:.2f}")
表面上看,这段代码逻辑简单直接。但在实际维护中,add_item 和 apply_discount 内部悄悄改变了模块外的全局变量 total_amount。阅读函数签名 def add_item(name, price) 的人无法直接得知它会篡改外部的计费状态。调用者必须通读整个函数内部实现,甚至顺藤摸瓜查看所有调用了这些函数的地方,才能搞清楚 total_amount 在某一时刻到底是多少。
二、单元测试的灾难:状态残留与时序耦合
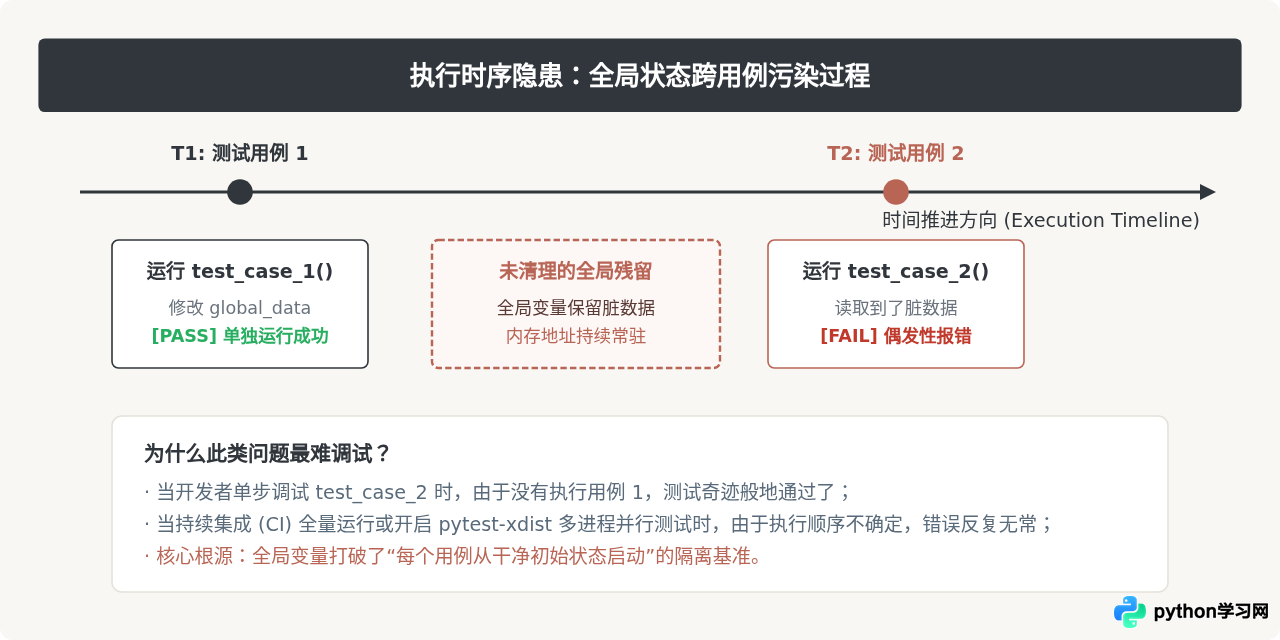
全局变量带来的第二大硬伤是破坏了测试用例的独立性。在自动化测试框架(如 pytest 或 unittest)中,各个测试用例应该具备完全独立的运行环境,无论按什么顺序执行,结果都应当一致。
但是,当被测代码依赖并修改全局变量时,前一个测试执行完毕后留下的全局变量状态,会悄无声息地污染下一个测试用例:
# 示例:由于全局状态残留导致测试脆弱
# shopping.py
cart = []

def add_to_cart(item):
    cart.append(item)
    return len(cart)

# test_shopping.py
def test_add_single_item():
    assert add_to_cart("苹果") == 1  # 执行通过

def test_add_another_item():
    # 如果单独运行该测试,它是通过的;
    # 但如果紧接着 test_add_single_item 运行,cart 中已经有“苹果”,此时长度为 2!
    assert add_to_cart("香蕉") == 1  # 报错断言失败:2 != 1
这种测试用例之间的隐式耦合极为致命。测试的成败不再取决于代码本身的逻辑,而是取决于测试用例被框架发现和执行的先后顺序。一旦引入了多进程或随机排序执行测试,就会产生难以排查的间歇性偶发故障。
三、多线程并发与数据竞争
在涉及多线程或异步编程的场景中,滥用全局变量会直接演变为数据一致性问题。在CPython中,虽然有全局解释器锁(GIL)保证同一时间只有一个Python字节码线程在执行,但GIL并不能保护多步复合操作的原子性。
例如,以下代码在多个线程同时累加全局计数器时,极易发生数值丢失:
import threading

counter = 0

def worker():
    global counter
    for _ in range(100000):
        # counter += 1 在底层包含三步字节码:LOAD_GLOBAL, BINARY_ADD, STORE_GLOBAL
        # 线程切换发生在中间就会导致计数丢失
        counter += 1

threads = [threading.Thread(target=worker) for _ in range(5)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(f"预期计数: 500000, 实际结果: {counter}")
# 示例输出: 预期计数: 500000, 实际结果: 324105
全局变量对于整个进程内的所有线程是无差别共享的。若想安全地在线程间共享状态,要么必须显式引入互斥锁(threading.Lock),要么必须使用线程局部变量(threading.local)或更先进的消息传递队列(queue.Queue)。滥用普通全局变量只会制造不可控的数据竞争与死锁风险。
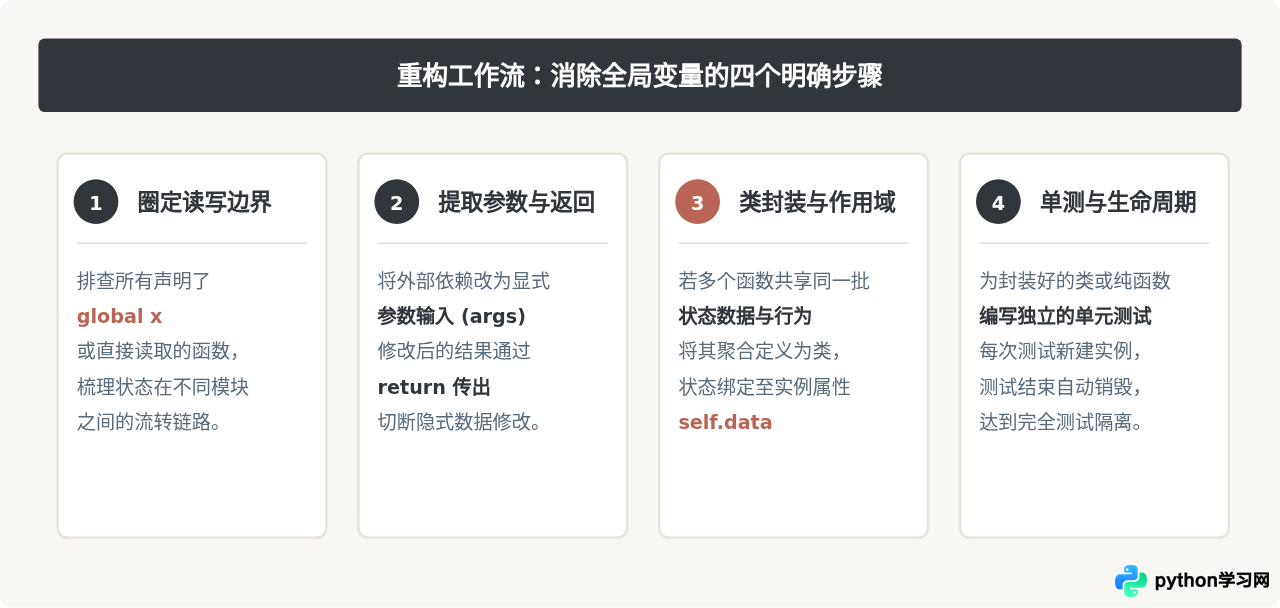
四、重构实操:将全局变量改造为规范架构的四个步骤
面对已经存在或者正在滋生全局变量的代码,如何按部就班地进行重构?以下是工业界推荐的清晰重构四步法:
重构实操代码演进
将第一节中的购物车代码按照上述步骤进行面向对象封装:
# 正确做法:将状态与行为封装为类
class ShoppingCart:
    def __init__(self):
        self.items = []
        self.total_amount = 0.0

    def add_item(self, name: str, price: float) -> None:
        self.items.append(name)
        self.total_amount += price

    def apply_discount(self, rate: float) -> None:
        self.total_amount *= rate

    def get_summary(self) -> dict:
        return {
            "items": list(self.items),
            "total_amount": round(self.total_amount, 2)
        }
现在,当我们在单元测试或实际业务中使用时:
def test_cart_discount():
    cart = ShoppingCart()
    cart.add_item("机械键盘", 400.0)
    cart.apply_discount(0.9)
    assert cart.get_summary()["total_amount"] == 360.0

def test_cart_independent():
    cart = ShoppingCart()
    cart.add_item("鼠标", 150.0)
    # 不会受到上一个测试中 400.0 键盘的任何干扰
    assert cart.get_summary()["total_amount"] == 150.0
每一个 ShoppingCart 实例拥有自己独立的内存堆空间,生命周期清晰明确。当函数执行完毕离开作用域后,Python的垃圾回收器(GC)会自动回收无引用的对象,完全杜绝了全局内存泄漏与状态残留。
五、理性看待:哪些场景可以使用全局定义?
反对滥用全局变量,并不意味着要在代码中彻底消灭所有模块级变量。在Python中,有一类全局定义不仅不被反对,反而是官方PEP 8推荐的标准做法:不可变的模块级常量与配置。
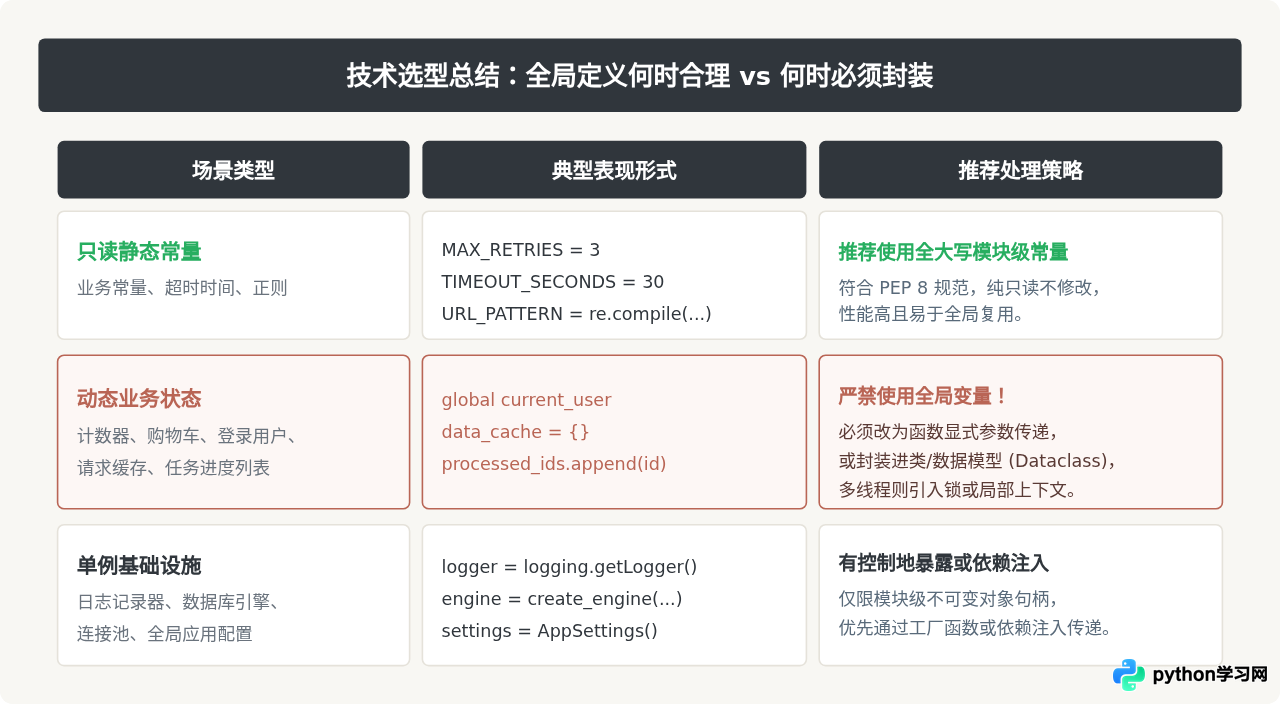
总结
在Python开发中,滥用全局变量本质上是用“眼前的编写省事”换取“长期的维护噩梦”。它破坏了面向对象与函数式编程倡导的高内聚、低耦合原则,带来了不可预测的隐式数据流、脆弱的自动化测试以及并发竞争风险。在实际编码中,只要坚持以下三条底线,就能彻底远离全局变量的泥潭:
- 坚持显式优于隐式:优先通过形参和返回值传递数据,让函数的依赖与产出一目了然;
- 使用面向对象聚合状态:凡是有生命周期、需要跨步骤更新的状态数据,一律封装进类实例或上下文管理器;
- 严格区分常量与状态:全大写的模块级常量仅用于不可变静态配置,绝不在运行时对其赋值或追加内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









