

为什么Python字符串是不可变的?从内存组成看安全性
在 Python 中,字符串(str 对象)一旦创建就不能在原地修改其内容。任何看似改变字符串的操作,实际上都在底层重新分配了内存并生成全新对象。这种“不可变性”(Immutability)不仅是语法层面的约束,更是由 CPython 底层严密的紧凑内存结构直接决定的。理解不可变性背后的内存组成,能够清晰看到 Python 设计者在哈希表绝对安全、多线程并发无锁保障以及系统调用边界防篡改等关键工程场景中的深刻考量。
一、深入 CPython 底层:字符串的紧凑内存组成
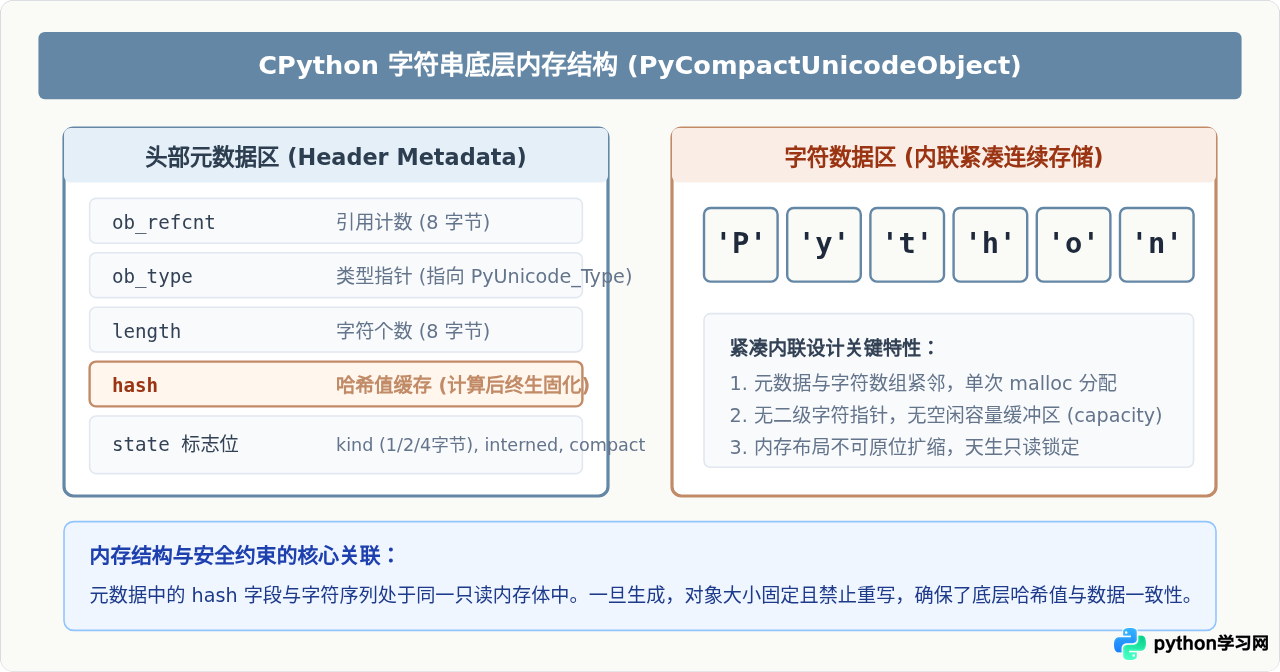
许多初学者认为字符串内部包含一个类似列表的字符指针数组,可以像修改列表元素那样通过索引直接替换字符。但在 CPython 实现中,字符串的内存管理采用了截然不同的策略。在 Python 3(自 PEP 393 引入灵活字符串表示法 Flexible String Representation)之后,字符串对象在底层由 PyCompactUnicodeObject 结构体实现。
与可变对象(如 list)预留容量缓冲区并包含额外动态指针不同,Python 字符串在内存中是一整块完全连续、紧凑分配的单一内存区域:
- 标准对象头部(PyObject_HEAD):包含
ob_refcnt(引用计数)和ob_type(指向str类型定义的指针),这是所有 Python 对象的基础管理元数据。 - 紧凑基础元数据:包含
length(字符实际个数)、hash(已计算的哈希值缓存,初始为 -1)以及若干位域标志位state(记录字符宽度类别、驻留状态 interned、是否紧凑存储等)。 - 连续字符数据区(Data Buffer):紧随元数据末尾,字符的二进制编码(Latin-1、UCS-2 或 UCS-4)直接以内联方式存储在同一内存块中,并以
\0结尾以兼容 C 语言函数。
由于元数据与字符内容合并在同一个 malloc 连续区块内,字符串结构体中根本不存在指向外部可扩容缓冲区的动态指针,也没有预留未使用的空闲容量(capacity)。这种紧凑设计的直接结果就是:一旦该内存块分配完成,字符数据的大小、偏移与长度便永久固化,无法在原位插入或截断字符。
二、从哈希缓存与数据结构看安全性:为什么字典键绝不能改变
Python 语言的核心基石是字典(dict)与集合(set)。从模块全局命名空间、类属性表、实例字典 __dict__ 到作用域变量检索,Python 的执行几乎处处依赖字典。而字典能保持 O(1) 级别的高速检索,前提就是键(Key)必须是可哈希(Hashable)且不可变的。
在 PyCompactUnicodeObject 中,专门有一个字段 hash 用于缓存哈希结果。当一个字符串首次被计算哈希值(例如调用 hash("username") 或存入字典)时,C 底层会计算 64 位整型哈希并写入该字段;后续再次获取哈希值时,将直接读取该字段,无需重复遍历字符重新计算,性能极高。
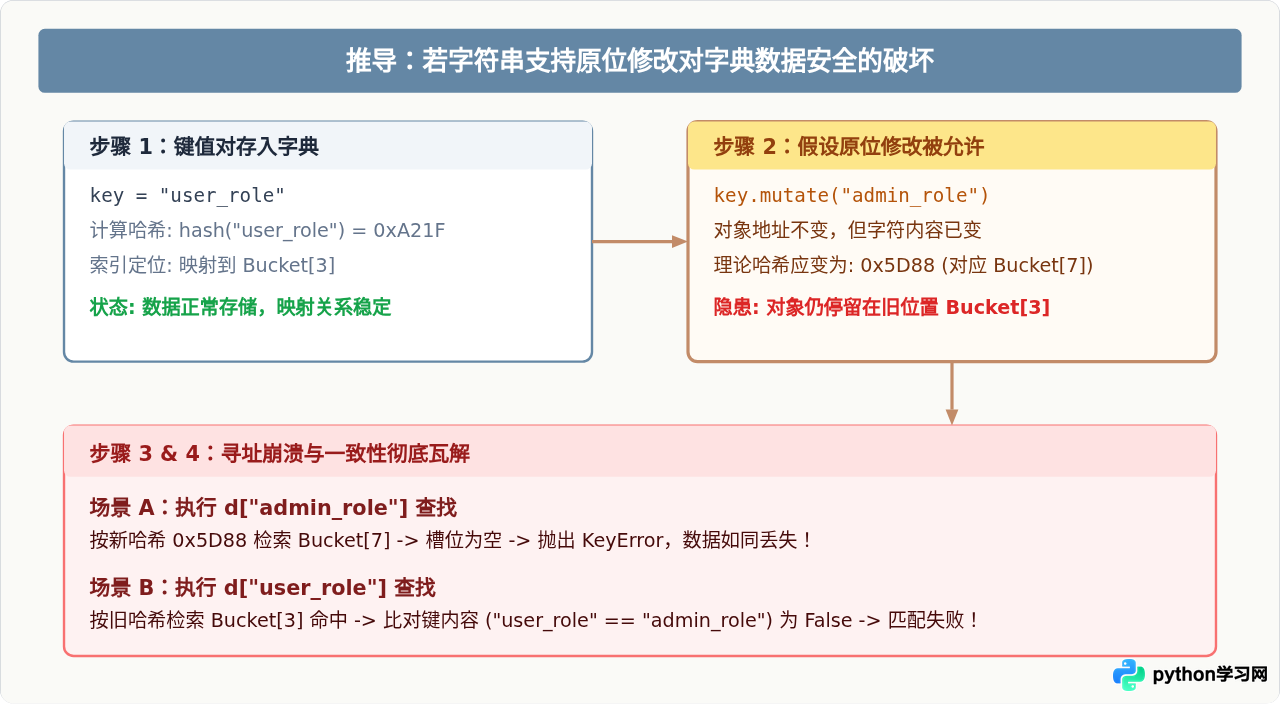
现在我们进行推导:如果 Python 允许字符串原地修改,字典和哈希表会发生何种灾难?
- 哈希索引与存储桶位置完全错乱:字典根据键的哈希值对哈希表长度进行掩码运算,决定将键值对放置在哪个哈希槽位(Bucket)。若字符串可变,当键的内容改变时,其真实的哈希值理应随之改变,但它仍驻留在旧哈希值对应的槽位中。
- 数据“离奇失踪”引发应用逻辑崩溃:使用修改后的字符串去字典查找时,Python 计算出新哈希值并定位到新的槽位,该槽位为空,直接抛出
KeyError;而如果使用旧字符串查找,由于键的内容已变,字符串比较(__eq__)返回False,同样无法找到数据。数据在内存中存在,却在字典中永久失联。 - 唯一性约束失效导致命名空间污染:字典要求键的唯一性。如果允许修改键,两个原本不同的键可能在修改后内容变得完全相同,从而在一个字典中出现多个重复键,直接摧毁解释器的符号查找与类属性绑定。
三、系统与应用层安全:防范隐式篡改与 TOCTOU 竞争
除了解释器内部数据结构的健壮性,字符串在现代软件中承载着大量核心安全载荷:文件路径、网络 URL、数据库连接串、SQL 语句模板、系统环境变量以及鉴权 Token。字符串的不可变性是操作系统与业务代码之间最牢固的安全屏障之一。
1. 杜绝传参时的“隐式篡改”(Side-Effect Mutation)
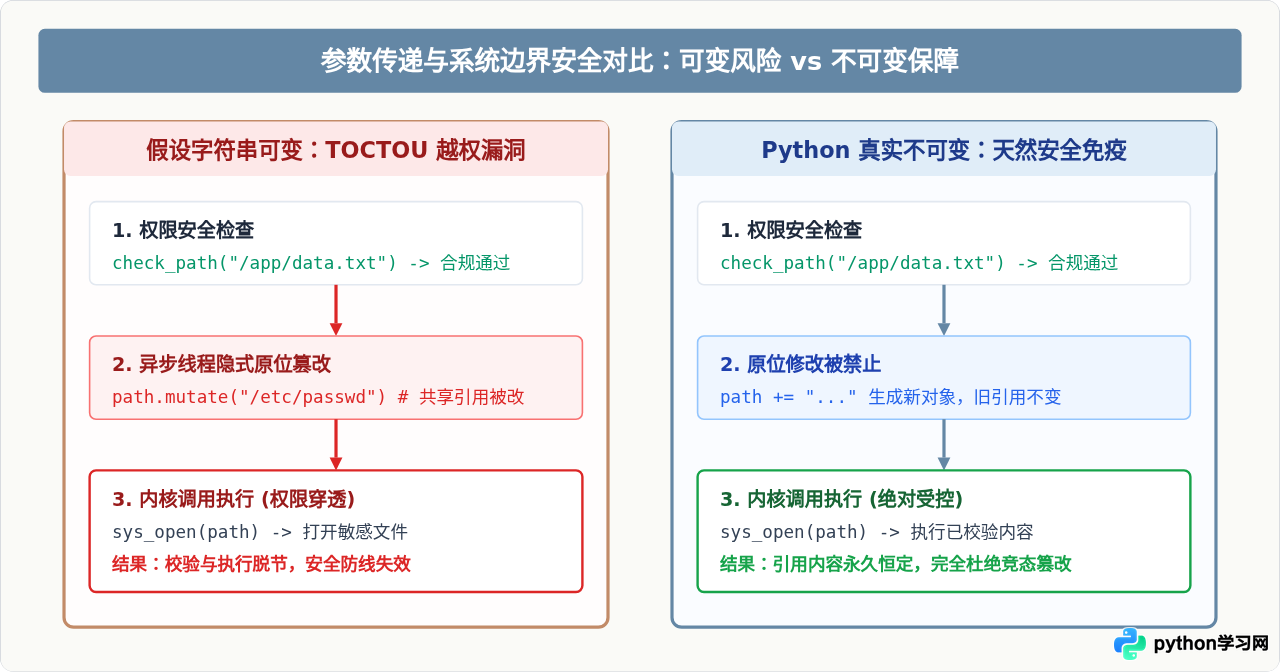
在 Python 中,函数参数传递本质是“对象引用的共享传递”(Pass by Object-Reference)。如果字符串是可变的,当主调方将一个配置字符串传给不受信任的第三方库或插件函数时,被调用方可以在原位修改字符串字节。这会导致主调方在毫无感知的情况下,关键参数(如 api_endpoint = "https://safe.api.com")被暗中替换为恶意地址。
2. 防御检查到使用时间差竞争漏洞(TOCTOU 漏洞)
在安全工程中,TOCTOU(Time-of-Check to Time-of-Use)是一种常见的漏洞模型:系统先对参数进行安全合规性校验(如检查文件路径是否在允许的沙箱目录内),然后再调用底层系统内核执行读取(如 open(path))。
如果字符串可变,在多线程并发环境中就会产生竞态条件:
# 伪代码:假设字符串是可变对象
def read_secure_file(filepath):
    if not is_safe_path(filepath):    # 1. 检查阶段:验证 filepath 为 "/data/safe.txt"
        raise PermissionError("非法访问")

    # 线程在此处发生上下文切换!
    # 另一恶意线程原位修改 filepath 内容为 "/etc/shadow"

    return os.open(filepath)          # 2. 执行阶段:实际打开了敏感越权文件!
正是由于 Python 字符串在内存层面上彻底禁止了原地修改,任何对 filepath 的重新赋值或修改尝试都只能在全新内存地址上创建一个新对象,绝不会波及已经通过校验的原字符串引用。这种特性从语言底层消除了对字符串进行“防御性深拷贝”(Defensive Copying)的开销与编码负担。
四、性能与资源的协同:不可变带来的额外工程红利
不可变性除了筑牢安全防线,在运行时系统资源的利用率上也带来了巨大的工程优化空间:
- 字符串驻留机制(String Interning):对于满足特定规则的不可变字符串(如合法的 Python 标识符、小段常量),CPython 运行时在全局维护一个驻留表(
interned字典)。相同的字符串在整个进程生命周期中仅在内存中分配一份单例。当执行两个驻留字符串的比较a == b时,解释器底层首先直接比较两者的指针地址(a is b),只需一次 CPU 指针比对即可完成判定,极大加速了代码中变量命名寻址与属性访问。 - 多线程并发读安全(Thread-Safety):在多线程编程中,数据竞争(Data Race)往往源于“并发读写”。由于字符串不可修改,任何线程对其进行读取都具备天然的只读并发安全性,多线程共享字符串常量无需加互斥锁,彻底规避了锁竞争与死锁开销。
- 紧凑分配与零碎片:可变序列(如动态数组)为了支持
append等扩展操作,必须预先分配额外的容量余量(Over-allocation),这会造成大量内存碎片与闲置内存占用。不可变字符串在创建时精准计算字符长度,单次分配、大小精准契合,极大节省了系统内存开销。
五、常见操作误区与正确处理方案
在实际编码中,很多开发者因观察到变量内容被重新赋值,而误以为字符串可以被原位修改,进而引发严重的性能或逻辑隐患。
误区 1:认为 s += "abc" 是在原字符串上追加
观察以下代码示例:
s1 = "hello"
print("修改前 id:", id(s1))  # 示例输出: 4352817200

s1 += " world"
print("修改后 id:", id(s1)) # 示例输出: 4353199856在上述过程中,id(s1) 的变化明确证实了 s1 已经指向了一个全新的内存对象。虽然 CPython 在特定单引用场景(引用计数为 1 且无其他共享)对 += 做了尝试重用内存的微优化,但在编写业务代码时绝不能依赖此假设。
在长循环中如果频繁使用 s += chunk,在无法命中内存重用微优化的常规情况下,每次追加都会在内存中重新申请空间并完整拷贝历史字符,导致整个算法退化为 O(n^2) 复杂度。正确的工业级做法是将片段推入列表,最后使用 "".join(str_list) 一次性完成单次内存分配与拼接。
误区 2:在需要频繁修改字符时强行使用 str
如果业务场景确实需要高频、原位的字符或字节读写(例如加密流解析、网络二进制协议解码、大型文本编辑缓冲区),不应频繁切片拼接字符串,而应选择专门的可变类型:
bytearray:针对二进制数据的可变字节数组,支持原地切片与按索引赋值。io.StringIO:在内存中模拟文件句柄的可变字符缓冲区,适合分段写入后统一产出最终不可变字符串。
六、核心逻辑与安全价值全景总结
回顾 Python 字符串的不可变性设计,它是底层 C 内存架构与高层语言安全目标完美协同的典范:
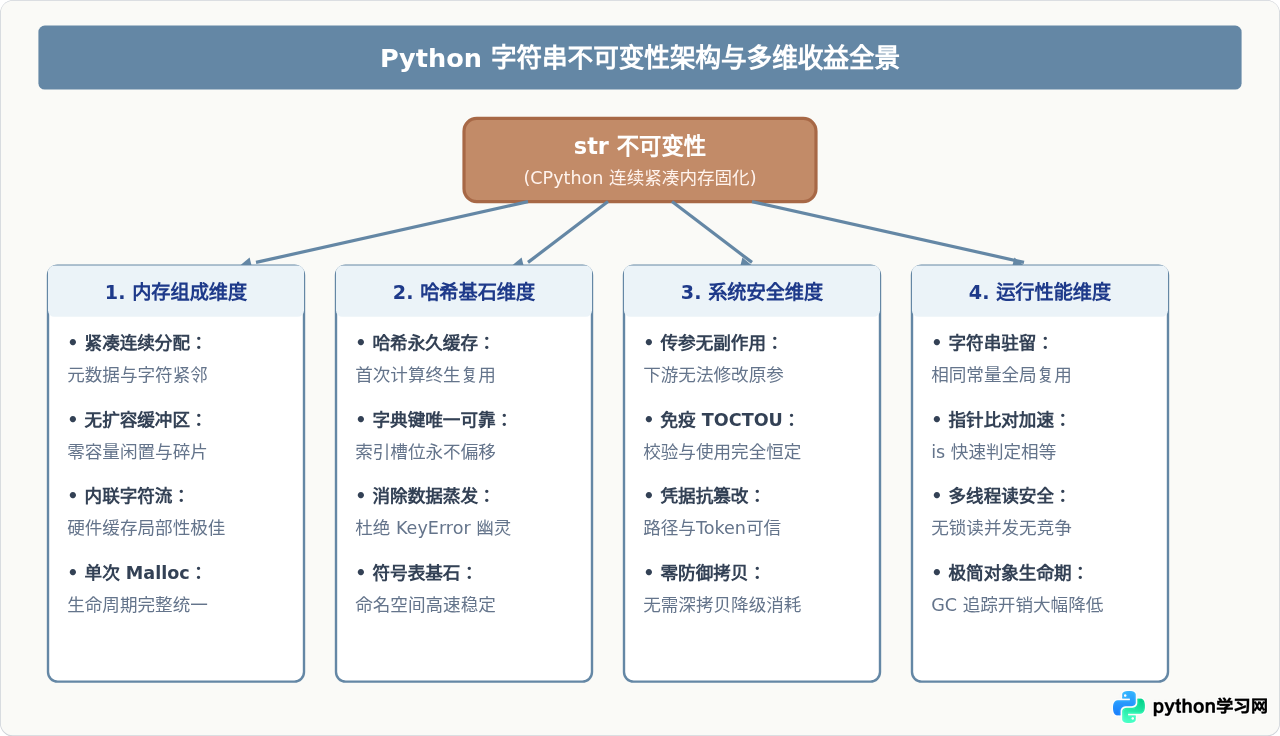
通过 CPython 紧凑内存布局、哈希缓存机制以及应用层安全设计的层层保障,Python 字符串的不可变性不仅彻底杜绝了数据在哈希表内部“蒸发”与并发竞争的隐患,更为现代高并发、高安全要求的生产系统提供了最为坚实可靠的底层基础设施。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









