

Python中实时读取并打印Linux命令的执行输出流
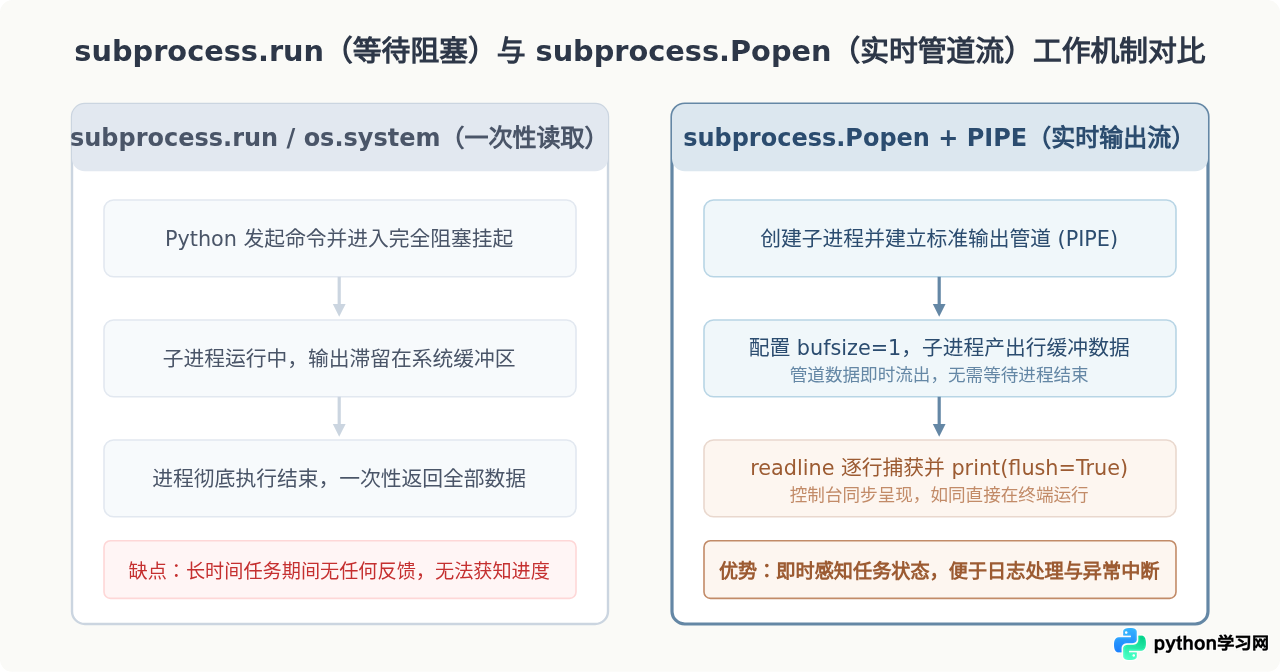
subprocess.Popen 并将标准输出定向为管道(stdout=subprocess.PIPE),开启文本模式与行缓冲(text=True, bufsize=1),随后通过 iter(process.stdout.readline, '') 进行逐行迭代,并在调用 print 时显式指定 flush=True。这一方案绕过了常规阻塞式执行等待,保证子进程产出新行时主程序能够立即捕获并输出到控制台。
为什么常规方法无法实现实时输出
日常编写自动化脚本时,很多开发者习惯使用 os.system() 或 subprocess.run()。这些函数在设计上属于同步阻塞式调用:它们会等待外部命令彻底执行完毕,然后一次性返回命令退出码或完整的输出文本。如果调用的命令耗时较长(例如使用 ping 持续探测网络、运行大型编译任务或执行长时间的备份脚本),控制台在整个执行期间将没有任何动态反馈,如同程序陷入假死状态。
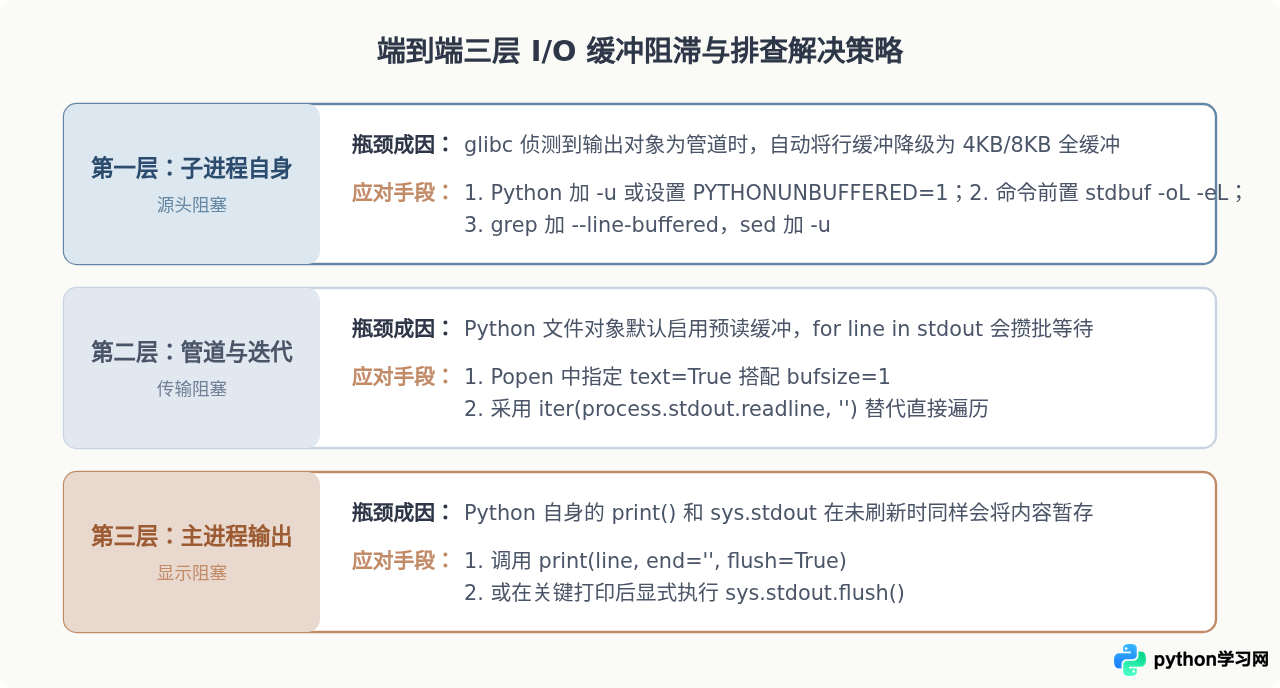
即便改用了提供管道能力的 subprocess.Popen,如果仅使用常规的文件遍历方式(如 for line in process.stdout),依然常常遇到输出延迟的问题。其深层原因在于 Linux 的 C 标准 I/O 库(glibc)中内置的三种缓冲机制:
- 无缓冲(Unbuffered): 数据直接写入目标设备,标准错误(stderr)默认采用此模式。
- 行缓冲(Line Buffered): 遇到换行符
\n时立即刷新缓冲区。当输出端连接到交互式终端(TTY)时,Linux 命令的标准输出(stdout)默认采用行缓冲。 - 全缓冲(Fully Buffered): 仅当内部缓冲区被写满(通常为 4KB 或 8KB)或者程序正常退出时,才会执行真正的 I/O 写入。当标准输出被重定向到非 TTY 目标(例如管道 Pipe 或常规文件)时,glibc 会自动将原本的行缓冲降级为全缓冲。
使用 subprocess.Popen 实时读取的标准实现
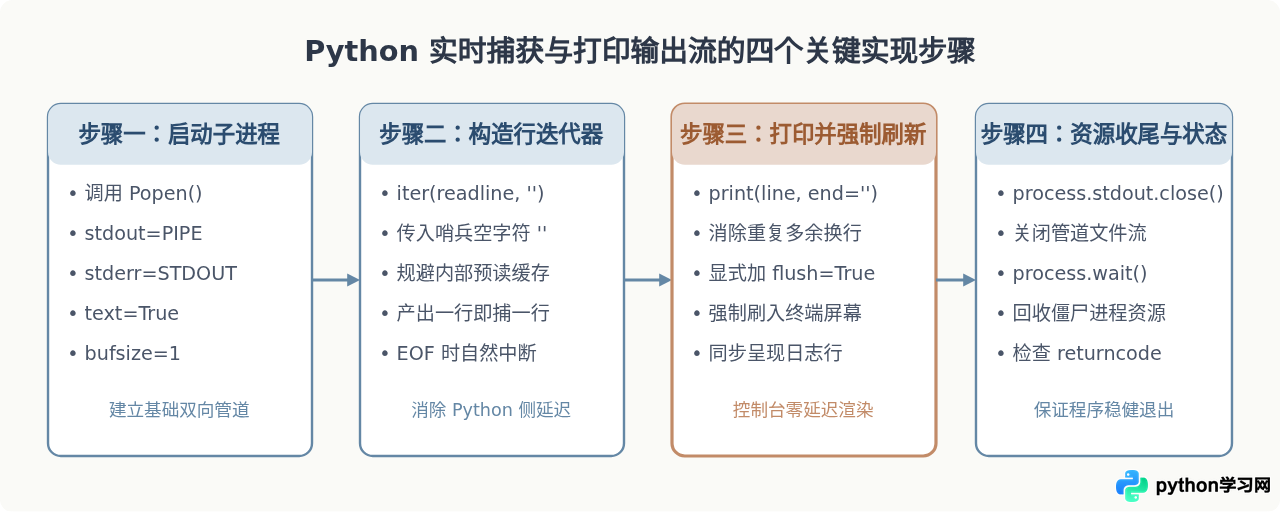
要打破多层缓冲的阻塞,需要让 Python 在管道一端作为消费者,一旦操作系统管道中有换行符分隔的新数据,就立刻触发读取并刷新显示。以下是实现实时读取并打印的标准代码范式:
import subprocess
import sys

def run_command_realtime(cmd):
    """
    实时执行 Linux 命令并逐行打印输出
    :param cmd: 命令列表或字符串
    """
    # 1. 启动子进程并建立管道
    process = subprocess.Popen(
        cmd,
        stdout=subprocess.PIPE,
        stderr=subprocess.STDOUT,  # 将标准错误合并到标准输出流
        text=True,                 # 以文本模式读写(自动根据系统编码解码为 str)
        bufsize=1                  # 启用行缓冲模式
    )

    # 2. 逐行读取输出流并即时打印
    # 使用 iter(readline, '') 防止 Python 内置迭代器的块预读
    for line in iter(process.stdout.readline, ''):
        print(line, end='', flush=True)

    # 3. 释放资源并获取执行结果
    process.stdout.close()
    return_code = process.wait()
    return return_code

if __name__ == '__main__':
    # 示例:执行持续产生输出的 ping 命令
    test_cmd = ['ping', '-c', '4', '127.0.0.1']
    exit_code = run_command_realtime(test_cmd)
    print(f"\n[任务完成] 退出码: {exit_code}")
核心参数与方法深度解析
stdout=subprocess.PIPE: 在操作系统层面开辟一条管道,将子进程的输出重定向到 Python 可以直接读取的文件描述符。stderr=subprocess.STDOUT: 将标准错误流合并到标准输出流中。这样可以避免因为分别读取两个独立的管道而引发死锁(后文会专门分析此问题)。text=True(或universal_newlines=True): 让管道直接提供str字符串而非原始bytes,由 Python 自动按照系统默认编码(在 Linux 上通常为 UTF-8)进行行分隔与转码。bufsize=1: 强制让 Python 的文件对象工作在行缓冲模式下。注意该参数仅在text=True时起效。iter(process.stdout.readline, ''): 这一写法至关重要。如果直接使用for line in process.stdout,Python 会在底层启用预读缓冲(readahead buffer)以优化批量 I/O 性能,这会导致数行输出被积压在 Python 内部直到凑足一定字节数才一次性产出。而iter(callable, sentinel)每次循环都显式调用readline(),一旦读到哨兵值(EOF 时的空字符串'')即刻终止,完全规避了预读滞后。print(..., end='', flush=True): 因为readline()读取的内容尾部已经包含了换行符\n,所以需要设置end=''防止输出空行;而flush=True会立即刷新 Python 自身的sys.stdout,防止数据卡在 Python 主进程的输出缓冲区中。
解决外部程序自身的缓冲阻塞问题
很多时候,尽管在 Python 主程序中完整配置了 bufsize=1、iter(readline, '') 和 flush=True,执行某些命令时依然无法看到即时输出,必须等程序结束时才猛然涌出一大片内容。这种现象通常并不是 Python 代码写错了,而是被调用的子进程自身正在进行全缓冲。
如前所述,当被调用的 Linux 命令检测到其标准输出不是终端而是管道时,C 运行时环境会自动启用 4KB/8KB 的块缓冲。只要子进程没有输出满这几千个字节,它就根本不会执行 write() 系统调用向管道写入数据,位于管道另一端的 Python 自然也就无物可读。
针对不同子进程的具体解决方法
| 子进程类型 | 成因分析 | 解决方案 |
|---|---|---|
| Python 脚本 (如 python script.py) |
Python 解释器在标准输出重定向到管道时默认开启缓冲。 |
1. 在调用命令中加入 -u 参数:['python', '-u', 'script.py']2. 或传递环境变量 env={'PYTHONUNBUFFERED': '1', **os.environ}
|
| 常见 Linux 文本工具 (如 grep, sed, awk) |
glibc 对标准 I/O 采用了默认的全缓冲机制。 |
• grep 使用专用参数:grep --line-buffered• sed 使用无缓冲参数: sed -u• awk 在打印后主动刷新: print; fflush()
|
| 通用二进制程序 / C程序 (未提供行缓冲参数的命令) |
第三方程序写死或使用标准库默认缓冲,未暴露控制开关。 |
使用 Linux 系统自带的 stdbuf 工具包裹运行:['stdbuf', '-oL', '-eL', './my_program'](通过 LD_PRELOAD 强制将 stdout 和 stderr 设置为行缓冲) |
stdbuf 属于 GNU coreutils 工具集,几乎所有标准 Linux 发行版均已预装。需要注意的是,stdbuf 依赖 LD_PRELOAD 拦截标准 C 库函数,因此仅对动态链接 C 标准库的程序生效;如果调用的目标是 Go 编写的静态编译二进制文件,stdbuf 将不起作用,此时需在子程序源码内调用 os.Stdout.Sync() 或借助下文介绍的伪终端技术。
进阶场景:分别处理标准输出与错误流防范死锁
在前文的示例中,我们使用了 stderr=subprocess.STDOUT 将两个流合并。但在某些工程需求中,必须区分正常业务输出(stdout)与异常报警信息(stderr)。
此时绝对不能在同一个单线程内按顺序执行两遍迭代(例如先读 stdout 再读 stderr)。因为操作系统为管道分配的内核缓冲区容量是有限的(在现代 Linux 上通常为 64KB)。如果子进程向 stderr 写入了超过 64KB 的报错内容,而主线程正阻塞在等待 stdout 的循环中,子进程就会因为管道写满而被内核挂起,主线程也在等待子进程继续吐数据,两者相互等待,造成永久死锁。
正确的做法是使用多线程或者 selectors 模块进行 I/O 多路复用。以下给出双线程独立消费两个流的完整参考实现:
import subprocess
import threading

def stream_reader(pipe, prefix):
    """独立线程读取函数"""
    try:
        with pipe:
            for line in iter(pipe.readline, ''):
                # 打印时带上前缀以区分通道
                print(f"[{prefix}] {line}", end='', flush=True)
    except Exception as e:
        print(f"[{prefix} 读取异常]: {e}", flush=True)

def run_with_separated_streams(cmd):
    process = subprocess.Popen(
        cmd,
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE,  # 分离标准输出与标准错误
        text=True,
        bufsize=1
    )

    # 分别创建两个守护线程并行读取
    stdout_thread = threading.Thread(target=stream_reader, args=(process.stdout, "STDOUT"))
    stderr_thread = threading.Thread(target=stream_reader, args=(process.stderr, "STDERR"))

    stdout_thread.start()
    stderr_thread.start()

    # 等待子进程执行完毕
    return_code = process.wait()

    # 确保读线程把管道中残留的数据全部读取完毕
    stdout_thread.join()
    stderr_thread.join()

    return return_code
总结与最佳实践清单
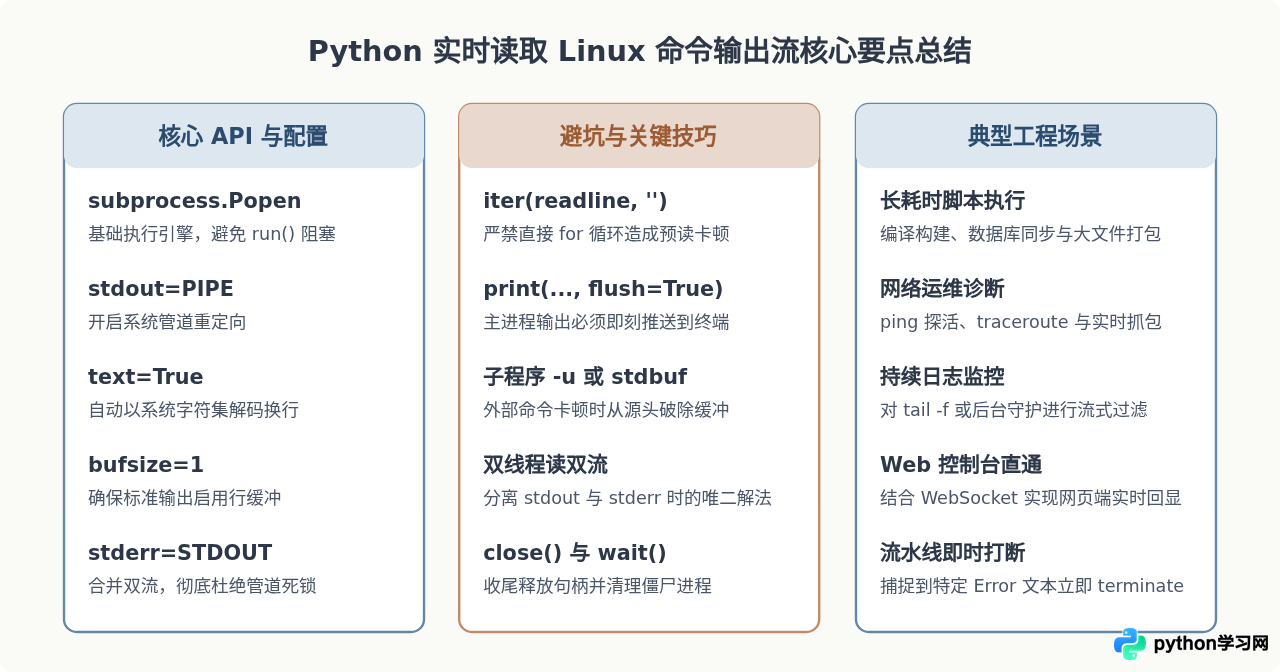
在 Python 中实现实时打印 Linux 命令输出,本质上是一场对抗“全缓冲机制”的协调工作。从子进程的底层 C 库、中间的管道文件描述符,到 Python 自身的运行时与终端输出,每一个环节都必须保持流式无阻畅通。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









