

Python多行字符串拼接与换行符处理技巧

在 Python 日常开发中,编写长 SQL 语句、组织多行错误提示、生成邮件正文或输出格式化报告时,常常需要处理跨越多行的字符串。很多初学者容易将“代码编辑器的视觉换行”与“字符串内部包含的换行符”混为一谈,导致代码缩进污染了输出结果,或者生成了意外的连续空行。本文聚焦于 Python 多行字符串拼接机制与换行符清洗技巧,帮助读者掌握优雅编写多行文本并精准控制换行符的方法。
一、代码折行与真实换行符的本质差异
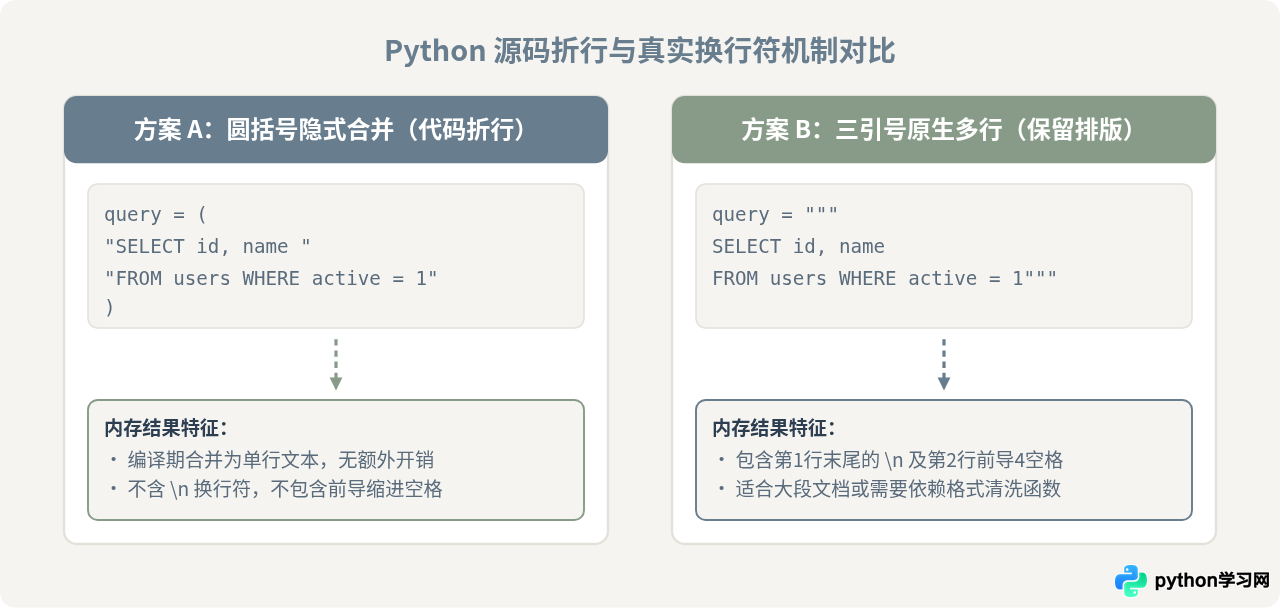
在 Python 语法中,换行存在两种截然不同的含义:第一种是逻辑行的折行,仅为了让源代码符合 PEP 8 行宽规范(不超过 79 或 88 字符),在生成的字符串对象中不应产生任何换行;第二种是字符层面的显式换行,要求最终字符串中包含换行控制符(如 \n)。
如果使用三引号(''' 或 """),Python 会将源码中的物理换行以及每一行前面的缩进空格全部完整保留在字符串中。而在函数或类内部,代码本身存在 4 空格或 8 空格的缩进,这些前导空格往往会作为字符串的一部分被无意输出。相反,如果使用小括号 () 包裹相邻的独立字符串字面量,Python 解释器在词法分析阶段就会自动将它们隐式合并,既不引入额外的换行符,也不会掺杂缩进空格。
二、常见多行字符串拼接方式及适用场景
掌握不同拼接工具的特性,才能在兼顾代码可读性的同时,产出符合预期的字符串。
1. 圆括号隐式拼接(推荐用于长语句与无换行文本)
利用 Python 的词法合并机制,将多个字符串字面量置于同一对小括号内,解释器会在字节码编译阶段将其拼接为一个整体。这种方式运行效率最高,零内存二次分配成本。
# 示例:长文本与长URL折行书写
url = (
    "https://api.example.com/v1/resources"
    "?filter=active"
    "&sort=created_at_desc"
    "&limit=100"
)
# 输出结果为单行长字符串,中间无空格和换行符
注意: 相邻字符串之间若需要空格隔开(例如拼装 SQL 关键字),必须在字面量末尾或下一行开头显式留出空格,否则会粘连在一起。
2. 三引号结合 textwrap 模块(推荐用于结构化多行模板)
编写嵌套在函数内部的多行提示语或长 Markdown 模板时,三引号不可避免会受到外部缩进的影响。标准库提供的 textwrap.dedent() 可以检测所有非空行的公共前缀缩进并统一去除:
import textwrap

def generate_report(user_name, score):
    template = f"""
        报告生成通知:
        尊敬的 {user_name} 用户:
        您本次评测的得分为:{score} 分。
        请核对信息。
    """
    clean_text = textwrap.dedent(template).strip()
    return clean_text
配合 .strip() 能够去除首行三引号换行产生的多余空行以及末尾空行,让排版既美观又干净。
3. str.join() 方法(推荐用于动态行与批量数据处理)
如果多行内容来自于一个动态列表、可迭代对象或生成器表达式,str.join() 是绝对的首选。它在底层只做一次内存分配,性能远胜反复用 + 进行累加,并且能精准指定行与行之间的换行符。
lines = [
    "第一章:Python基础概念",
    "第二章:函数与模块化设计",
    "第三章:高级迭代器与生成器"
]

# 精准控制:使用单个换行符拼接
toc = "\n".join(lines)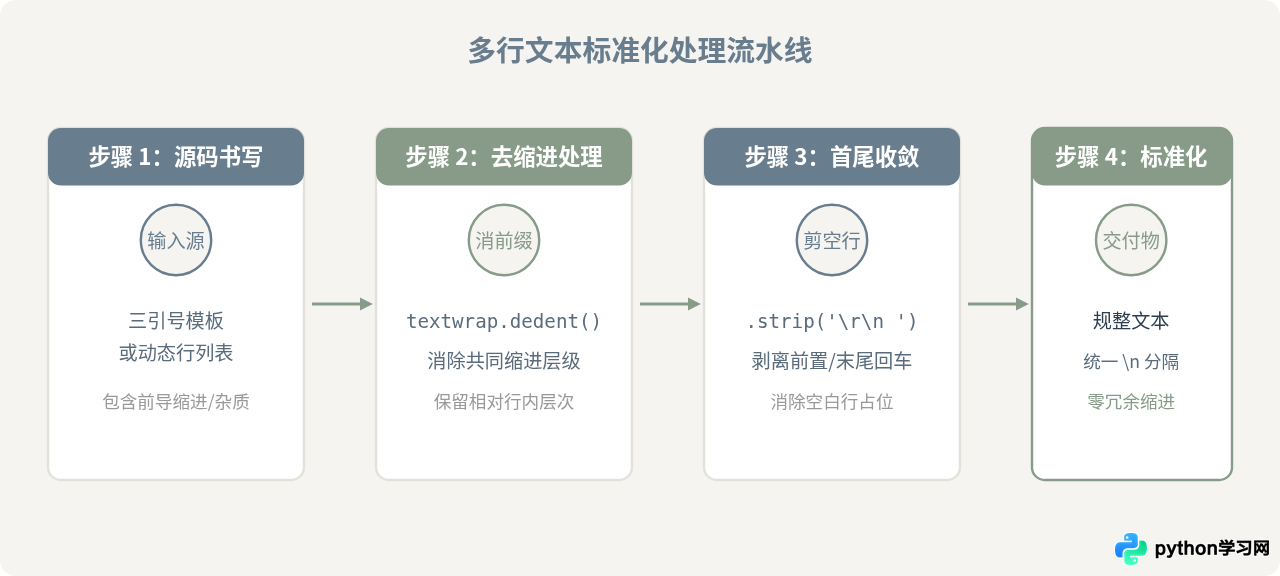
三、换行符清洗与跨平台兼容技巧
在网络数据传输或跨平台运行(如 Windows 与 Linux 混用环境)时,换行符可能呈现多种形式:Windows 采用 \r\n (CRLF),Linux/macOS 采用 \n (LF),早期旧版 Mac 系统还会使用 \r (CR)。如果直接根据 \n 做切分,残存的 \r 会引发字符串解析异常或在终端中覆盖输出。
1. 使用 splitlines() 实现全类型换行符解耦
处理多行文本时,尽量避免直接使用 text.split('\n')。Python 内置的 str.splitlines() 支持识别包括 \r\n、\n、\r 在内的所有常见换行符:
raw_data = "Item 1\r\nItem 2\nItem 3\rItem 4"

# 自动处理不同换行符,且默认剥除换行符本身
clean_items = raw_data.splitlines()
# clean_items: ['Item 1', 'Item 2', 'Item 3', 'Item 4']

# 重新组装为统一的 Linux 换行符
unified_text = "\n".join(clean_items)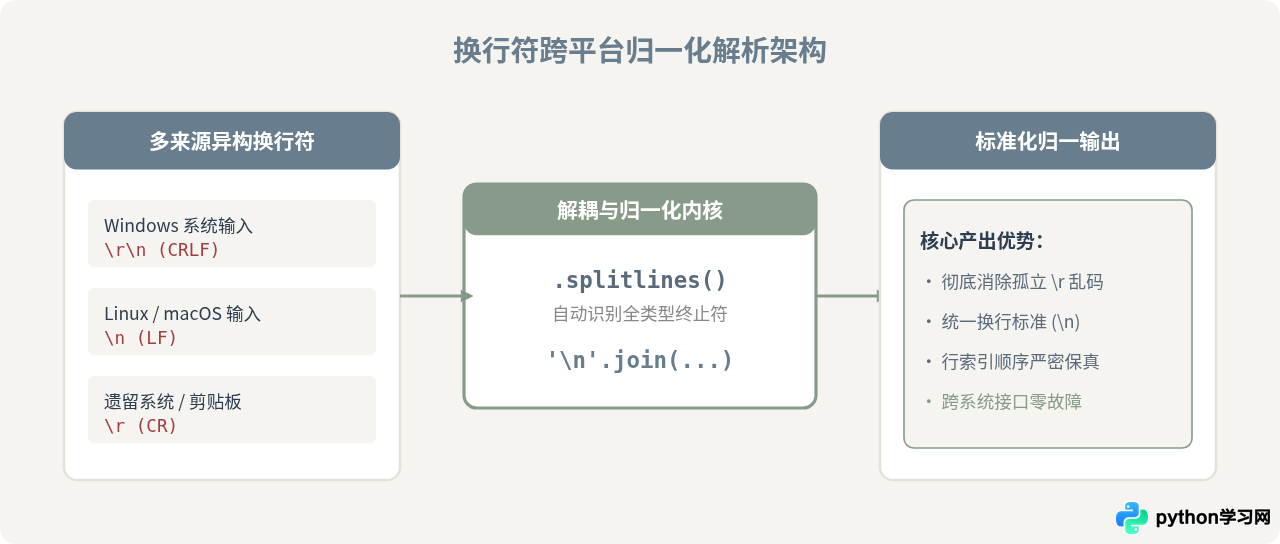
2. 行过滤与紧凑压缩
在处理含有空行的输入文本时,结合列表推导式或生成器表达式可以完成高效率的空行过滤:
text_with_blanks = """
    配置项 1: 启用

    配置项 2: 禁用

    配置项 3: 默认
"""

# 过滤空白行并消除首尾空格
clean_lines = [
    line.strip()
    for line in text_with_blanks.splitlines()
    if line.strip()
]
compact_result = "\n".join(clean_lines)
四、常见易错陷阱与避坑指南
陷阱一:在循环内使用加号 + 拼接大量多行字符串
在 Python 中,字符串是不可变对象。每次执行 text += line 都会在内存中创建全新的字符串对象并拷贝全部已有内容。当循环达到数千次时,耗时会从毫秒级暴增至秒级。解决方案:始终使用列表收集行数据,并在最后统一调用 "\n".join(rows)。
陷阱二:忽略首行与尾行的换行符
很多开发者在书写三引号时习惯在开头和结尾直接按回车换行:
msg = """
第一行内容
第二行内容
"""
这会导致 msg 的开头多出一个 \n,结尾也多出一个 \n。如果后续操作依赖精确行数,就会凭空多出两行空文本。如果希望在代码中保持换行美观同时不生成前置换行,可在三引号后立即添加反斜杠 \:
msg = """\
第一行内容
第二行内容\
"""
反斜杠 \ 会转义掉物理换行符,使字符串真正从“第一行内容”开始。
五、多行字符串拼接方案选型总结
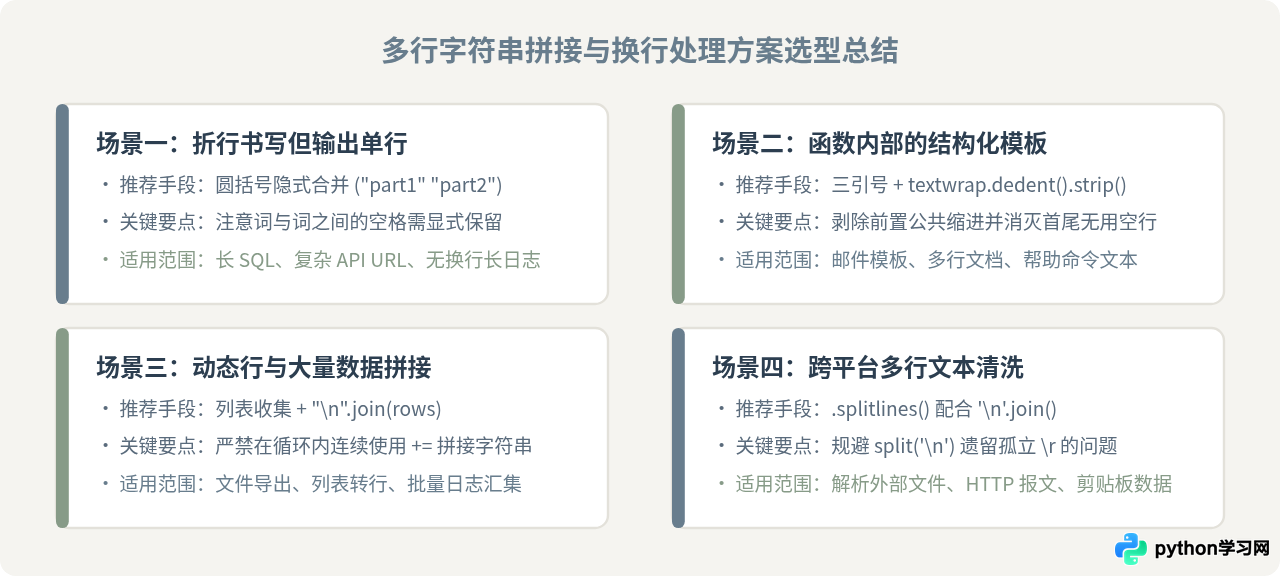
为了在实际开发中快速做出最合理的选择,可参考以下对比决策表:
| 拼接方案 | 主要用途 | 换行符表现 | 前导缩进影响 | 性能表现 |
|---|---|---|---|---|
| 圆括号隐式合并 | 长 SQL、长 URL、代码折行 | 默认无换行,纯净单行 | 无影响(安全) | 极高(编译期完成) |
| 三引号 + dedent | 多行 Markdown、邮件模板、提示语 | 保留换行,支持结构化排版 | 需 dedent 剥除缩进 | 中等(需运行期处理) |
| str.join() | 动态数据渲染、文件逐行组装 | 完全由连接符参数严格指定 | 取决于单行内容 | 高(底层单次分配) |
| 三引号 + 反斜杠转义 | 精确定位边界的多行常量文本 | 精确跳过转义行,保留指定行 | 受代码缩进影响 | 高(字面量直接加载) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









