

Python下载文件时怎么处理超时异常和自动重试?

在编写 Python 脚本下载网络文件时,最容易遭遇的偶发问题莫过于网络抖动、DNS 响应迟缓或目标服务器暂时性过载导致的请求卡死与连接断开。如果不作专门控制,Python 默认的请求行为可能会无限期挂起进程,或者在遇到第一个瞬时波动时直接崩溃抛错。稳健的解决路径是明确区分“连接超时”与“读取超时”,并通过为会话挂载具备退避算法的重试适配器(如 requests.adapters.HTTPAdapter 与 urllib3.util.Retry),在协议层实现受控的无感知重试。本文将从异常分类判定、两阶段超时配置、通用自动重试策略构建以及大文件流式断点续传四个核心维度,展开可直接落地的具体解决方案。
一、认识两阶段超时:连接超时与读取超时
在使用常用 HTTP 库(如 requests)时,很多开发者习惯简单地传入一个单一数值,例如 requests.get(url, timeout=10),或者完全省略 timeout 参数。这种做法隐藏着严重的隐患:省略参数时,底层 socket 处于阻塞状态,若服务端只接收连接而不返回数据,程序将永久休眠;而单一浮点数虽然同时约束了连接与读取,却无法针对网络握手与大文件传输的不同耗时特征分别调优。
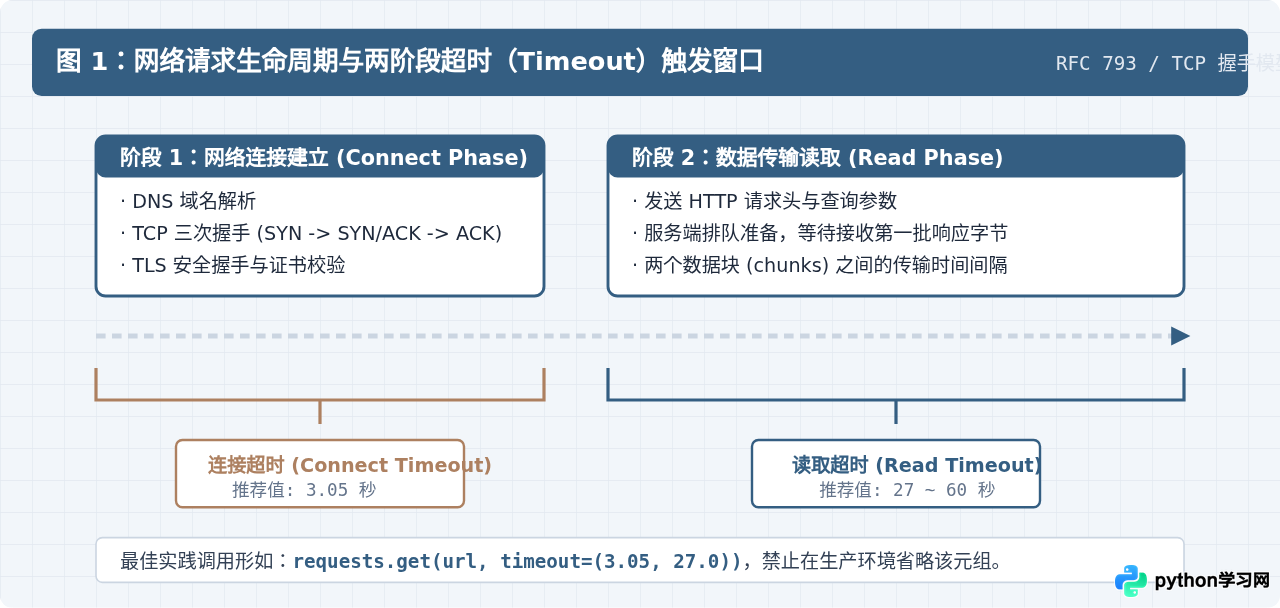
在网络 I/O 过程中,一个完整的 HTTP 下载生命周期在网络层主要划分为两个截然不同的阶段:
- 连接超时(Connect Timeout):指客户端与目标服务器建立 TCP 套接字连接(以及随后的 TLS 握手)的最大允许等待时间。如果目标服务器宕机、防火墙默默丢包或路由不可达,客户端将在达到该时限后抛出
requests.exceptions.ConnectTimeout。通常该阶段耗时极短,推荐设置为略大于 3 秒的数值(例如 3.05 秒),以容忍底层 TCP SYN 数据包的重传周期。 - 读取超时(Read Timeout):指客户端成功建立连接后,等待服务器发送响应报文,或者在数据流中等待两个相邻数据块(chunk)到达的最大时间间隔。若服务器处理缓慢或数据流意外中断,客户端将抛出
requests.exceptions.ReadTimeout。对于大文件下载,读取超时应根据单块数据传输期望设定,而非整个文件的下载总耗时。
二、基于 requests.Session 与 HTTPAdapter 实现透明自动重试
对于大部分常规下载任务,编写混乱的 try...except 嵌套循环既冗长又容易引发资源泄漏。requests 库底层依赖 urllib3 维护连接池,我们可以通过将配置好的 HTTPAdapter 挂载到 requests.Session 上,让所有通过该会话发起的网络请求在协议适配器层自动触发重试。
在配置自动重试时,必须合理设置 urllib3.util.Retry 对象的参数:
total:允许尝试的最大重试总次数。backoff_factor:退避因子。重试休眠时间计算公式为{backoff factor} * (2 ** ({retry number} - 1))。例如设为 0.5 时,后续重试将分别休眠 0.5s、1.0s、2.0s,避免在服务端抖动时立即发起猛烈冲击。status_forcelist:强制触发重试的 HTTP 状态码集合。通常包含[429, 500, 502, 503, 504]。对于 404(资源不存在)或 403(无权访问)等确定性客户端错误,不应重试。allowed_methods:只对幂等方法执行自动重试,如["HEAD", "GET", "OPTIONS"],避免对 POST 等非幂等操作重复提交。raise_on_status:设为False可以在达到最大重试次数后返回最后的 Response 供调用方检查,若设为True则直接抛出MaxRetryError。
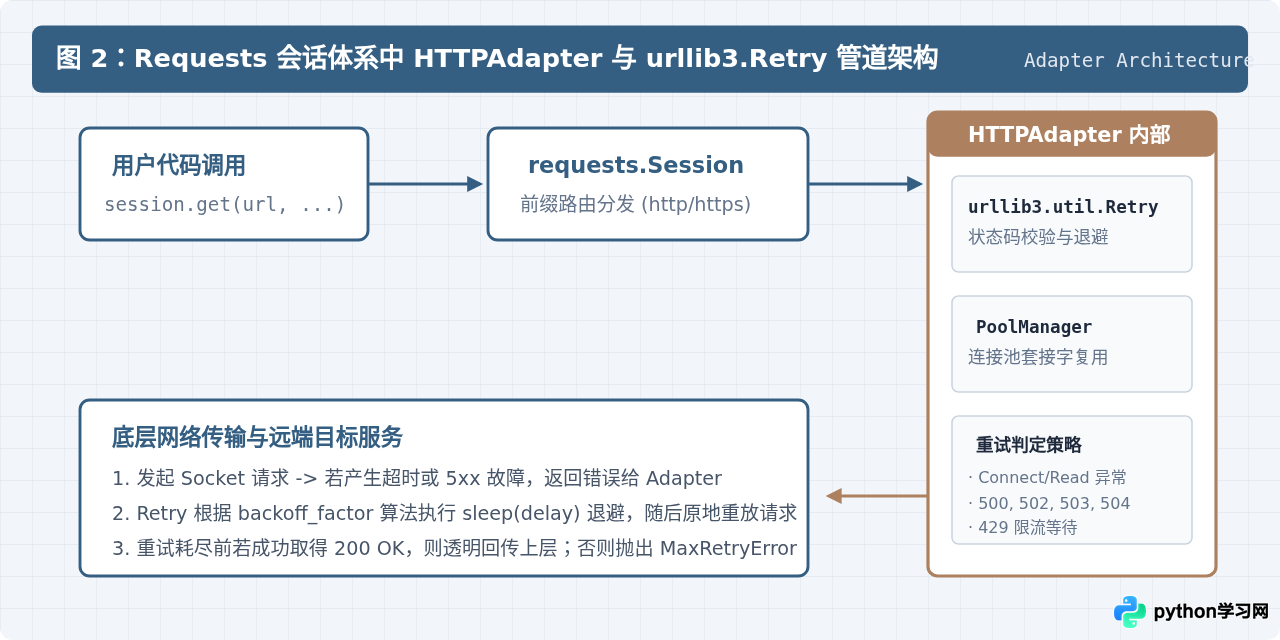
下面是封装好的会话构建函数,可作为整个工程的通用网络下载客户端底座:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

def get_robust_session(
    retries: int = 3,
    backoff_factor: float = 0.5,
    status_forcelist: tuple = (429, 500, 502, 503, 504)
) -> requests.Session:
    """
    创建一个具备自动指数退避重试特性的 requests.Session 会话对象。
    """
    session = requests.Session()

    retry_strategy = Retry(
        total=retries,
        read=retries,
        connect=retries,
        backoff_factor=backoff_factor,
        status_forcelist=status_forcelist,
        allowed_methods=frozenset(["HEAD", "GET", "OPTIONS"]),
        raise_on_status=False
    )

    adapter = HTTPAdapter(max_retries=retry_strategy, pool_connections=10, pool_maxsize=10)
    session.mount("https://", adapter)
    session.mount("http://", adapter)

    return session

# 使用示例
session = get_robust_session(retries=3, backoff_factor=1.0)
try:
    # 明确设置 (连接超时, 读取超时)
    response = session.get("https://example.com/largefile.zip", timeout=(3.05, 30.0))
    response.raise_for_status()
    print("下载成功,响应长度:", len(response.content))
except requests.exceptions.RequestException as e:
    print("重试耗尽后仍无法完成下载:", e)
三、下载异常类型与显式循环退避机制
尽管通过 HTTPAdapter 能够解决绝大多数简单 GET 请求的重试,但在涉及大文件流式下载、断点续传、或者需要记录精确的重试监控指标时,编写带有显式退避的循环更为直观可控。我们需要精准捕获关键异常,避免把代码逻辑错误误当作网络超时去重试。
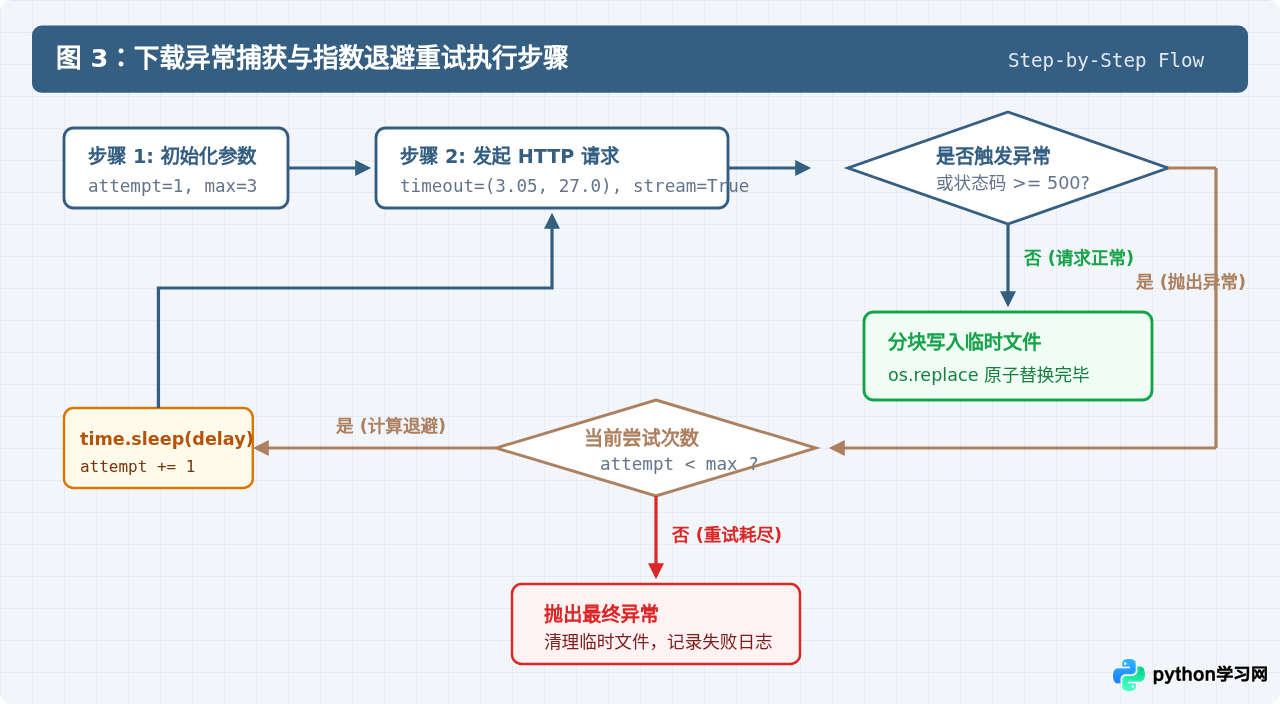
关键网络异常的继承关系如下表所示。在编写 except 时,应当针对具体的网络抖动异常进行捕获,坚决避免捕获宽泛的 Exception,否则会掩盖代码本身的拼写错误、路径权限问题或逻辑缺陷:
| 异常类名称 | 触发场景说明 | 是否建议自动重试 |
|---|---|---|
requests.exceptions.ConnectTimeout |
TCP 握手时限内未收到响应包、目标 IP 无法路由或防火墙丢包。 | 是(重试 2~3 次,可能为偶发路由抖动) |
requests.exceptions.ReadTimeout |
连接已建立,但在约定时限内服务器未吐出首字节或分块卡住。 | 是(重试 2~3 次,配合适当退避) |
requests.exceptions.ConnectionError |
底层网络重置(Connection Reset by Peer)、DNS 解析失败等。 | 是(视具体子类而定,通常可重试) |
requests.exceptions.HTTPError |
HTTP 状态码异常。需区分 4xx 与 5xx。 | 仅针对 429, 502, 503, 504 重试,4xx 不重试 |
requests.exceptions.URLRequired / MissingSchema |
URL 缺少协议头或格式非法。 | 否(属于代码级错误,重试无意义) |
四、大文件流式下载(stream=True)中的超时与断点续传
下载几百兆乃至数吉字节的大文件时,绝不能将整个文件直接读入内存(即不能直接调用 response.content),必须开启 stream=True 进行分块读取。然而,使用流式下载时存在一个极易被忽视的陷阱:requests.get() 中的 timeout 仅管到 HTTP 响应头的返回!
一旦开始通过 response.iter_content() 遍历数据块,如果传输过程中网络突然静默中断,某些平台下的迭代器可能会永久死锁。为了避免这种现象,应遵循以下工程原则:
- 使用临时文件写入:下载过程中将数据写入
.tmp后缀的临时文件,下载全部校验无误后再通过os.replace()原子性地重命名为目标文件。这可以防止重试过程中生成损坏的半成品文件。 - 结合 HTTP Range 头部实现断点续传:如果服务器支持
Accept-Ranges: bytes,在发生超时重试时,无需从头下载已传输的数百兆数据,只需通过Range: bytes={already_downloaded}-接着往后拉取即可。
下面是一个生产级别的完整文件下载函数,整合了流式分块、超时防护、临时文件写入与断点重试逻辑:
import os
import time
import requests
from requests.exceptions import RequestException, Timeout, ConnectionError

def download_file_resilient(
    url: str,
    target_path: str,
    max_retries: int = 3,
    connect_timeout: float = 3.05,
    read_timeout: float = 27.0,
    chunk_size: int = 65536
) -> bool:
    """
    稳健的文件下载实现:支持流式写入、超时中断、断点续传与原子重命名。
    """
    temp_path = f"{target_path}.tmp"

    for attempt in range(1, max_retries + 1):
        # 检查是否已有部分下载的数据,若有则尝试断点续传
        downloaded_bytes = os.path.getsize(temp_path) if os.path.exists(temp_path) else 0
        headers = {}
        if downloaded_bytes > 0:
            headers["Range"] = f"bytes={downloaded_bytes}-"

        try:
            with requests.get(
                url,
                headers=headers,
                timeout=(connect_timeout, read_timeout),
                stream=True
            ) as response:

                # 针对 416 (Requested Range Not Satisfiable) 做兼容:说明文件已全或服务端不支持
                if response.status_code == 416:
                    # 重新从头下载
                    downloaded_bytes = 0
                    headers.pop("Range", None)
                    response = requests.get(url, timeout=(connect_timeout, read_timeout), stream=True)

                # 429 或 5xx 状态码触发重试
                if response.status_code in (429, 500, 502, 503, 504):
                    raise RequestException(f"服务端瞬时状态码异常: {response.status_code}")

                # 检验请求是否成功 (200 完整内容, 206 部分内容)
                if response.status_code not in (200, 206):
                    raise RequestException(f"非预期响应状态码: {response.status_code}")

                # 若服务端不支持 Range 返回 200,则需从头覆盖写入
                mode = "ab" if response.status_code == 206 else "wb"
                if mode == "wb":
                    downloaded_bytes = 0

                with open(temp_path, mode) as f:
                    for chunk in response.iter_content(chunk_size=chunk_size):
                        if chunk:
                            f.write(chunk)

                # 传输完成,执行原子替换
                os.replace(temp_path, target_path)
                return True

        except (Timeout, ConnectionError, RequestException) as err:
            if attempt == max_retries:
                # 达到最大次数仍失败,清理半成品
                if os.path.exists(temp_path):
                    try:
                        os.remove(temp_path)
                    except OSError:
                        pass
                raise RuntimeError(f"文件下载失败,已达最大重试次数 ({max_retries}),最后错误: {err}") from err

            # 指数退避算法计算休眠时间
            sleep_seconds = min(10.0, 0.5 * (2 ** (attempt - 1)))
            time.sleep(sleep_seconds)

    return False
五、工程全景总结与避坑清单
处理网络超时与自动重试不仅是添加几行参数,更关乎对底层网络协议特点的准确理解。为了在日常开发中形成规范,下图将各关键防护机制与排查检查点汇总为结构化参考图谱:
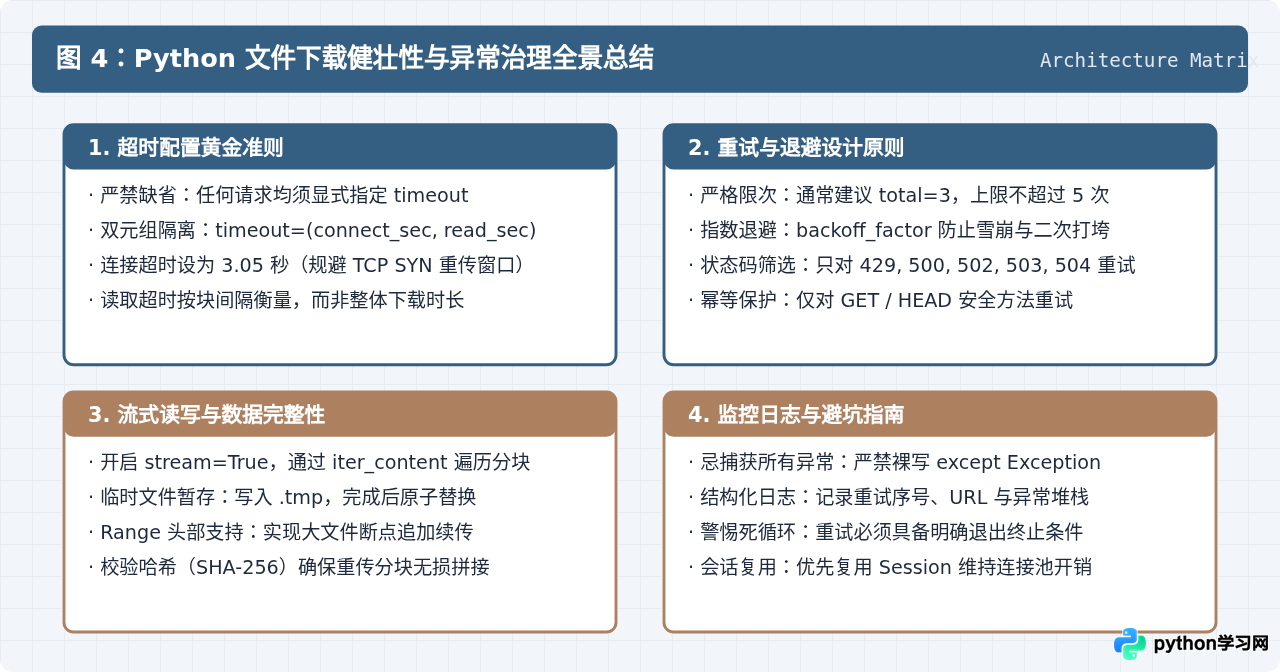
timeout=(connect, read) 元组,并搭配指数退避与临时文件原子重命名机制,从根本上杜绝进程死锁、雪崩式重试以及文件损坏等生产隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









