

Python requests 库实现接口文件上传基础教程

在 Python Web 自动化、爬虫以及后端服务调用中,向 HTTP 接口上传文件是一项非常高频的需求。使用 requests 库上传文件,本质上是通过 HTTP POST 请求向服务器发送符合 multipart/form-data 规范的请求体。本文将从底层报文原理讲起,逐步介绍基础单文件上传、自定义元组参数、混合字段提交、多文件上传、流式传输以及开发者最常遇到的排错要点,帮助读者掌握文件上传的完整操作与核心细节。
一、文件上传底层机制与 multipart/form-data 原理
常规的 HTTP POST 请求通常使用 application/x-www-form-urlencoded 或 application/json 格式传输键值对或结构化数据。但这两种格式并不适合直接传递庞大的二进制流(如图片、压缩包、音频或文档)。
为了在同一个 HTTP 请求中既能传输普通文本参数,又能传输一个或多个二进制文件,HTTP 协议定义了 multipart/form-data 媒体类型。其核心工作机制包含三个部分:
- Boundary 分隔符:客户端在请求头的
Content-Type中声明一个唯一的随机字符串作为边界标记(Boundary)。请求体中的每一个字段和文件块均由该标记包裹。 - 字段头信息(Part Headers):每个数据块头部包含
Content-Disposition,指明该字段在表单中的名称(name)、原始文件名(filename),以及该文件具体的 MIME 类型(如image/png、application/pdf)。 - 数据本体(Payload):在空行之后直接附加原始二进制数据或文本,各块之间互不干扰,最终由末尾的闭合标记结束整个请求。
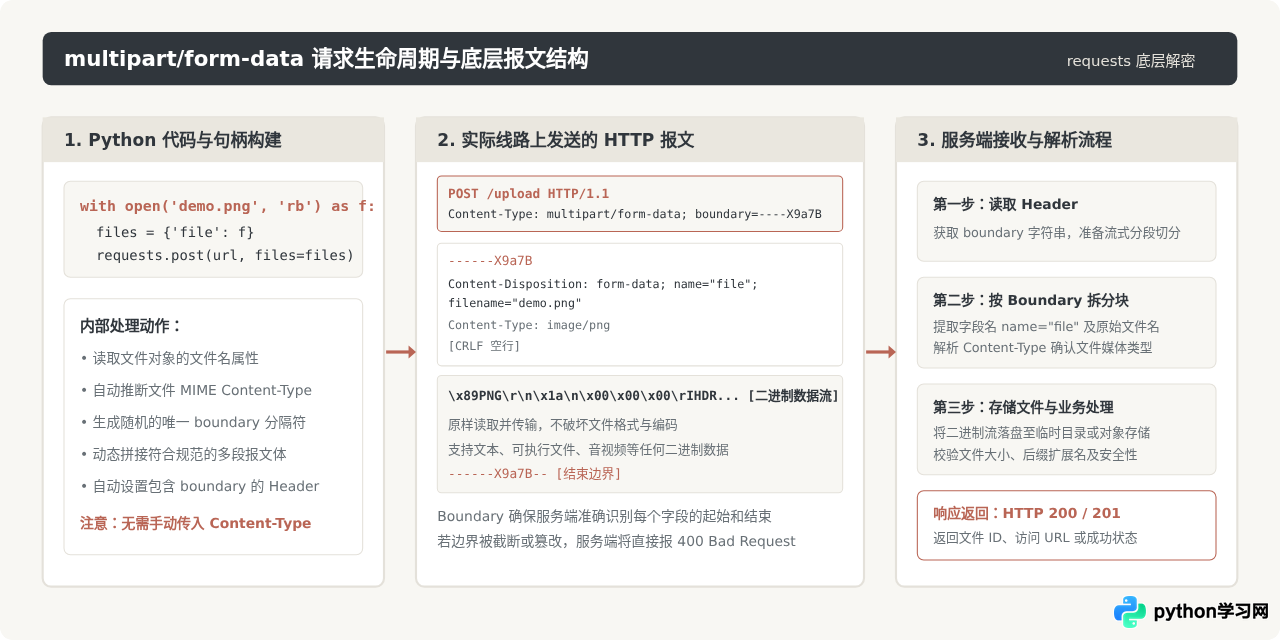
二、基础单文件上传与 files 参数标准用法
在 requests 库中,上传文件的核心切入点是 requests.post() 方法的 files 关键字参数。该参数接收一个字典,字典的键(Key)对应服务端接口定义的表单字段名(如 "file"、"upload" 或 "attachment"),字典的值(Value)则是打开的文件对象或文件描述元组。
1. 规范的文件打开方式:二进制模式 ('rb')
上传任何本地文件时,必须使用二进制只读模式 'rb' 打开。如果错误地使用了文本模式 'r',Python 会尝试根据系统默认编码(如 UTF-8 或 GBK)解析文件内容,不仅会导致非文本文件(如 PNG、ZIP、PDF)直接报错崩溃,还会在换行符转换时损坏文件内容。
同时,为了保证文件在上传完成或发生异常后都能正常释放句柄,建议始终使用 with 上下文管理器:
import requests

url = "https://httpbin.org/post"
file_path = "sample.png"

# 使用 'rb' 二进制模式读取
with open(file_path, "rb") as file_obj:
    # 构造 files 字典,键名须与服务端要求的表单字段名一致
    files = {"file": file_obj}

    # 发起 POST 请求
    response = requests.post(url, files=files)

# 打印响应状态及服务端解析到的表单信息
print("状态码:", response.status_code)
print("服务端解析结果:", response.json().get("files"))
关键规则:不要手动在 headers 中指定 Content-Type
当传入 files 参数时,requests 库会自动识别并在底层生成类似 Content-Type: multipart/form-data; boundary=358b9... 的 Header。如果用户在 headers 字典中手动传入了 {"Content-Type": "multipart/form-data"},就会覆盖自动生成的 Header,导致缺失 boundary 定义,服务端收到后将无法切分字段,直接返回 400 错误。
三、接口文件上传的标准四步操作流程
为了让上传逻辑在生产环境下稳定运行,标准的上传流程不应仅仅停留在调用 requests.post,而需要涵盖准备校验、参数构造、网络请求以及结果确认四个完整环节。
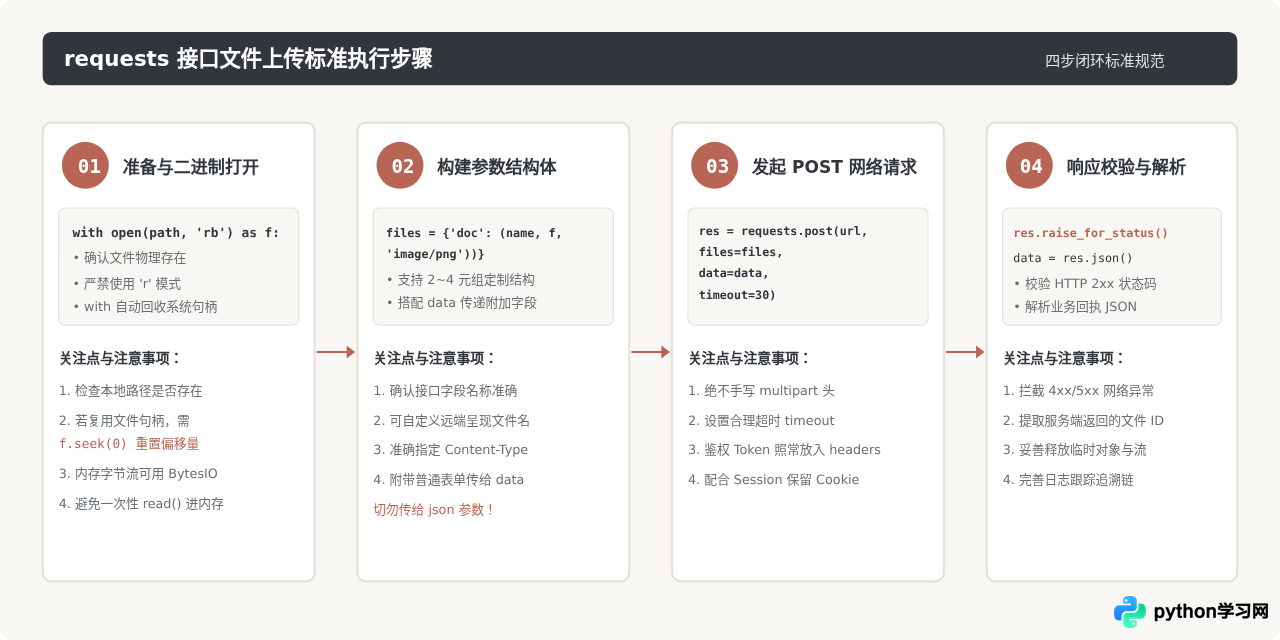
四、进阶参数定制:文件名、MIME 类型与混合表单字段
在实际业务场景中,后端接口往往对上传文件有更加严格的约束,例如要求特定格式的扩展名、校验指定的 Content-Type,或者要求在上传文件的同时附带用户 ID、任务类型等普通文本表单参数。requests 提供了非常灵活的语法支持。
1. 使用元组定制文件名和 Content-Type
如果直接传入打开的文件对象 files={'file': file_obj},requests 会自动从 file_obj.name 获取文件名并猜测 MIME 类型。但在以下情况中,这种方式无法满足需求:
- 本地临时文件名是一串无序哈希(如
tmp_88923a.dat),而服务端接口要求必须以.xlsx或.png结尾。 - 文件对象来自内存流(如
io.BytesIO),该对象本身不具备name属性,会导致requests无法生成filename。 - 服务端后端严格校验
Content-Type请求头,自动推断的默认值不符合服务端白名单。
此时,可以将字典的值定义为一个元组。requests 支持 2 元组、3 元组乃至 4 元组的结构:
(filename, file_object):显式指定上传文件名与文件流。(filename, file_object, content_type):显式指定文件名、文件流与 MIME 类型。(filename, file_object, content_type, custom_headers):进一步为该单文件段附加特定的额外 Header。
import io
import requests

url = "https://httpbin.org/post"

# 场景 A:重命名本地文件并显式指定 MIME
with open("local_temp.dat", "rb") as f:
    files = {
        "file": ("quarterly_report.xlsx", f, "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet")
    }
    response = requests.post(url, files=files)

# 场景 B:上传内存中动态生成的字节流(无须落地到磁盘)
memory_stream = io.BytesIO(b"Hello, this is in-memory csv content\n1,2,3")
files_memory = {
    "file": ("export_data.csv", memory_stream, "text/csv")
}
response_memory = requests.post(url, files=files_memory)
2. 混合提交:文件与普通表单字段并存
很多接口需要在上传文件的同时附带额外的业务参数(例如上传头像同时提交 user_id 和 album_name)。这种情况下,应同时使用 files 和 data 参数:
import requests

url = "https://httpbin.org/post"

# 普通表单数据放入 data 字典
payload_data = {
    "user_id": "10086",
    "description": "User profile avatar update",
    "category": "avatar"
}

with open("avatar.jpg", "rb") as f:
    files = {
        "avatar": ("avatar.jpg", f, "image/jpeg")
    }
    # requests 会自动将 data 中的字段与 files 合并到同一个 multipart/form-data 报文中
    response = requests.post(url, data=payload_data, files=files)

print("Status:", response.status_code)
避坑提示:切勿将混合字段传入 json= 参数
如果在 requests.post() 中同时传入了 files 和 json,或者误把参数字典通过 json= 发送,requests 将默认以 application/json 格式编码,从而丢失文件流或产生非预期的冲突。混合参数一律使用 data=。
3. 多文件同时上传的两种结构
业务中可能遇到需要一次性上传多张图片或附件的接口。这通常分为两种服务端协议定义:
第一种:同一字段名接收多个文件(例如表单中多个 <input type="file" name="images" multiple>)。此时不能使用字典(字典中同一个键会被覆盖),而必须使用二元元组构成的列表:
import requests

url = "https://httpbin.org/post"

with open("img1.png", "rb") as f1, open("img2.png", "rb") as f2:
    # 使用列表存储元组,键名均为 'images'
    multiple_files = [
        ("images", ("img1.png", f1, "image/png")),
        ("images", ("img2.png", f2, "image/png"))
    ]
    response = requests.post(url, files=multiple_files)
第二种:不同字段名分别接收不同文件。直接在字典中设置多个键即可:
with open("id_card_front.jpg", "rb") as f_front, open("id_card_back.jpg", "rb") as f_back:
    files = {
        "id_front": ("front.jpg", f_front, "image/jpeg"),
        "id_back": ("back.jpg", f_back, "image/jpeg")
    }
    response = requests.post(url, files=files)
五、常见写法与高频踩坑场景深度对照
在实际开发和接口测试过程中,文件上传失败绝大多数集中在编码模式、请求头覆盖、重试句柄偏移等几个特定问题上。以下将推荐模式与高频错误进行系统性对照。
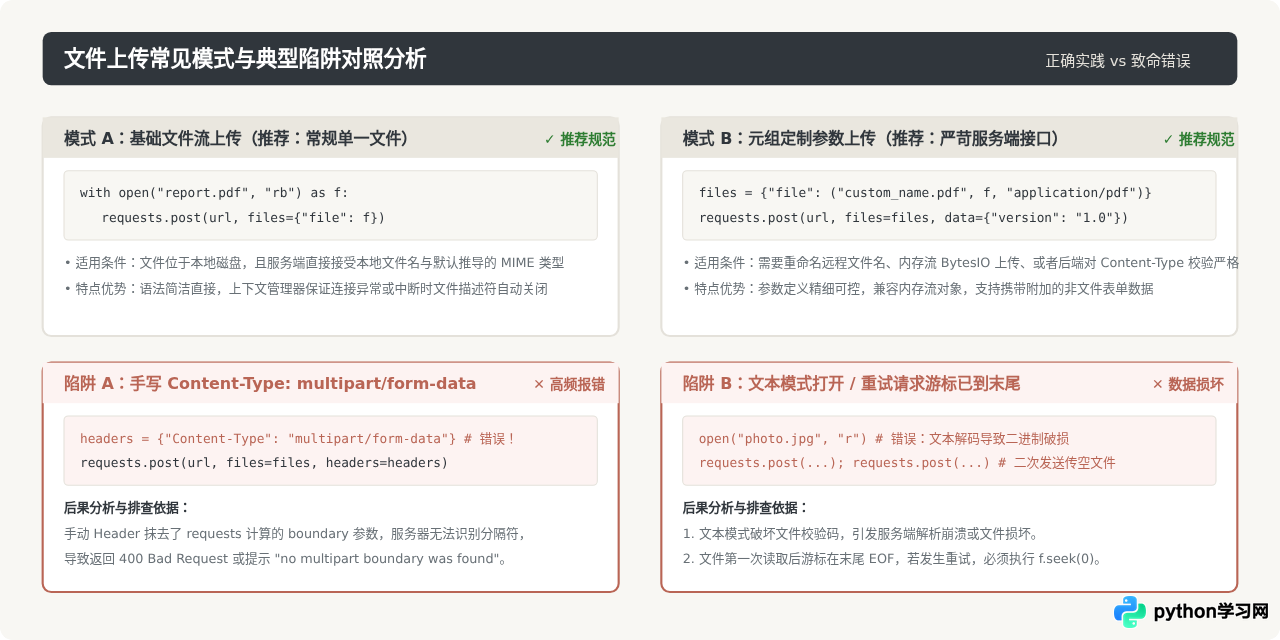
1. 针对请求重试中的“空文件”陷阱
许多开发者在接入自动化重试机制时会发现:第一次请求失败后,重试时服务器直接返回“文件内容为空”。这是因为文件对象本质是一个带指针的流。在第一次发起 requests.post 时,底层已将整个文件流读至末尾(EOF)。如果在发起重试前没有重新将指针归零,第二次请求发送的数据块大小就是 0 字节。
解决方案:在重试请求前,必须显式调用 f.seek(0):
with open("package.zip", "rb") as f:
    files = {"file": f}

    # 第一次尝试
    try:
        res = requests.post(url, files=files, timeout=5)
        res.raise_for_status()
    except requests.RequestException:
        # 重试前必须重置游标至文件起始位置
        f.seek(0)
        res = requests.post(url, files=files, timeout=10)
六、大文件流式上传与内存控制
对于几十兆以内的小文件,常规方式由 requests 自动读取并缓冲是完全没有问题的。但当需要上传数以百兆乃至数吉字节的大文件时,如果依然通过简单的方式将文件一次性加载到内存中,会导致 Python 进程内存占用急剧飙升,甚至直接引发系统的 OOM(Out Of Memory)崩溃。
对于大文件,可以通过直接将文件句柄直接作为 data 参数传递,配合流式生成器实现分块流式传输;或者借助扩展工具 requests-toolbelt 提供的 MultipartEncoder。
使用 MultipartEncoder 实现流式上传与监控
社区官方推荐的流式上传库是 requests-toolbelt。它能将多个文件与字段组合成一个流式迭代器,只在真正发送 socket 数据时才逐块从硬盘读取数据,从而将内存占用稳定在极低的常数级别(几百 KB 以内):
# 需要安装辅助组件: pip install requests-toolbelt
from requests_toolbelt.multipart.encoder import MultipartEncoder
import requests

url = "https://httpbin.org/post"

# 构建流式编码器
encoder = MultipartEncoder(
    fields={
        "desc": "large system backup archive",
        "file": ("backup.tar.gz", open("large_backup.tar.gz", "rb"), "application/gzip")
    }
)

# 注意:MultipartEncoder 会自动生成带合法 boundary 的 content_type
headers = {"Content-Type": encoder.content_type}

# 以流式方式直接发送 data
response = requests.post(url, data=encoder, headers=headers)
print("上传完成,返回码:", response.status_code)
七、核心要点与最佳实践全景总结
掌握 requests 接口文件上传,核心在于理解 HTTP 协议层对多段内容(Multipart)的分隔契约,以及 Python 文件句柄在流处理中的状态变迁。以下全景图梳理了生产环境下的四维最佳实践准则:
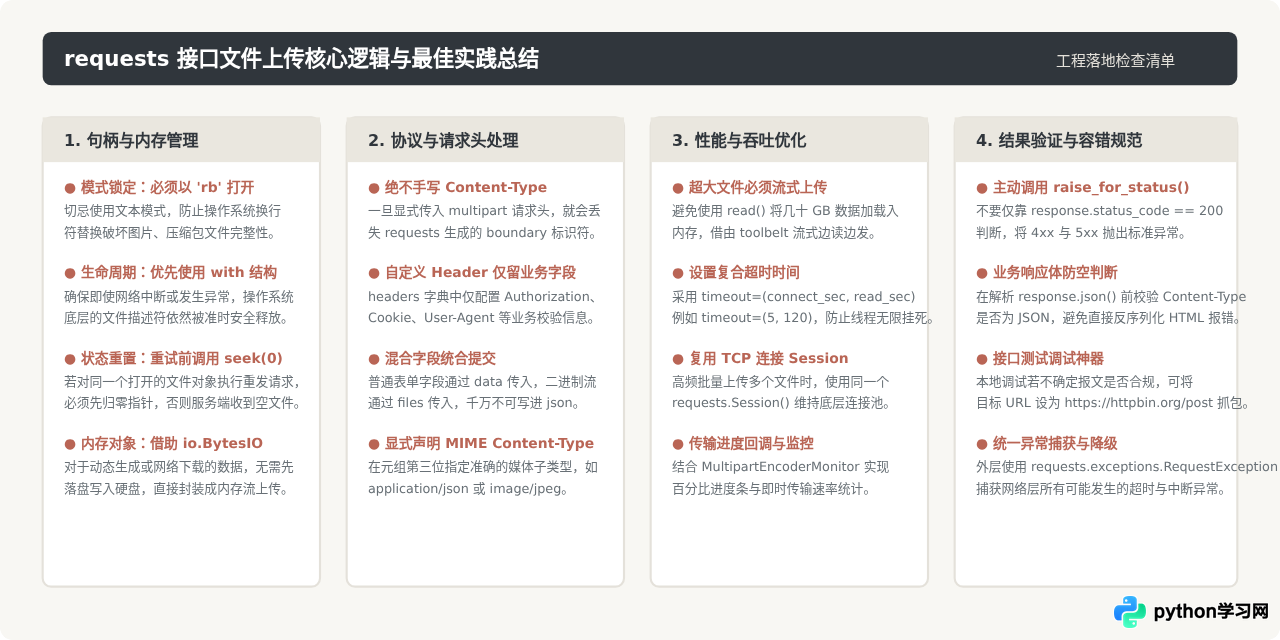
通过掌握 multipart/form-data 的内部边界机制、坚持使用 'rb' 二进制模式管理句柄、合理运用元组结构定制参数,并让 requests 自主维护协议头信息,开发者即可从容应对绝大部分接口文件上传场景,编写出健壮、高效且易于维护的网络交互代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









