

Python接入百度翻译API的步骤与签名生成详解

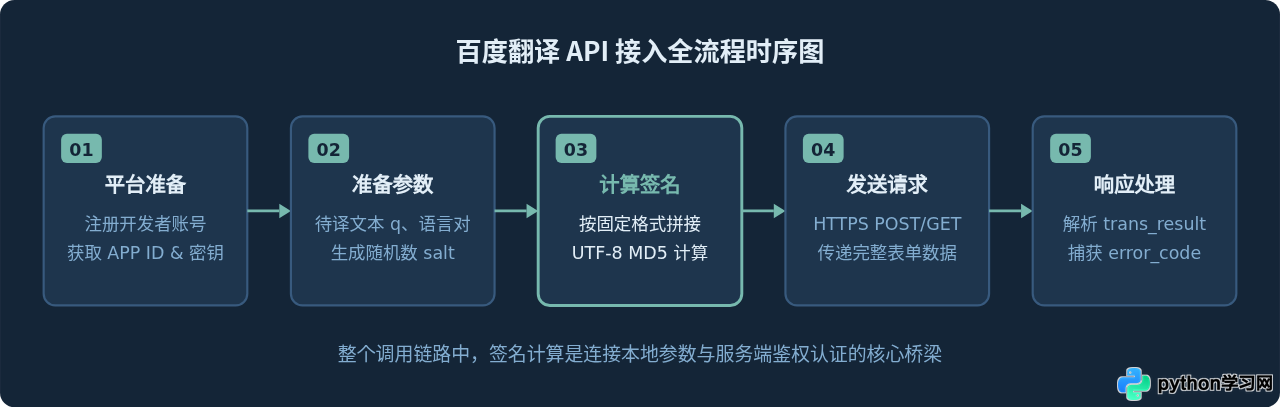
在编写自动化脚本、爬虫数据清洗或多语言内容管理工具时,文本自动翻译是十分普遍的需求。百度翻译开放平台提供的通用翻译 API 具有响应速度快、支持语种多和免费调用额度适用的特点,成为许多 Python 开发者的首选。然而在初次接入时,多数开发者遇到的第一个障碍就是接口返回错误代码 54001(签名错误)。本文从开发者凭证获取切入,按实际开发时序梳理接入流程,详细拆解 MD5 签名的拼接与生成逻辑,并给出可直接复用的 Python 代码与常见排障方案。
一、准备工作:开通服务与获取接入凭据
接入通用翻译 API 之前,必须在百度翻译开放平台创建开发者账号并申请服务,获取程序调用所必需的两个核心凭据:APP ID 与 密钥(security_key)。
具体开通步骤如下:
- 访问百度翻译开放平台官方网站,使用百度账号登录并完成开发者注册(个人认证或企业认证)。
- 进入“管理控制台”,在服务列表中申请开通“通用翻译API”。通常个人标准版即可满足常规调用需求,拥有每秒 1 次请求(QPS=1)的免费频控配额;通过身份认证后可升级为高级版(QPS=10)。
- 在控制台的“开发者信息”页面中,查看并妥善记录你的
APP ID和密钥。这两个字段是后续所有接口通信的身份标识与签名加密基准。
二、API 接口规范与参数要求
百度通用翻译 API 提供了标准 HTTPS 请求接口,支持 GET 和 POST 两种请求方法。由于待翻译文本可能较长或包含特殊标点符号,官方推荐在生产中使用 POST 方法,避免 URL 长度超限截断。
- 接口请求地址:
https://fanyi-api.baidu.com/api/trans/vip/translate - 请求内容格式:
application/x-www-form-urlencoded - 字符编码规范:统一使用
UTF-8
发送请求时必须包含下表列出的所有核心字段:
| 参数名称 | 类型 | 是否必填 | 说明与示例 |
|---|---|---|---|
q |
String | 是 | 请求翻译的源文本,UTF-8 编码。单次请求上限通常为 6000 字节。 |
from |
String | 是 | 源语言代码,例如中文 zh、英语 en,或自动识别 auto。 |
to |
String | 是 | 目标语言代码,例如翻译为英文填 en、翻译为中文填 zh。 |
appid |
String | 是 | 开放平台分配的应用 ID。 |
salt |
String / Int | 是 | 随机数,用于保证签名的唯一性,防止重放攻击。 |
sign |
String | 是 | 签名,由 appid + q + salt + security_key 拼接后计算的 32 位 MD5。 |
三、签名(sign)生成原理与细节剖析
签名验证是百度翻译 API 保证接口调用安全、核验调用方身份的核心机制。一旦签名计算与服务端不一致,请求就会立即被拦截并返回错误。
1. 签名拼接公式
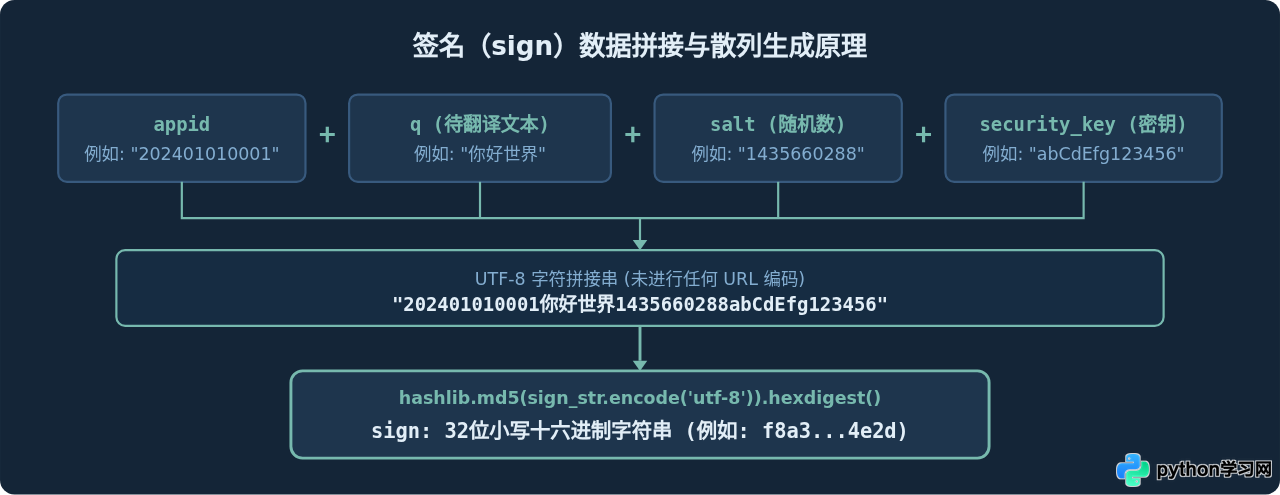
签名的生成过程具有固定的先后次序,公式如下:
sign = MD5(appid + q + salt + security_key)这四个字段必须按照上述顺序严格拼接为一段无间隔的字符串,然后对其进行 UTF-8 编码,再使用标准的 MD5 算法计算出 32 位小写的十六进制哈希值。
2. 签名计算三大高频踩坑点
- 不要在计算 MD5 之前对
q做 URL 编码:这是初学者最容易犯的错误。在拼接字符串时,必须传入原始的未编码文本(包括空格、标点和换行符)。网络传输时的 URL 编码应交给 HTTP 客户端库(如 Python 的requests)在发送前自动完成。 - 注意多行文本与换行符:如果待翻译内容
q包含换行,计算签名时必须保留真实的\n。如果在读取文件或字符串传递时对换行符进行了转义替换(例如变成了字面量\\n),两端计算出的散列值将完全不同。 - 输出结果必须为小写字母:百度翻译 API 严格校验小写十六进制 MD5。Python 内置的
hexdigest()默认返回小写字符串,通常无需额外调用.lower(),但在某些自定义哈希封装中若生成大写字母则会导致校验失败。
四、请求与响应的数据结构模型
客户端在组装好参数并计算得到 sign 之后,发起标准的 HTTP POST 请求。服务端的返回结果均为 JSON 格式,主要分为“调用成功”与“调用失败”两种结构分支。
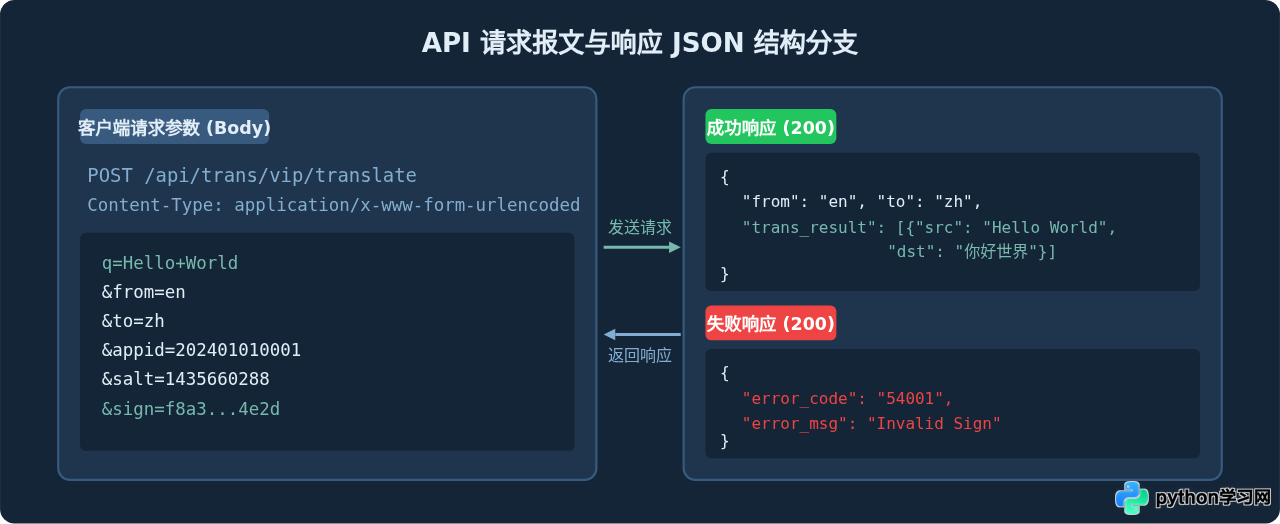
特别需要注意:即使发生错误(如签名失效或账户欠费),百度翻译接口返回的 HTTP 状态码通常依然是 200 OK。因此不能仅根据 HTTP 状态码判断是否成功,而必须在解析 JSON 数据时先检查是否存在 error_code 字段。
五、完整的 Python 接入代码实现
下面给出使用 Python 标准库 hashlib 与常用第三方库 requests 实现的完整接入示例。代码封装为函数 baidu_translate,包含签名生成、POST 请求发起、网络异常重试以及结果解析等核心环节。
import random
import hashlib
import requests
from typing import Optional, Dict, Any


def generate_sign(appid: str, query_text: str, salt: str, secret_key: str) -> str:
    """
    生成百度翻译API所需的MD5签名
    拼接规则: appid + q + salt + secret_key
    """
    raw_str = f"{appid}{query_text}{salt}{secret_key}"
    return hashlib.md5(raw_str.encode("utf-8")).hexdigest()


def baidu_translate(
    query_text: str,
    from_lang: str = "auto",
    to_lang: str = "zh",
    appid: str = "",
    secret_key: str = "",
    timeout: int = 10
) -> Optional[str]:
    """
    调用百度通用翻译API完成翻译
    :param query_text: 待翻译源文本
    :param from_lang: 源语言,默认自动识别 'auto'
    :param to_lang: 目标语言,默认中文 'zh'
    :param appid: 百度翻译开放平台 APP ID
    :param secret_key: 百度翻译开放平台 密钥
    :param timeout: 网络请求超时时间(秒)
    :return: 翻译结果文本(多行合并),若失败返回 None
    """
    if not query_text or not query_text.strip():
        return ""

    if not appid or not secret_key:
        raise ValueError("调用前必须配置有效的 appid 和 secret_key")

    api_url = "https://fanyi-api.baidu.com/api/trans/vip/translate"
    # 生成随机盐值
    salt = str(random.randint(32768, 65536))

    # 步骤1: 计算签名
    sign = generate_sign(appid, query_text, salt, secret_key)

    # 步骤2: 准备表单数据
    payload = {
        "q": query_text,
        "from": from_lang,
        "to": to_lang,
        "appid": appid,
        "salt": salt,
        "sign": sign,
    }

    headers = {
        "Content-Type": "application/x-www-form-urlencoded"
    }

    try:
        # 步骤3: 使用 POST 请求发送数据
        response = requests.post(api_url, data=payload, headers=headers, timeout=timeout)
        response.raise_for_status()
        result: Dict[str, Any] = response.json()

        # 步骤4: 校验返回结果
        if "error_code" in result:
            error_code = result.get("error_code")
            error_msg = result.get("error_msg", "未知错误")
            print(f"翻译请求失败: 错误码={error_code}, 原因={error_msg}")
            return None

        # 步骤5: 提取翻译结果列表
        trans_result = result.get("trans_result", [])
        dst_lines = [item.get("dst", "") for item in trans_result]
        return "\n".join(dst_lines)

    except requests.RequestException as e:
        print(f"网络通信发生异常: {e}")
        return None


if __name__ == "__main__":
    # 请替换为你真实的凭据(生产环境中建议通过环境变量读取)
    MY_APPID = "你的_APP_ID"
    MY_SECRET_KEY = "你的_SECRET_KEY"

    source_content = "Python is a widely used high-level programming language."
    translated_text = baidu_translate(
        query_text=source_content,
        from_lang="en",
        to_lang="zh",
        appid=MY_APPID,
        secret_key=MY_SECRET_KEY
    )

    print("--- 翻译结果 ---")
    print(translated_text)
六、高频错误码排查与最佳实践
在接口接入和后期持续运行过程中,若遇到返回失败,可以根据返回的 error_code 快速定位问题根源:
| 错误代码 | 官方说明 | 核心诱因与排查解决办法 |
|---|---|---|
54001 |
Invalid Sign (签名错误) | 拼接字段次序颠倒、提前对文本做了 urlencode、计算前使用了错误的密钥、或者待译文本与计算签名时的字符串不一致。 |
54003 |
Access Frequency Limited (访问频次受限) | 请求速率超过了账号开通的 QPS 上限(如免费个人版默认 QPS=1)。多线程或循环批量调用时未加入频率延时控制。 |
52003 |
Unauthorized User (未授权用户) | APP ID 输入有误,或者该开发者账号尚未在开放平台控制台勾选开通“通用翻译API”服务。 |
54004 |
账户余额不足 | 调用额度已超出当月免费字符配额,且账户未充值或透支限制。 |
52001 / 52002 |
请求超时 / 系统错误 | 百度服务器临时波动或本地网络超时。应在客户端引入捕获机制并增加有限重试(如指数退避)。 |
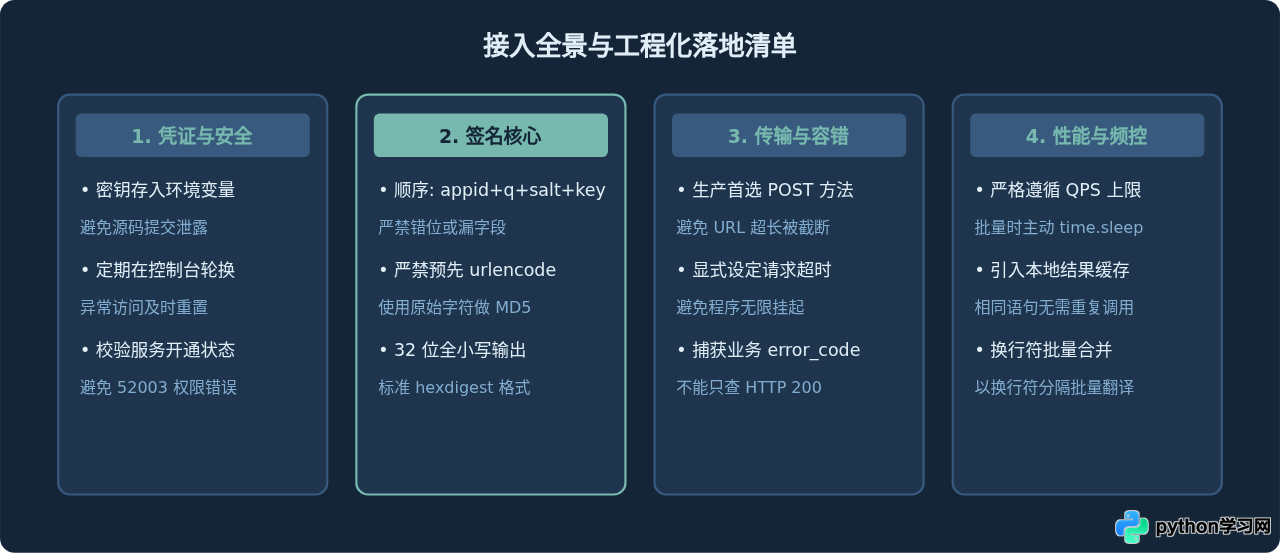
\n 将多个短句合并为单个 q 参数发送(保证总字符在限制内),百度翻译 API 会按换行符分别翻译并在 trans_result 列表中按顺序返回各行翻译结果。这样不仅可以大幅减少网络请求次数,还能有效避免触发 QPS 频控限制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









