

避免过度封装:在Python中平衡代码简洁性与复杂度

在Python开发中,封装的核心目标是隐藏非必要的技术细节、降低读者的心智负担,并在真实变化发生时提供稳定的边界。然而,许多工程师常常在需求尚未明确时,为了追求抽象而引入庞大的基类、工厂层与转发代理。这种过度封装非但没有降低维护成本,反而制造了冗长的调用链路、模糊了数据结构,使排查问题与理解代码变得极其困难。平衡简洁性与复杂度的关键,在于尊重Python“扁平优于嵌套、明确优于隐晦”的语言特质,坚持基于真实需求进行递进式演化,而非过早预设抽象架构。
过度封装在Python中的三大典型症状
过度封装并不总是以明显的代码冗余出现,它往往包裹在“规范架构”和“设计模式”的外衣下。当开发者脱离业务实际盲目套用其他强静态类型语言的编程模式时,通常会在代码库中留下以下三类具有高认知成本的特征。
1. 穿透式抽象(Pass-through Wrapper)
最常见也是危害最普遍的表现是仅仅用于转发参数的层级包装。一个方法接收十几个参数,原封不动地传递给下一层的内部类方法,内部类再原封不动地传给工具函数或数据库客户端。开发者必须穿透四五层跳转才能看清底层的核心逻辑。这种封装不仅没有隐藏复杂性,反而制造了无意义的跳转断点和调试干扰。
2. 为假想需求预设工厂与策略模式
业务当前只需要将数据导出为单一的JSON文件,但在代码实现中却提前构建了 BaseExporter 抽象基类、ExporterFactory 工厂类、ExporterRegistry 注册器以及一套插件配置解析机制。开发者耗费大量精力维护这套看似解耦的结构,但在项目生命周期中,往往从未真正接入第二种导出格式。这种为“可能存在”的未来扩展而编写的架构代码,构成了严重的工程浪费。
3. 滥用Getter/Setter与私有属性伪装
在Python中,直接访问对象属性或操作基础数据字典是自然且高效的。若将所有字段都写成 get_name()、set_name(),或者将简单的内部字典包装为多层复杂的只读容器类,不仅使代码行数翻倍,还会破坏原生列表推导式、解构赋值与序列化工具的使用便利性。
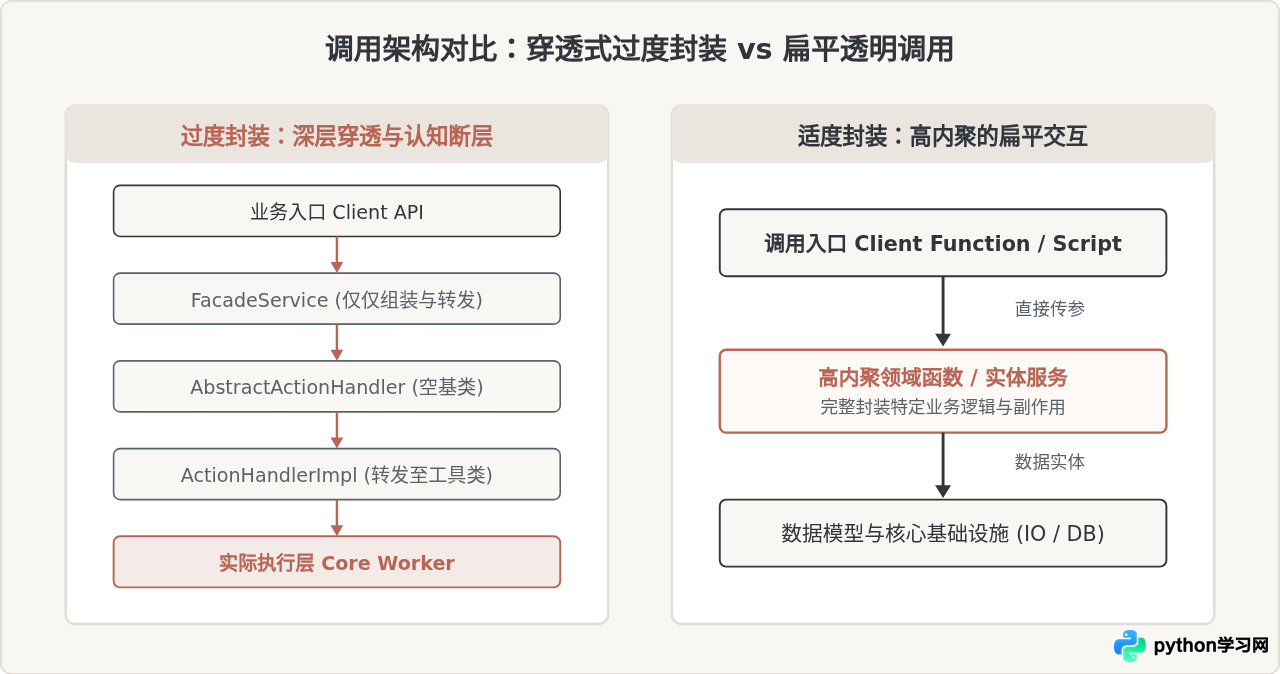
判定是否需要封装的四步决策法
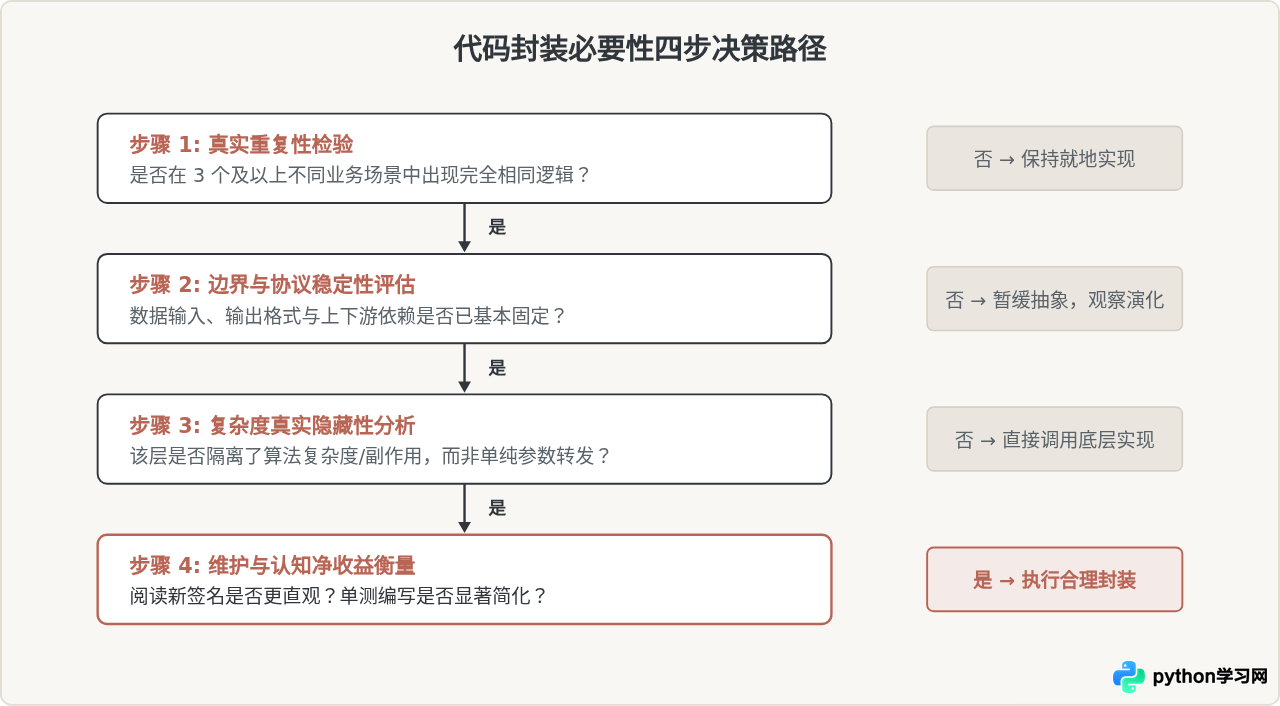
在着手编写一个新类、装饰器或提取辅助函数之前,应当通过一套具备严格准入条件的推导路径来验证其必要性。绝大多数不必要的复杂度,都可以在这四个步骤中被提前识别并过滤掉。
- 检验真实复用频次:仅当某段完全相同的计算、转换或校验逻辑在不同模块中出现了三次或以上时,才考虑统一抽离。若仅出现一至两次,局部的内联实现通常比引入全局依赖更易于理解和演进。
- 确认接口边界稳定性:如果业务边界仍在快速迭代,过早定义的抽象接口会迅速过时,甚至频繁倒逼调用方重构。此时应当推迟抽象,保留具体代码。
- 鉴别封装实质:检查新建的代码层究竟是在掩盖复杂的外部协议、状态机或复杂算法,还是仅仅充当了“改名换姓”的参数搬运工。如果是后者,坚决移除该层。
- 衡量认知增益:引入封装后,新使用者阅读函数签名是否比直接阅读底层原生调用更为清晰?单元测试是否更容易编写?若答案是否定的,证明抽象带来了反效果。
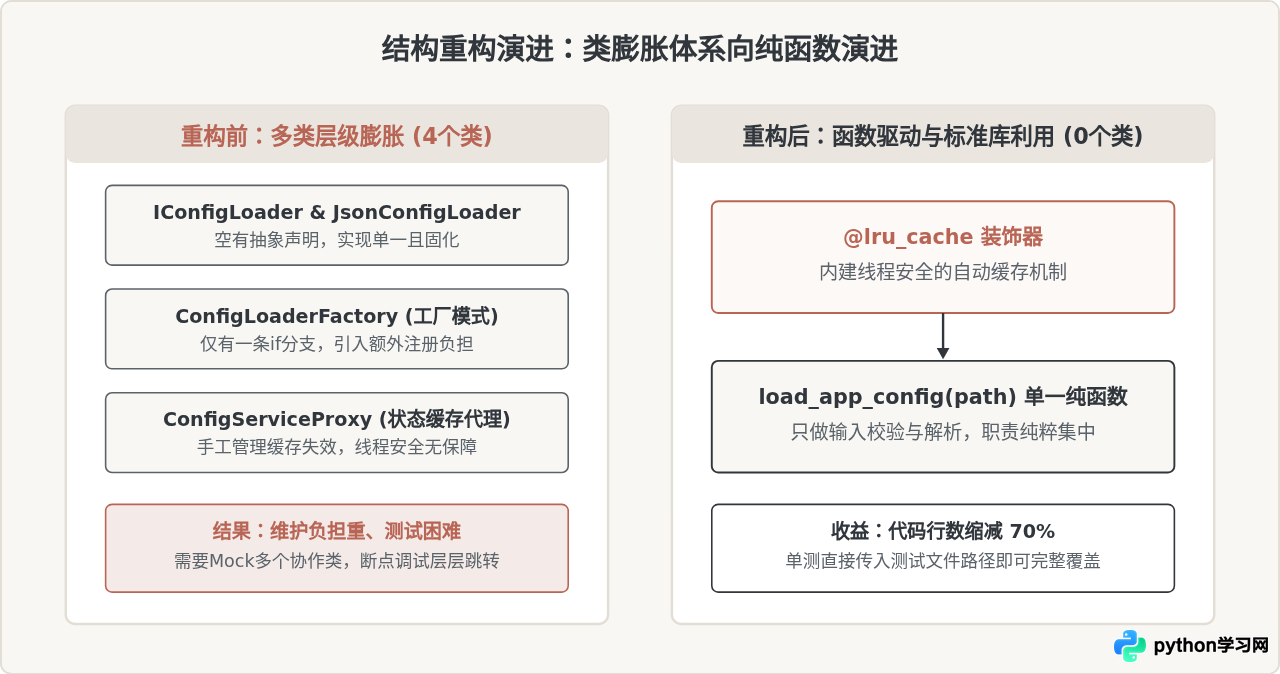
重构演进:从过度设计回归清晰直接
为了具体展示过度封装的代码形态及其重构过程,我们以常见的“配置文件加载与任务分发”为例。以下代码展示了过度封装带来的繁重结构:
# 过度封装的反面示例
from abc import ABC, abstractmethod

class IConfigLoader(ABC):
    @abstractmethod
    def load(self, path: str) -> dict:
        pass

class JsonConfigLoader(IConfigLoader):
    def load(self, path: str) -> dict:
        import json
        with open(path, "r", encoding="utf-8") as f:
            return json.load(f)

class ConfigLoaderFactory:
    @staticmethod
    def get_loader(loader_type: str) -> IConfigLoader:
        if loader_type == "json":
            return JsonConfigLoader()
        raise ValueError("Unsupported type")

class ConfigServiceProxy:
    def __init__(self, loader: IConfigLoader):
        self._loader = loader
        self._cached_config = None

    def fetch_config(self, path: str) -> dict:
        if self._cached_config is None:
            self._cached_config = self._loader.load(path)
        return self._cached_config
在这个例子中,仅仅为了读取一个JSON文件并做单次缓存,代码创建了接口、实现类、工厂类与代理类共4个类。任何新阅读该模块的开发者,都不得不花费数倍时间理解这套关系网络。而在真实的工程实践中,完全可以利用Python的标准模块和简单函数直接解决:
# 重构后的适度实现
import json
from pathlib import Path
from functools import lru_cache

@lru_cache(maxsize=1)
def load_app_config(config_path: str | Path) -> dict:
    """加载并缓存应用配置。参数为文件路径,返回解析后的字典。"""
    path = Path(config_path)
    if not path.is_file():
        raise FileNotFoundError(f"配置文件不存在: {config_path}")
    return json.loads(path.read_text(encoding="utf-8"))
重构后的版本代码量大幅缩减,没有任何无意义的工厂或抽象基类。利用标准库 lru_cache 天然实现了缓存,使用 Path 提升了路径操作的容错能力。调用方只需要 config = load_app_config("settings.json"),代码意图一目了然。
保持代码平衡的四大实用原则
在日常研发中,避免过度封装并不等于放弃一切设计。正确的做法是在保持接口轻量的同时,掌握合理的平衡技巧:
- 优先使用原生数据容器与纯函数:在需要承载结构化数据时,优先选用标准库的
dataclasses.dataclass或typing.NamedTuple,避免手写带有大量 getter/setter 的冗余类。纯函数由于没有内部隐式状态,极易组装与测试。 - 推迟使用抽象基类(ABC):Python是动态鸭子类型语言。如果只是为了规定方法名,依靠类型注解(
typing.Protocol)或自然的行为约定即可满足绝大多数静态类型检查需求,无需强行继承重量级基类。 - 依托
@property实现平滑演进:当类属性最初只是普通变量时,不必预设取值器方法。未来如果产生数据验证或计算需求,可以随时通过@property装饰器无缝升级,调用端代码完全不需要做出任何改动。 - 设立代码审查的红线指标:如果一个函数内部没有任何业务逻辑、只是将入参原样传递给另一个类,或者一个接口在整个代码仓库中仅有一个实现且预计半年内不会扩展,在 Code Review 中应明确要求作者予以平铺内联。
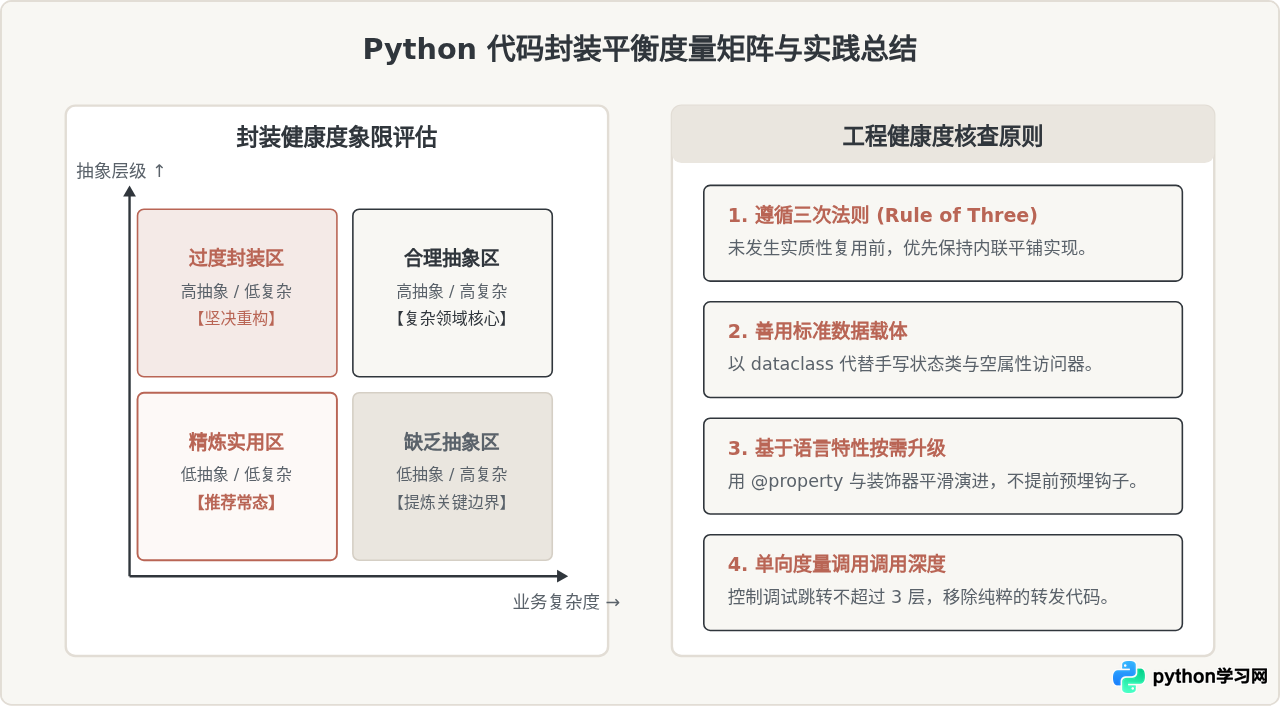
不同工程规模下的取舍边界
在不同阶段与项目类型中,对封装复杂度的容忍度是不同的:
- 自动化脚本与内部运维工具:生命周期短且需求具象。应坚持单文件或扁平模块化组织,完全消除抽象基类与转发中间层,确保排查故障时可以顺畅地从第一行阅读至末尾。
- 业务微服务与Web应用:业务规则处于演进中心。封装边界应严格停留在“领域业务边界”和“外部网络IO/数据库隔离”处。同一子模块内部应尽量保持扁平的数据结构和函数调用,杜绝在服务内部引入跨越多层的微型设计模式。
- 基础公共库与开源SDK:此时对外暴露的 API 面临长期的向前兼容压力。可以对外部接口进行审慎的抽象定义,但在内部实现中依然要避免不必要的代理套娃,确保错误调用栈短小明了。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









