

Python数据科学学习路线:从NumPy/Pandas到机器学习入门

掌握Python数据科学的核心在于建立一条清晰的工程闭环:先用NumPy完成底层向量化矩阵运算,再通过Pandas实现结构化数据清洗与特征探索,最终接入Scikit-Learn规范接口完成监督学习模型的训练、评估与调优。本文拆解这条路线上每一个关键阶段的核心概念、代码范式与常见陷阱,帮助读者避开盲目记忆语法的误区,直接建立工业级的数据分析与建模能力。
一、四阶段渐进式学习路径规划
数据科学的学习过程不应是孤立API的背诵,而是一个数据形态不断演进的过程:从纯粹的连续内存数字阵列(NumPy ndarray),过渡到带有业务含义的异构数据表(Pandas DataFrame),再提取为可用于算法计算的特征矩阵与目标标签,最终送入机器学习模型进行预测。
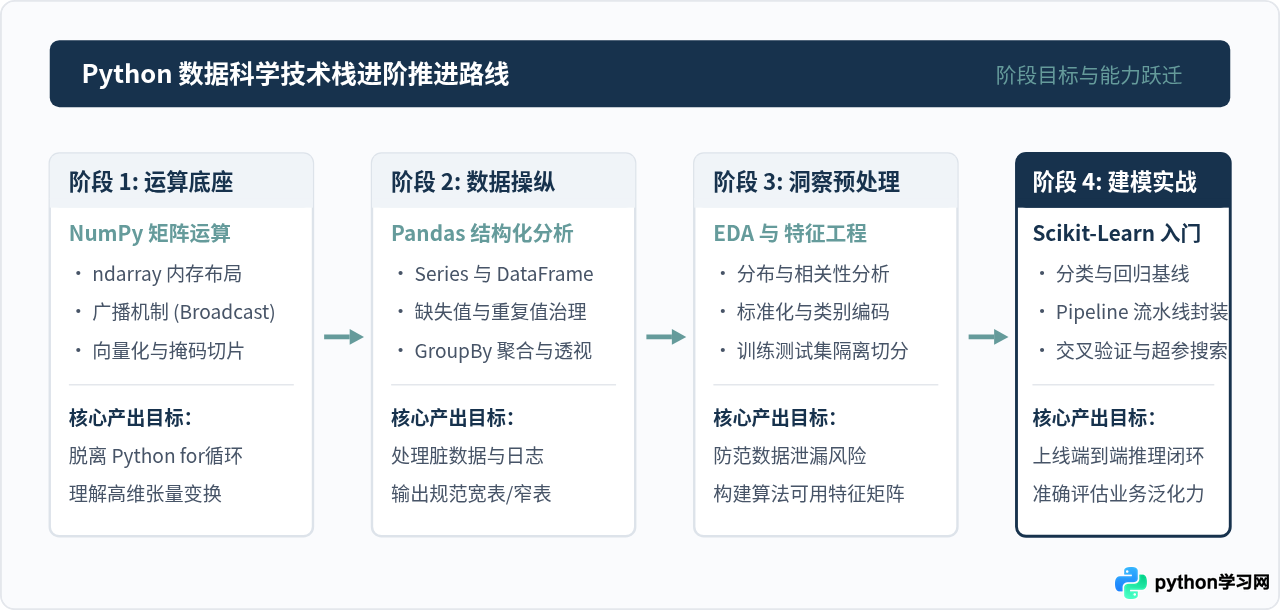
合理的学习节奏划分为四个阶段,每个阶段都有明确的交付物和能力检验标准:
- 阶段一:NumPy 多维数组与矩阵运算。核心目标是理解多维数组在内存中的连续存储原理,摆脱Python传统的for循环,掌握切片、广播机制(Broadcasting)与基础向量化统计。
- 阶段二:Pandas 结构化数据分析与清洗。核心目标是掌握Series与DataFrame的双轴索引机制,熟练进行缺失值填充、离群值处理、分组聚合(groupby)与多表关联(merge/concat)。
- 阶段三:探索性数据分析 (EDA) 与特征工程。核心目标是能够自主探索数据分布、分析变量相关性,并将原始字段转化为数值特征(标准化、归一化、独热编码),严格划分训练集与测试集以杜绝数据泄露。
- 阶段四:Scikit-Learn 经典机器学习入门。核心目标是理解评估指标的商业场景适配,掌握fit/transform/predict统一接口,构建包含预处理和算法模型的Pipeline,掌握交叉验证与超参数调优。
二、阶段一:NumPy 矩阵运算与向量化思维
NumPy(Numerical Python)是几乎所有现代Python科学计算库(包括Pandas、SciPy、Scikit-Learn以及PyTorch)的底层基石。初学者最容易犯的错误是把NumPy数组当成普通的Python列表(list)来用,继续在外部嵌套多重for循环,导致运行速度大幅下降。
1. 内存连续性与向量化(Vectorization)
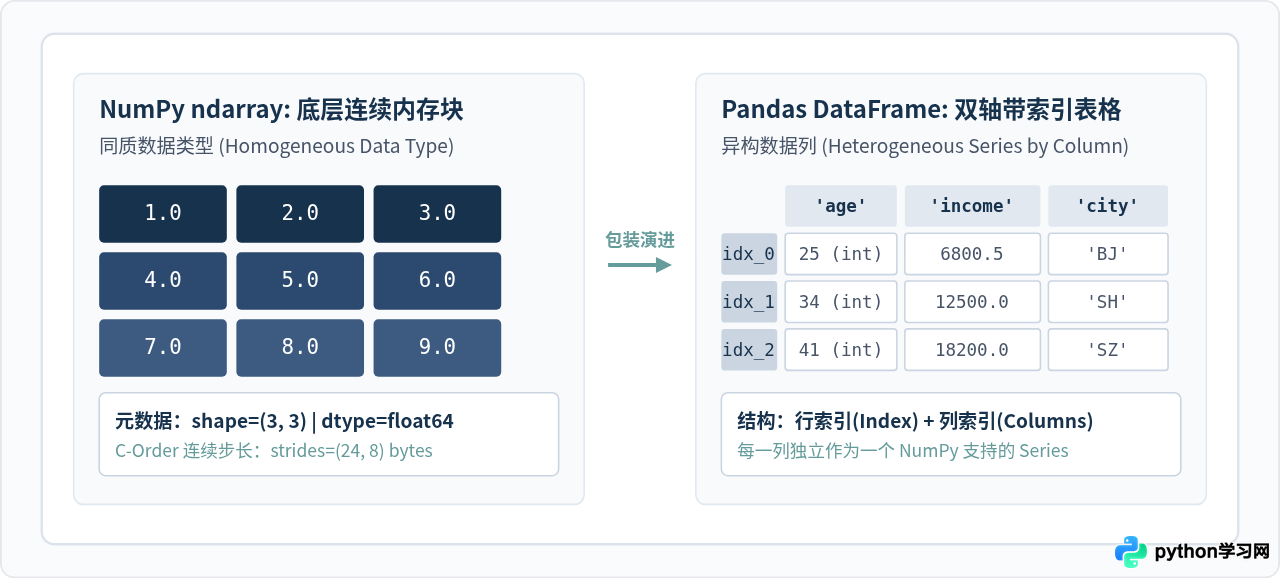
Python内置列表内部存储的是对象的指针,元素在物理内存中离散分布;而NumPy的ndarray(N-dimensional Array)要求同质数据类型(homogenous type),在物理内存中是完全连续存储的。这使得底层可以用高度优化的C和BLAS库一次性调度CPU SIMD指令,实现并行的向量化计算。
import numpy as np

# 创建连续内存的一维与二维浮点数组
arr_1d = np.array([1.5, 2.0, 3.5], dtype=np.float64)
matrix_2d = np.arange(1, 10, dtype=np.float64).reshape(3, 3)

# 向量化运算:避免 for 循环,直接对整个数组应用标量数学运算
scaled_matrix = matrix_2d * 2.0 + 0.5

# 条件掩码筛选(布尔索引):提取大于 5 的元素
filtered_elements = matrix_2d[matrix_2d > 5]sub_arr = arr[0:2, 0:2]),返回的是原始数组的视图(View)而非副本(Copy)。如果修改了 sub_arr 中的某个值,原始的 arr 也会被直接修改。如果需要脱离原数组独立修改,必须显式调用 arr[0:2, 0:2].copy()。
2. 广播机制(Broadcasting)的计算规则
当两个维度不同的数组进行四则运算时,NumPy会自动尝试通过广播匹配它们的维度。广播遵循两条严格原则:从末尾维度(最右侧)向前对齐比较,若两个维度大小相同,或者其中一个维度的长度为1,则满足广播条件;否则抛出 ValueError: operands could not be broadcast together。
三、阶段二:Pandas 数据清洗与业务统计分析
在真实商业场景中,几乎没有开箱即用的干净数字矩阵。数据通常以CSV、Parquet、SQL数据库或JSON日志形式存在,充斥着缺失值(NaN)、格式混乱的字符串、异常值与冗余记录。Pandas在NumPy之上封装了强大的索引和列级操作能力,是数据清洗的主力工具。
1. 核心数据结构与索引规范
Pandas的核心是 Series(一维带标签数组)和 DataFrame(二维异构数据表格)。在访问数据时,务必分清按标签索引(.loc)与按整数位置索引(.iloc):
import pandas as pd

# 读取外部数据源,指定解析参数
df = pd.DataFrame({
    'user_id': [1001, 1002, 1003, 1004, 1005],
    'age': [24, np.nan, 38, 45, 29],
    'department': ['Tech', 'Tech', 'Sales', 'HR', 'Tech'],
    'salary': [14000.0, 16500.0, 9200.0, 8500.0, np.nan]
})

# 正确的切片索引:标签显式访问 vs 位置索引
user_subset = df.loc[df['department'] == 'Tech', ['user_id', 'salary']]
first_three_rows = df.iloc[0:3, 1:4]
2. 缺失值诊断与清洗范式
清洗数据不可盲目执行 df.dropna(),否则容易导致大量有效样本丢失。标准的清洗步骤应包括:缺失率统计、分类型填补与逻辑校验。
# 1. 缺失情况快速诊断
missing_stats = df.isnull().sum()

# 2. 数值型特征使用中位数或分组中位数填补(抵御极大离群值干扰)
dept_salary_median = df.groupby('department')['salary'].transform('median')
df['salary'] = df['salary'].fillna(dept_salary_median)

# 3. 基础数值型字段填补全局中位数
df['age'] = df['age'].fillna(df['age'].median())

# 4. 去除完全重复记录与非法负值
df = df.drop_duplicates(subset=['user_id'])
df = df[df['salary'] > 0]
四、阶段三:探索性数据分析 (EDA) 与特征工程流水线
把清洗完毕的Pandas表格输入机器学习模型之前,必须完成特征工程。原始字段中的类别标签(如“Tech”、“Sales”)计算机无法直接执行梯度下降或矩阵相乘,必须转化为数字向量;同时,不同特征的量纲(如年龄[20-60]与收入[5000-50000])跨度巨大,会导致基于距离或梯度的算法收敛缓慢。
1. 类别特征编码与数值缩放
类别变量处理通常分为两类:无序分类(如城市、部门)使用独热编码(One-Hot Encoding);具有天然大小顺序的分类(如学历:大专<本科<硕士)使用序数编码(Ordinal Encoding)。数值特征则使用标准差缩放(StandardScaler)或区间缩放(MinMaxScaler)。
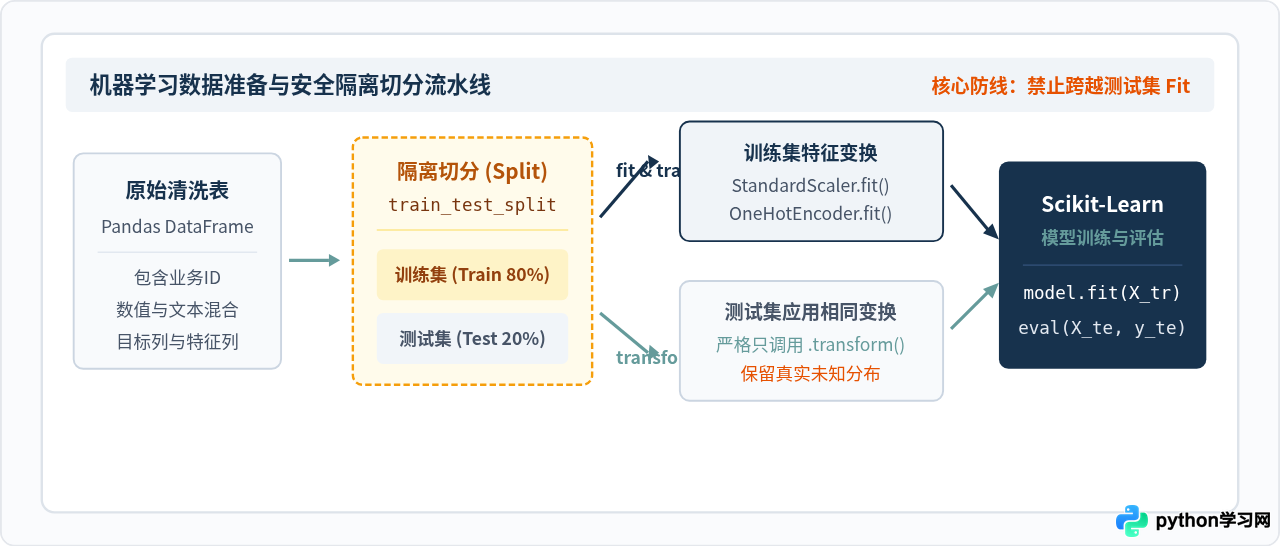
scaler.fit(X_train)),然后将该规则同时应用于训练集和测试集(scaler.transform(X_test))。如果在切分数据集之前对全量数据执行 fit,测试集的信息就会提前泄露到模型训练中,导致线下评测分数虚高,线上部署严重劣化。
五、阶段四:Scikit-Learn 经典机器学习入门实战
Scikit-Learn(sklearn)是Python经典机器学习的首选库。它的强大之处在于高度统一的API规范。无论底层运行的是逻辑回归、支持向量机、随机森林还是梯度提升树,均遵循三大核心函数接口:
estimator.fit(X, y):基于输入的特征矩阵X和目标标签y进行参数学习与权重优化。transformer.transform(X):应用已经学习到的转换规则(如均值与方差),返回变换后的特征。estimator.predict(X):对新的特征输入矩阵生成预测标签。
完整端到端建模示例
下面的代码演示如何使用 ColumnTransformer 与 Pipeline,将缺失值填补、类别独热编码、数值标准化和分类器有机串联为一个单一对象:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, roc_auc_score

# 1. 模拟业务数据集
raw_data = {
    'age': [25, 42, np.nan, 35, 50, 23, 40, 60, 31, 29],
    'balance': [1200.0, 50000.0, 300.0, 15000.0, 25000.0, 800.0, 12000.0, 45000.0, 3200.0, 1100.0],
    'education': ['college', 'master', 'high_school', 'college', 'master', 'college', 'college', 'master', 'high_school', 'college'],
    'purchased': [0, 1, 0, 1, 1, 0, 1, 1, 0, 0]
}
df_sample = pd.DataFrame(raw_data)

# 2. 特征与标签分离,严格隔离切分
X = df_sample.drop(columns=['purchased'])
y = df_sample['purchased']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# 3. 构建列级变换器(数值与文本列分支处理)
numeric_features = ['age', 'balance']
numeric_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

categorical_features = ['education']
categorical_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='most_frequent')),
    ('onehot', OneHotEncoder(handle_unknown='ignore'))
])

preprocessor = ColumnTransformer(
    transformers=[
        ('num', numeric_transformer, numeric_features),
        ('cat', categorical_transformer, categorical_features)
    ]
)

# 4. 组装端到端流水线(包含特征工程与算法)
clf_pipeline = Pipeline(steps=[
    ('preprocessor', preprocessor),
    ('classifier', RandomForestClassifier(n_estimators=50, random_state=42))
])

# 5. 一键训练与评估
clf_pipeline.fit(X_train, y_train)
y_pred = clf_pipeline.predict(X_test)
y_pred_proba = clf_pipeline.predict_proba(X_test)[:, 1]

# 示例输出报告
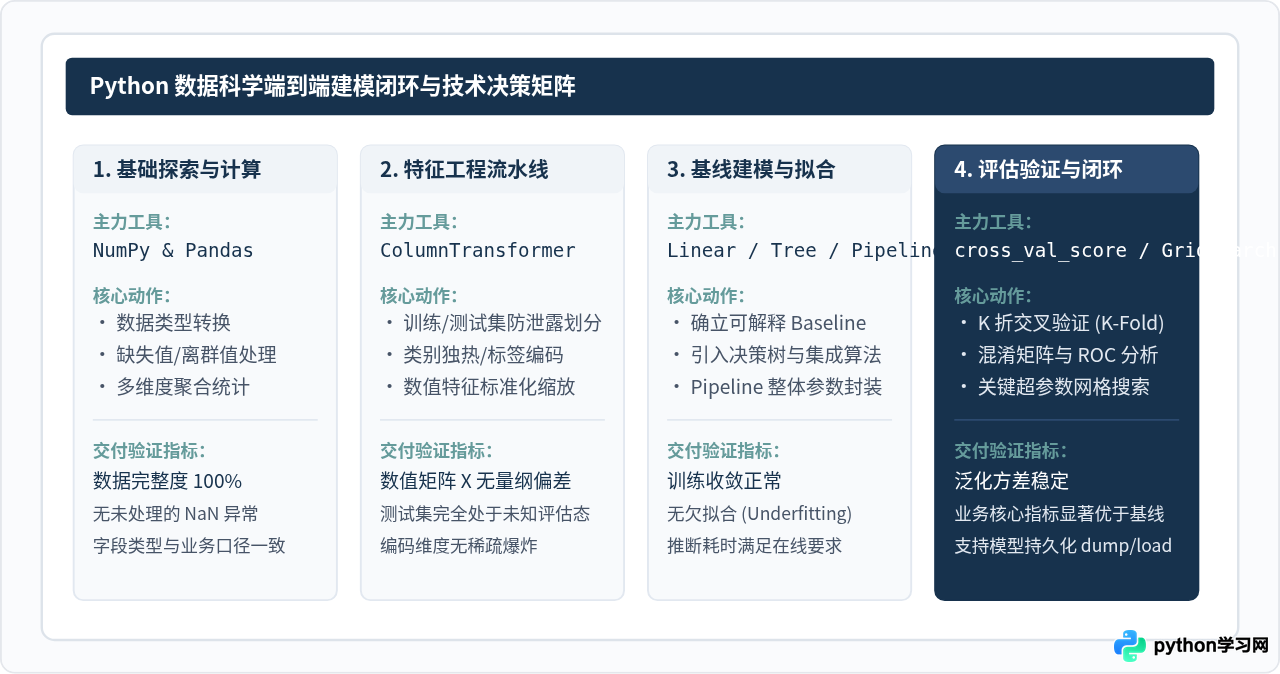
print(classification_report(y_test, y_pred, zero_division=0))sklearn.pipeline.Pipeline,交叉验证框架在执行每一次数据切片时,都会严格仅在当前的训练子折上进行 fit,确保实验评估结果具备工业级可靠性。
六、算法评估指标的选型依据
模型预测完成后,不能单一依靠准确率(Accuracy)作为判断标准。在正负样本不平衡场景中(例如反欺诈场景中,黑产用户仅占0.1%),模型即便将所有样本全都预测为正常用户,准确率也可以高达99.9%,但实际上毫无业务价值。
| 任务类型 | 常用指标 | 数学含义 | 适用业务场景与决策依据 |
|---|---|---|---|
| 二分类(类别均衡) | Accuracy | 预测正确的样本数 / 总样本数 | 各类别重要度对等且样本数量分布均匀的基线任务。 |
| 二分类(关注漏报) | Recall(召回率) | TP / (TP + FN) | 疾病筛查、设备故障预警。宁可误报复查,绝不能漏报核心缺陷。 |
| 二分类(关注误报) | Precision(精确率) | TP / (TP + FP) | 垃圾邮件拦截、高价值客户营销推送。宁可漏发,不可骚扰用户。 |
| 二分类(综合权衡) | F1-Score / AUC-ROC | P与R的调和平均 / 排序能力 | 风控欺诈检测、推荐系统点击率预估。衡量阈值变化下的综合抗噪能力。 |
| 连续值回归 | RMSE / MAE / R² | 均方根误差 / 平均绝对误差 / 拟合优度 | 销售额预测、房价估算。RMSE惩罚极端误差更重,MAE对离群值鲁棒。 |
七、学习避坑清单与进阶落地建议
按照上述路线推进时,初学者往往会在几处隐蔽的工程细节上耗费大量时间。总结并牢记以下三条工程准则,可以大幅提升开发效率与模型鲁棒性:
- 不要急于调用深度学习或复杂集成算法。在工业界数据科学项目中,80%的性能提升来自深入的业务理解、高质量的数据清洗与精细的特征工程。直接使用默认参数的逻辑回归或随机森林配合高质量特征,往往表现远优于未经清洗便草率送入复杂神经网络的模型。
- 警惕
SettingWithCopyWarning警告。在Pandas中进行链式赋值(例如df[df['age'] > 30]['salary'] = 10000)时,Pandas无法确定返回的是原对象的副本还是视图,可能导致修改失败。务必使用明确的.loc语法:df.loc[df['age'] > 30, 'salary'] = 10000。 - 保存完整 Pipeline 而非单个模型权重。在线上部署阶段,输入系统的是未经处理的用户请求原始数据。如果只导出了训练好的模型权重文件(如
clf.pkl),在线服务就必须手动复写一遍缩放、缺失填充等逻辑,极易引发线上线下特征计算不一致(Train-Serve Skew)。必须使用joblib.dump(pipeline, 'model_pipeline.pkl'),将预处理逻辑与算法模型打包导出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









