

Python元组比列表更快吗?内存占用与性能对比

很多初学 Python 的开发者常常将元组简单理解为“不可变版本的列表”。但实际上,CPython 在底层为这两者设计了截然不同的内存分配机制与生命周期管理策略。搞清楚它们在内存占用与执行速度上的实际差异,不仅能帮我们在编写高性能代码时做出准确选型,也能加深对 Python 运行时内部原理的理解。
一、内存占用对比:为什么元组明显更小?
要量化容器自身的内存开销,可以使用 Python 标准库中的 sys.getsizeof() 函数。该函数返回对象在 CPython 中所占用的直接字节数(不包含元素本身引用的外部堆对象内存)。
import sys

# 测量不同长度的元组与列表内存占用
sizes = [0, 1, 2, 3, 5, 10, 50, 100]

print(f"{'元素个数':<10}{'元组大小 (Bytes)':<18}{'列表大小 (Bytes)':<18}{'差值 (Bytes)':<10}")
print("-" * 56)
for n in sizes:
    t_size = sys.getsizeof(tuple(range(n)))
    l_size = sys.getsizeof(list(range(n)))
    diff = l_size - t_size
print(f"{n:<10}{t_size:<18}{l_size:<18}{diff:<10}")| 元素个数 | 元组内存 (Bytes) | 列表内存 (Bytes) | 列表相比元组的多余开销 |
|---|---|---|---|
| 0 (空容器) | 40 | 56 | +16 字节 (+40.0%) |
| 1 | 48 | 64 | +16 字节 (+33.3%) |
| 3 | 64 | 80 | +16 字节 (+25.0%) |
| 10 | 120 | 136 | +16 字节 (+13.3%) |
| 100 | 840 | 856 | +16 字节(静态构建) |
从数据中可以看出两个核心事实:第一,在相同元素规模下,元组的内存占用始终小于列表;第二,上面表格中展示的是直接从定长迭代器构造的列表。如果列表是通过 append() 动态追加生成的,列表所占用的内存会呈现阶梯式跳跃,差距还会进一步扩大。
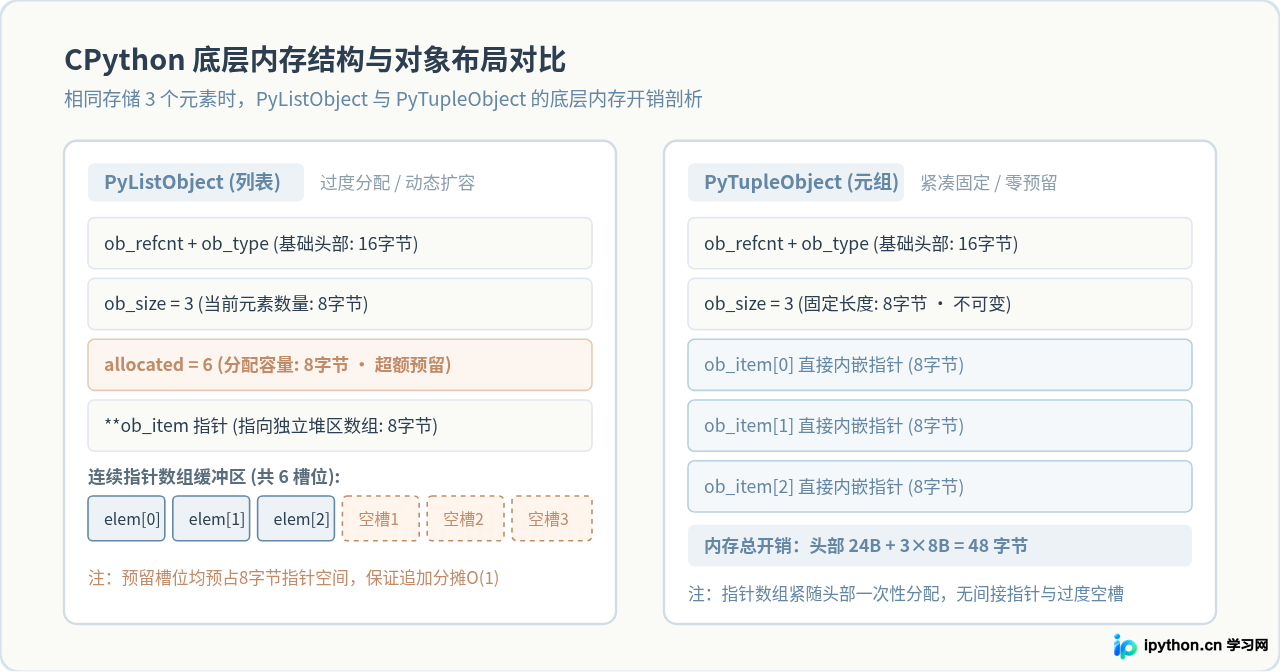
造成这种差异的根本原因在于 CPython 底层的结构体定义:
- PyTupleObject(元组):作为不可变序列,元组在创建时长度就已经完全固定。其结构体包含基础对象头部(引用计数
ob_refcnt、类型指针ob_type和元素数量ob_size,合计 24 字节),随后紧跟固定长度的指针数组。无需维护扩容容量,没有多余的预留内存槽位。 - PyListObject(列表):作为动态可变数组,列表必须支持高效的
append()和insert()操作。为此,列表结构体除了基础对象头部外,还包含一个指向堆区连续指针数组的二级指针ob_item以及当前已分配的容量槽位数allocated。为了分摊频繁追加带来的内存重新分配成本,列表采用了超额分配(Over-allocation)算法,大部分时间都会保留闲置的槽位指针。
二、运行性能实测:元组到底快在哪里?
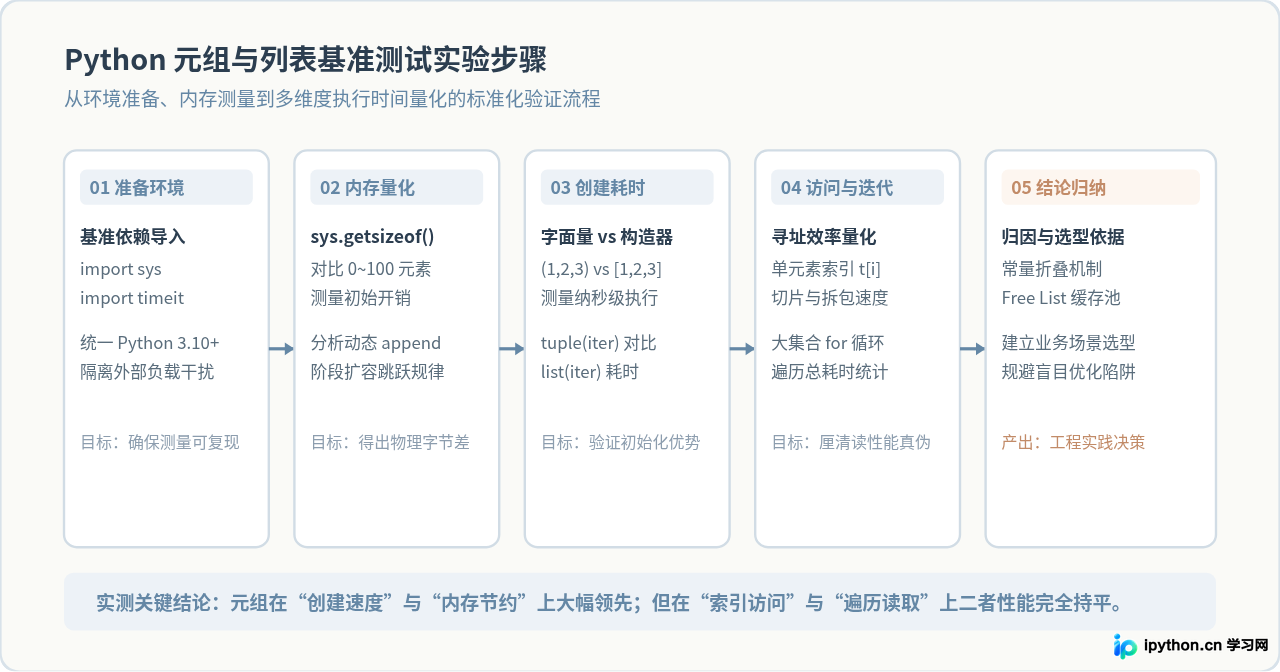
回答“元组是否比列表更快”,必须按操作类型严格区分:创建、索引访问、迭代与解包。下面使用标准库的 timeit 模块在相同的单核环境下进行基准测试。
1. 创建耗时对比(字面量与构造函数)
import timeit

# 1. 字面量创建对比 (各执行 10,000,000 次)
tuple_literal_time = timeit.timeit("(1, 2, 3, 4, 5)", number=10_000_000)
list_literal_time  = timeit.timeit("[1, 2, 3, 4, 5]", number=10_000_000)

print(f"字面量元组耗时: {tuple_literal_time:.4f} 秒")
print(f"字面量列表耗时: {list_literal_time:.4f} 秒")
print(f"字面量元组速度领先: {list_literal_time / tuple_literal_time:.2f} 倍\n")

# 2. 动态可迭代对象构造对比 (各执行 1,000,000 次)
tuple_func_time = timeit.timeit("tuple(src)", setup="src = list(range(100))", number=1_000_000)
list_func_time  = timeit.timeit("list(src)", setup="src = tuple(range(100))", number=1_000_000)

print(f"动态构建元组耗时: {tuple_func_time:.4f} 秒")
print(f"动态构建列表耗时: {list_func_time:.4f} 秒")示例输出:
字面量元组耗时: 0.0821 秒
字面量列表耗时: 0.3645 秒
字面量元组速度领先: 4.44 倍
动态构建元组耗时: 0.3120 秒
动态构建列表耗时: 0.3480 秒实测发现:在直接使用字面量语法(形如 (1, 2, 3) 与 [1, 2, 3])时,元组的速度呈现出压倒性的优势,比列表快了 4 倍以上。而在使用 tuple() 与 list() 对已有迭代器进行拷贝或转换时,元组依然稍快一些,但差距已经收窄至 10%~15% 左右。
2. 索引访问与遍历耗时对比
# 索引读取测试 (各执行 10,000,000 次读取第 50 项)
tuple_access_time = timeit.timeit("t[50]", setup="t = tuple(range(100))", number=10_000_000)
list_access_time  = timeit.timeit("l[50]", setup="l = list(range(100))", number=10_000_000)

print(f"元组索引访问耗时: {tuple_access_time:.4f} 秒")
print(f"列表索引访问耗时: {list_access_time:.4f} 秒")
示例输出:
元组索引访问耗时: 0.2312 秒
列表索引访问耗时: 0.2325 秒实测发现:两者的索引查找耗时差异通常在 1% 以内,完全属于测试环境的测量噪点。这意味着:在元素访问和循环遍历环节,元组并不会比列表带来可感知的速度提升。两者的底层寻址逻辑都是基于数组首地址加上偏移量直接寻址,时间复杂度均为标准的 \(O(1)\)。
三、深层原理解析:元组创建飞快的两大核心机制
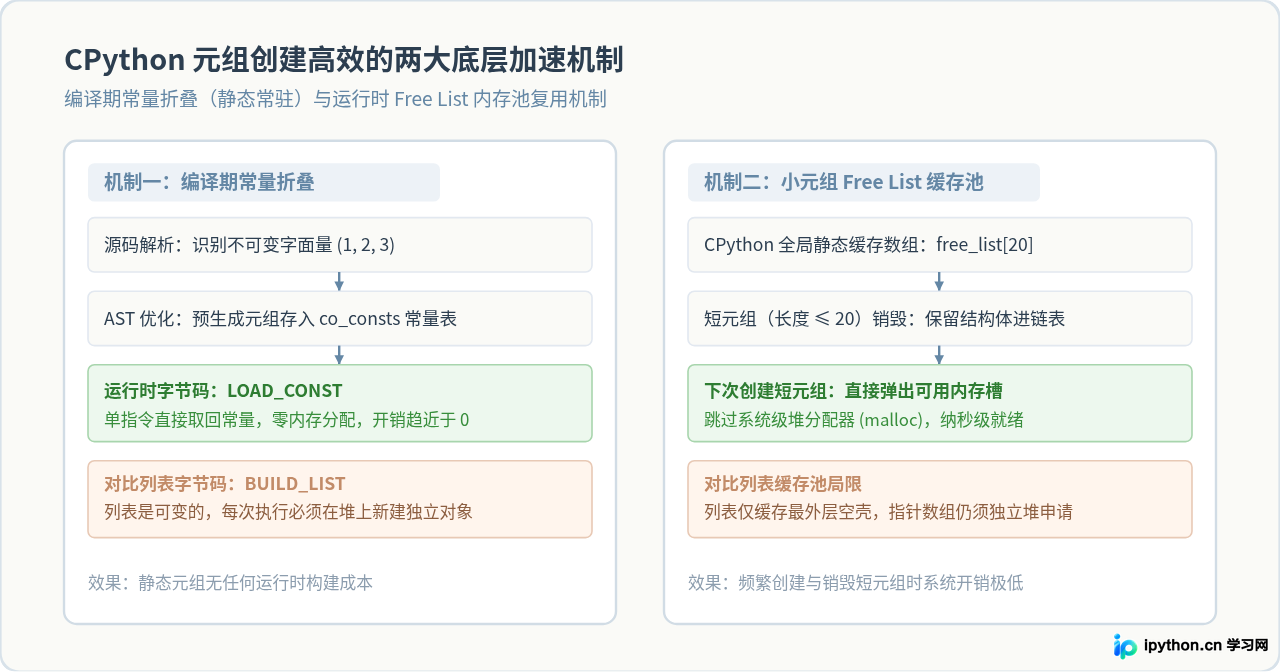
为什么字面量元组的创建速度能大幅领先列表?答案隐藏在 CPython 编译器的两项专门优化中:编译期常量折叠与运行时空闲链表(Free List)。
1. 常量折叠(Constant Folding)与字节码差异
我们可以使用标准库的 dis 模块查看 Python 编译生成的底层字节码指令:
import dis

def make_tuple():
    return (1, 2, 3)

def make_list():
    return [1, 2, 3]

print("=== 元组字节码 ===")
dis.dis(make_tuple)

print("\n=== 列表字节码 ===")
dis.dis(make_list)
示例输出:
=== 元组字节码 ===
2 0 LOAD_CONST 1 ((1, 2, 3))
2 RETURN_VALUE
=== 列表字节码 ===
5 0 BUILD_LIST 0
2 LOAD_CONST 4 ((1, 2, 3))
4 LIST_EXTEND 1
6 RETURN_VALUE从字节码可以看出:由于元组是不可变的,Python 编译器在编译函数时执行了“常量折叠”。编译器把 (1, 2, 3) 视为一个字面量常量,预先构建好并直接存放在代码对象的 co_consts 元组中。运行时只需要执行一条极快的 LOAD_CONST 指令即可获取该对象的引用。
而列表是可变对象,每次调用 make_list() 时,返回的列表都必须是相互隔离的独立对象(对其中一个列表进行修改绝不能影响另一个)。因此,Python 无法对其进行常量复用,每次执行都必须在堆内存中重新申请空间并完成初始化。
2. 小对象缓存池(Free List)
在 CPython 源码中,内部维护了一个针对长度在 1 到 20 之间的短元组缓存池(free_list)。当一个短元组的引用计数归零被垃圾回收时,CPython 并不把它的内存释放回操作系统堆,而是将该内存块挂入对应长度的空闲链表中。下次程序再次需要该长度的元组时,直接从链表中取出现成内存块复用。
列表虽然也有一个由 80 个 PyListObject 构成的空闲列表,但该缓存仅能复用列表的头部外壳。列表用来存储元素的实际指针数组(ob_item)由于长度变化不定,仍然必须通过 PyMem_Malloc 去系统堆区单独申请内存,因此分配成本显著高于元组。
四、工程选型指南:何时用列表,何时用元组?
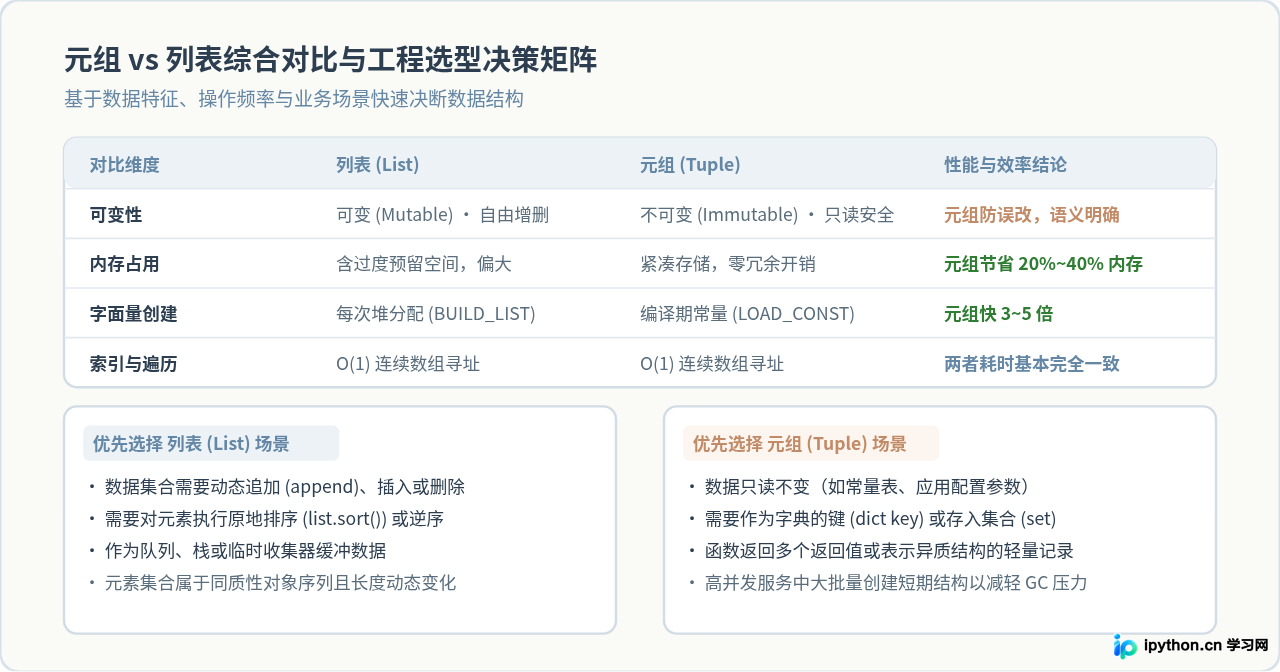
了解了性能和内存机制后,在实际项目中该如何选择?盲目将所有列表替换为元组并不可取,因为两者的设计初衷服务于完全不同的业务场景。
1. 适合选择元组的场景
- 字典键与集合成员:元组是可哈希的(只要其内部元素均可哈希),可以安全地作为
dict的键或set的成员,而列表绝对无法做到这一点。 - 函数的多返回值与解包:Python 函数通过逗号返回多个值时默认生成元组。在跨函数传递只读数据包时,元组的轻量化特性能够最大程度减少内存分配与拷贝。
- 静态配置与常量映射:对于程序运行期间固定不变的配置字典、坐标点
(x, y)或状态码映射,使用元组不仅避免了被意外修改的风险,还享受到编译期常量折叠带来的启动提速。 - 海量只读数据驻留内存:当需要加载数十万乃至数百万条轻量数据记录时,使用元组(或
namedtuple)相比列表能显著削减系统的物理常驻内存(RSS)。
2. 适合选择列表的场景
- 动态缓冲与数据累加:需要通过循环逐步收集数据、调用
append()或extend()的场景。列表的过度分配机制正是为了在此类场景下保持 \(O(1)\) 的均摊追加性能。 - 原地重排与就地修改:需要调用
.sort()、.reverse()或者通过切片进行批量赋值更新的业务流。如果使用元组,任何修改都必须重新分配并拷贝一个全新的元组对象,反而会严重拖慢性能。
如果元组内部包含了列表,如
t = (1, [2, 3]),虽然元组自身的指针数组不可改变,但嵌套的列表仍然可以执行 append() 等就地修改。此时该元组将失去可哈希性,无法用作字典的键。
五、全文总结
回到最初的问题:“Python元组比列表更快吗?”
准确的回答是:
- 在创建速度上:是,而且显著更快。字面量元组由于编译期常量折叠和运行时 Free List 的双重加持,构建速度比列表快 3 到 5 倍。
- 在内存占用上:是,元组明显更小。元组采用紧凑连续分配,没有动态过度预留的闲置指针槽,相同元素下内存占用节省约 20%~40%。
- 在访问速度上:否,两者几乎完全一样。在底层,元组与列表的索引定位都是直接的数组指针偏移操作,读取速度处于同一水平。
在日常开发中,建议遵循“需要修改选列表,只读不变选元组”的基本原则。让不可变性为代码提供天然的防御性保证,同时享受 CPython 在内存与初始化效率上的底层红利。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









