

Python元组和列表的区别:可变性、内存与性能对比

在 Python 中,元组(tuple)和列表(list)都属于内建的有序序列,支持通过索引访问、切片操作以及包含任意类型的元素。两者最根本的区别在于可变性(Mutability):列表是动态可变的对象,允许在原处增加、删除或修改元素;元组则是不可变对象,一经创建其包含的元素引用便固定不可更改。由此核心差异衍生出两者在底层数据结构设计、内存开销控制和运行执行效率上的系统性分流:元组拥有定长紧凑的存储布局与快速创建机制,而列表则通过预分配连续指针数组支撑动态扩缩容。
一、核心特征与可变性本质
理解元组与列表的第一步是厘清“对象本身可变”与“对象所引用的目标可变”之间的界限。列表的本质是一个可调整大小的连续指针容器。当调用 append()、extend()、pop() 或执行索引赋值 lst[i] = val 时,修改直接作用于该列表对象内部维护的指针槽,容器的内存物理地址保持不变。
# 列表的原处修改示例
fruits = ["apple", "banana"]
print(f"修改前 ID: {id(fruits)}")

fruits.append("orange")
fruits[0] = "pear"
print(f"修改后 ID: {id(fruits)}, 内容: {fruits}")
# 示例输出:
# 修改前 ID: 140428938491200
# 修改后 ID: 140428938491200, 内容: ['pear', 'banana', 'orange']
元组一旦完成初始化,其内部的指针槽数量与每个槽指向的目标对象地址就被彻底冻结。如果尝试对元组进行增删或索引重新赋值,Python 解释器会在执行阶段直接抛出 TypeError。
point = (10, 20)
try:
    point[0] = 30
except TypeError as e:
    print(f"操作被拒绝: {e}")
# 示例输出:
# 操作被拒绝: 'tuple' object does not support item assignment这里存在一个开发者极易忽视的边界场景:“元组不可变”仅指元组直接持有的引用不可变,并不保证所引用的对象内容不可变。若元组内部包含了一个可变对象(如列表或字典),该内部对象自身的状态依然可以被修改,但元组对该对象的引用地址未曾改变。
# 嵌套可变对象的元组
nested_tuple = (1, [10, 20])
nested_tuple[1].append(30)
print(f"嵌套修改后: {nested_tuple}")
# 示例输出:
# 嵌套修改后: (1, [10, 20, 30])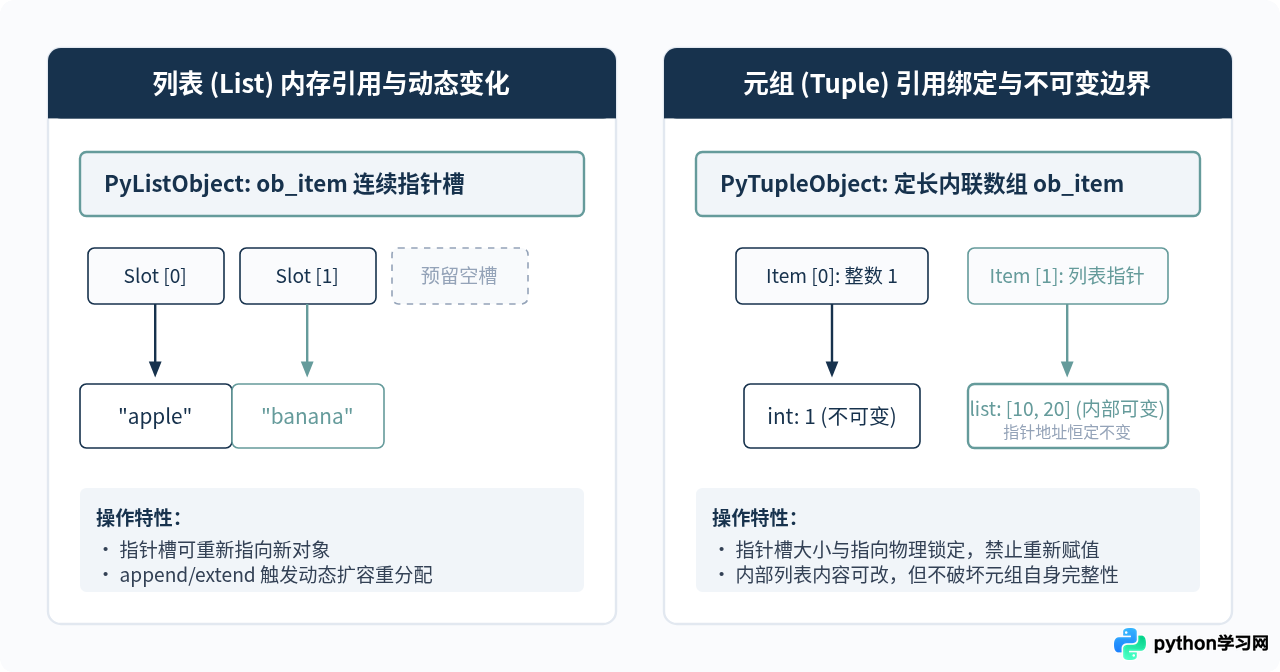
二、底层结构与内存开销对比
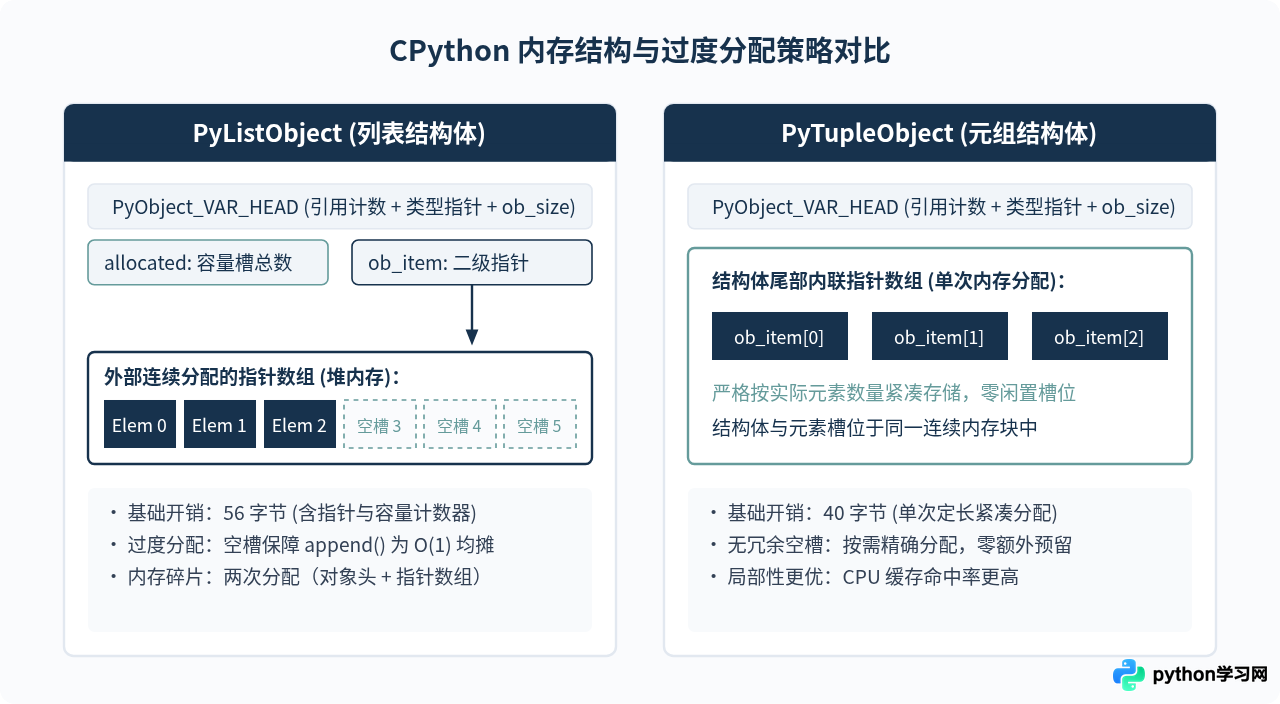
在 CPython 源码实现中,列表和元组的结构体定义展示了二者内存占用差异的本质原因。列表对应结构体 PyListObject,元组对应 PyTupleObject。由于列表需要支持常数均摊时间 O(1) 的追加操作,CPython 采取了过度分配(Over-allocation)机制。
PyListObject 的内存结构由两部分组成:第一部分是包含标准对象头部(引用计数 ob_refcnt、类型指针 ob_type)、元素当前数量 ob_size、指向元素指针数组的二级指针 ob_item 以及当前已分配容量槽数量 allocated 的结构体本体;第二部分则是 ob_item 指向的连续指针数组。
相比之下,PyTupleObject 极其轻量。在标准头部(包含 ob_refcnt、ob_type、ob_size)之后,直接在结构体末尾通过结构体数组柔性数组内联存储元素指针 ob_item[1]。元组不需要二级指针跳转,不需要记录 allocated 字段,更没有任何预留冗余空间。
import sys

# 测量空序列与单元素序列的内存差异 (64位CPython环境)
empty_tuple = ()
empty_list = []
one_tuple = (1,)
one_list = [1]

print(f"空元组大小: {sys.getsizeof(empty_tuple)} 字节")
print(f"空列表大小: {sys.getsizeof(empty_list)} 字节")
print(f"1元素元组: {sys.getsizeof(one_tuple)} 字节")
print(f"1元素列表: {sys.getsizeof(one_list)} 字节")
# 示例输出:
# 空元组大小: 40 字节
# 空列表大小: 56 字节
# 1元素元组: 48 字节
# 1元素列表: 64 字节
当列表不断追加元素时,CPython 按照类似 new_allocated = (size_t)newsize + (newsize >> 3) + (newsize < 9 ? 3 : 6) 的公式进行非线性扩容。这就意味着列表经常处于“已分配槽位远大于实际存储元素数量”的状态,造成额外的内存冗余。
三、运行性能实测与底层机制剖析
许多开发者知道“元组比列表快”,但未必明确究竟快在哪里。在常规的索引访问 seq[i] 或纯遍历迭代场景下,元组和列表的耗时差距微乎其微,因为底层都是基于连续数组的指针步进。元组真正的性能优势主要集中在创建效率、常量折叠(Constant Folding)以及空闲列表(Free List)内存缓存。
1. 编译期常量折叠与字节码差异
通过 Python 官方模块 dis 观察包含字面量的函数字节码,可以直观看到解释器对元组的特殊优化:
import dis

def create_list():
    return [1, 2, 3]

def create_tuple():
    return (1, 2, 3)

print("--- 列表字节码 ---")
dis.dis(create_list)
print("\n--- 元组字节码 ---")
dis.dis(create_tuple)
字节码反编译输出如下(以 Python 3.10+ 为例):
--- 列表字节码 ---
  2           0 BUILD_LIST               0
              2 LOAD_CONST               1 ((1, 2, 3))
              4 LIST_EXTEND              1
              6 RETURN_VALUE

--- 元组字节码 ---
  2           0 LOAD_CONST               1 ((1, 2, 3))
              2 RETURN_VALUE
在编译为字节码阶段,元组字面量 (1, 2, 3) 属于完全不可变常量,编译器直接将其放入代码对象的常量表 co_consts 中。运行时函数调用仅仅执行一条极快的 LOAD_CONST 指令,取出已存在的元组常量返回即可。而对于列表,由于必须返回一个全新、独立、可被修改的列表对象,解释器每次执行都必须在堆上动态分配内存并初始化该对象。
2. CPython 空闲列表(Free List)优化
为了缓解频繁创建和销毁小对象的开销,CPython 内部为特定长度(小于等于 20 个元素)的元组维护了空闲列表缓存池。当一个短元组被销毁且引用计数降为 0 时,解释器并不会立即将内存归还给操作系统,而是将其收纳进对应长度的空闲链表中。当下次代码再次创建同长度的元组时,直接复用已分配好的内存块,彻底省去了系统内存分配系统调用的开销。列表虽然对空列表对象也有少量缓存,但在通用分配与大小可变性上无法做到如此彻底的复用。
3. 基准测试与耗时量化
使用标准库 timeit 对二者的字面量创建、动态构造及遍历耗时进行基准测试:
import timeit

# 字面量创建对比 (各执行 10,000,000 次)
time_list = timeit.timeit("[1, 2, 3, 4, 5]", number=10_000_000)
time_tuple = timeit.timeit("(1, 2, 3, 4, 5)", number=10_000_000)

print(f"创建列表 1000万次耗时: {time_list:.4f} 秒")
print(f"创建元组 1000万次耗时: {time_tuple:.4f} 秒")
print(f"元组创建速度相比列表提升: {((time_list - time_tuple) / time_list) * 100:.1f}%")

# 遍历求和对比
iter_list = timeit.timeit("sum(l)", setup="l = [i for i in range(1000)]", number=100_000)
iter_tuple = timeit.timeit("sum(t)", setup="t = tuple(range(1000))", number=100_000)
print(f"列表求和 10万次耗时: {iter_list:.4f} 秒")
print(f"元组求和 10万次耗时: {iter_tuple:.4f} 秒")
# 示例测试结果参考:
# 创建列表 1000万次耗时: 0.3852 秒
# 创建元组 1000万次耗时: 0.0768 秒
# 元组创建速度相比列表提升: 80.1%
# 列表求和 10万次耗时: 0.5821 秒
# 元组求和 10万次耗时: 0.5694 秒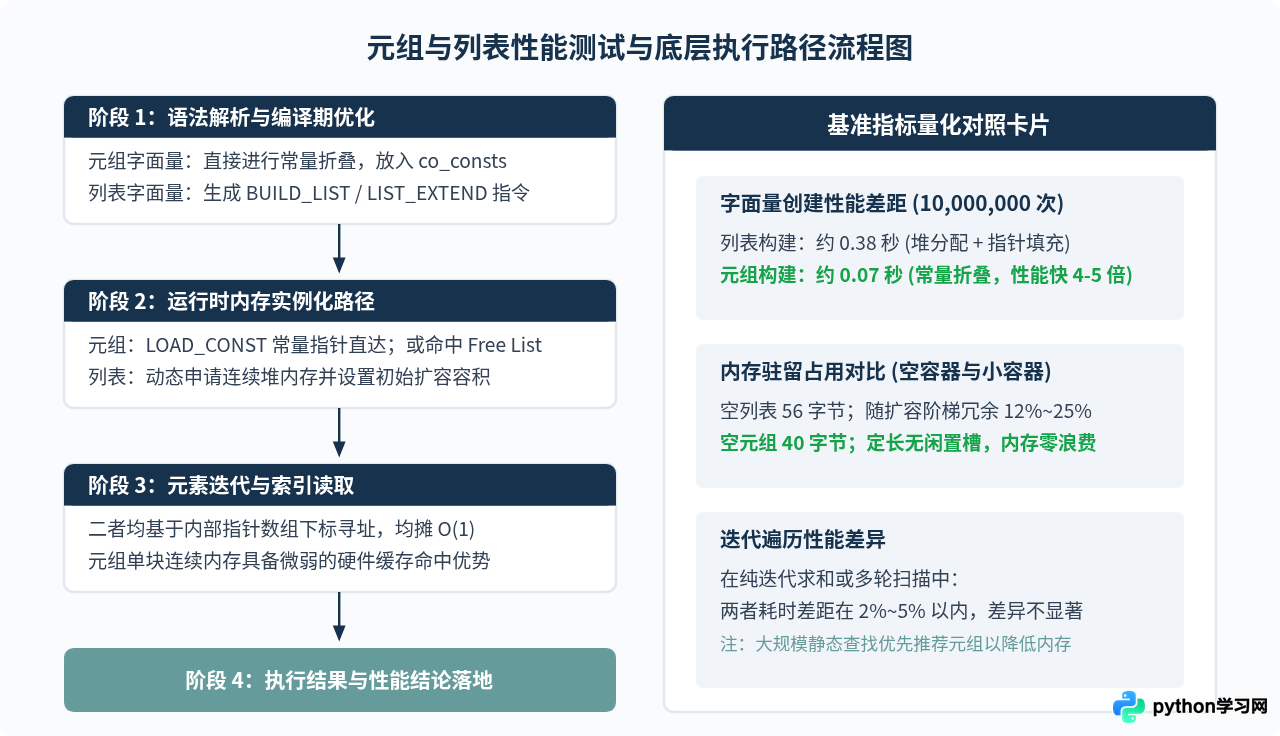
四、字典键、哈希性与语义约定
除了底层的内存与速度,元组和列表在 Python 语言生态中扮演着截然不同的语义角色,最直接的体现在于可哈希性(Hashability)与字典键支持。
1. 为什么列表不能做字典键或集合元素
Python 字典(dict)和集合(set)是基于哈希表实现的。要作为哈希表的键,对象必须实现 __hash__() 并在整个生命周期内保持哈希值恒定不变。如果允许可变对象作为键,一旦修改了该对象的内容,其哈希值改变但哈希表内部的存储桶索引未变,将导致永远无法再查找到该键。
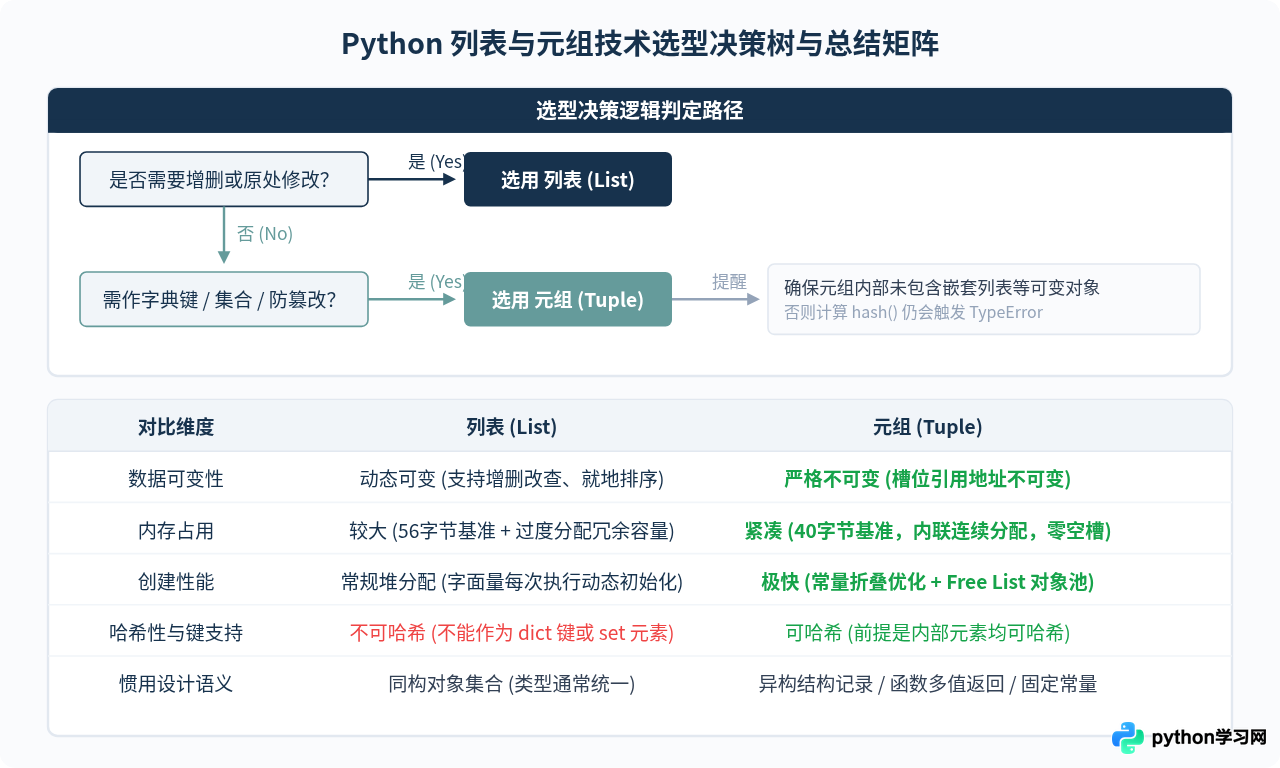
因此,Python 的 list 未实现 __hash__ 方法(即 __hash__ = None)。如果尝试将列表用作字典键,会立即触发 TypeError: unhashable type: 'list'。而 tuple 实现了 __hash__() 方法,只要元组内部的所有元素都是可哈希的,该元组就可以作为合法的字典键或加入集合中。
# 正确用法:使用元组表示多维坐标或联合键
coordinate_map = {}
coordinate_map[(120.15, 30.28)] = "杭州市"
print(coordinate_map[(120.15, 30.28)])

# 错误用法:若元组内含有不可哈希对象,该元组同样不可哈希
invalid_key_tuple = (1, [2, 3])
try:
    hash(invalid_key_tuple)
except TypeError as err:
    print(f"哈希计算失败: {err}")
# 示例输出:
# 杭州市
# 哈希计算失败: unhashable type: 'list'
2. 语义约定:同构集合 vs 异构记录
在 Python 的编程哲学中,两者有着明确的意图约定:
- 列表表达同构序列(Homogeneous sequence):列表中通常存储类型相同、顺序可变、未来可能增减的对象集合,例如用户列表
users = ["Alice", "Bob"]或采集温度点temperatures = [23.5, 24.1, 22.8]。 - 元组表达异构记录(Heterogeneous record):元组通常代表一条不可分割的结构化记录,其中不同位置代表特定含义的字段。例如数据库查询返回的一行数据
user_record = (1001, "admin", "admin@domain.com"),或者函数的多个返回值status, data = fetch_api()。
五、选型指南与全维度总结
为了在日常开发与生产架构中做出清晰的技术选型,可根据以下准则做出决策:
- 数据在生命周期内需要动态变更吗? 若需要频繁追加、插入、剔除或就地排序,选用列表。
- 数据需要作为字典键、存入集合或充当函数多返回值吗? 选用元组。
- 数据是程序运行期间的静态配置、常量表或只读快照吗? 选用元组,它不仅能防止代码被意外篡改(防御性编程),还能借助常量折叠和紧凑布局大幅压缩进程常驻内存(RSS)。
- 面对超大规模数据集时如何权衡? 如果存在千万级别的结构化条目读取且不需要修改,使用元组(或
namedtuple/ 结构体)能节省数十兆乃至上百兆内存。
| 特性维度 | 列表 (List) | 元组 (Tuple) | 工程权衡与选型依据 |
|---|---|---|---|
| 定义语法 | [item1, item2] |
(item1, item2) 或 item1, |
单元素元组必须带有逗号 (x,)。 |
| 可变性 | 可变 (Mutable) | 不可变 (Immutable) | 需要防篡改、并发安全或多线程共享只读时选元组。 |
| 内存占用 | 空列表 56 字节,动态过量分配 | 空元组 40 字节,精确紧凑内联 | 千万级静态条目读取选用元组显著降低内存驻留。 |
| 创建开销 | 每次在堆上申请并填充 | 支持 AST 常量折叠与 Free List 缓存 | 元组字面量创建性能比列表高 4 至 5 倍。 |
| 作为字典键 | 不支持(抛出 TypeError) | 支持(元素均可哈希时) | 多维网格坐标、联合查询主键天然适用元组。 |
| 常规应用场景 | 动态队列、待办清单、搜集结果集 | 数据库单行记录、多返回值、静态常量配置 | 遵循 Python 社区“同构序列用列表,异构记录用元组”约定。 |
总结而言,Python 中的元组不仅是一个“不可修改的列表”,更是一种在底层经过针对性优化的轻量只读序列。编写代码时,如果数据需要变动则自然选择列表;而对于不需要后续修改的数据、结构化记录或常量定义,应当优先选用元组以换取更高的安全性、更低的内存占用和更出色的运行性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









