

Python中math.log与numpy.log在精度和性能上有什么区别?

在Python数值计算中,math.log与numpy.log虽然都用于计算自然对数,但两者的定位和底层机制截然不同:在精度层面,对于标准单双精度浮点数(float64),两者均遵从IEEE 754标准,数值精度基本完全一致,但类型灵活性与异常边界处理机制不同;在性能层面,单标量场景下math.log的执行速度约为numpy.log的5至10倍,而在大规模数组场景下,numpy.log借助连续内存管理与SIMD向量化指令,其吞吐效率可达前者的几十倍乃至上百倍。
一、底层实现与调用架构差异
理解精度与性能差异的前提,在于认清两个函数的底层运行机制。math.log是Python标准库自带的标量数学函数,直接使用C语言编写,属于Python运行时的一部分;而numpy.log是NumPy扩展包中的通用函数(Universal Function,简称ufunc),面向多维数组与大规模数值计算进行高度优化。
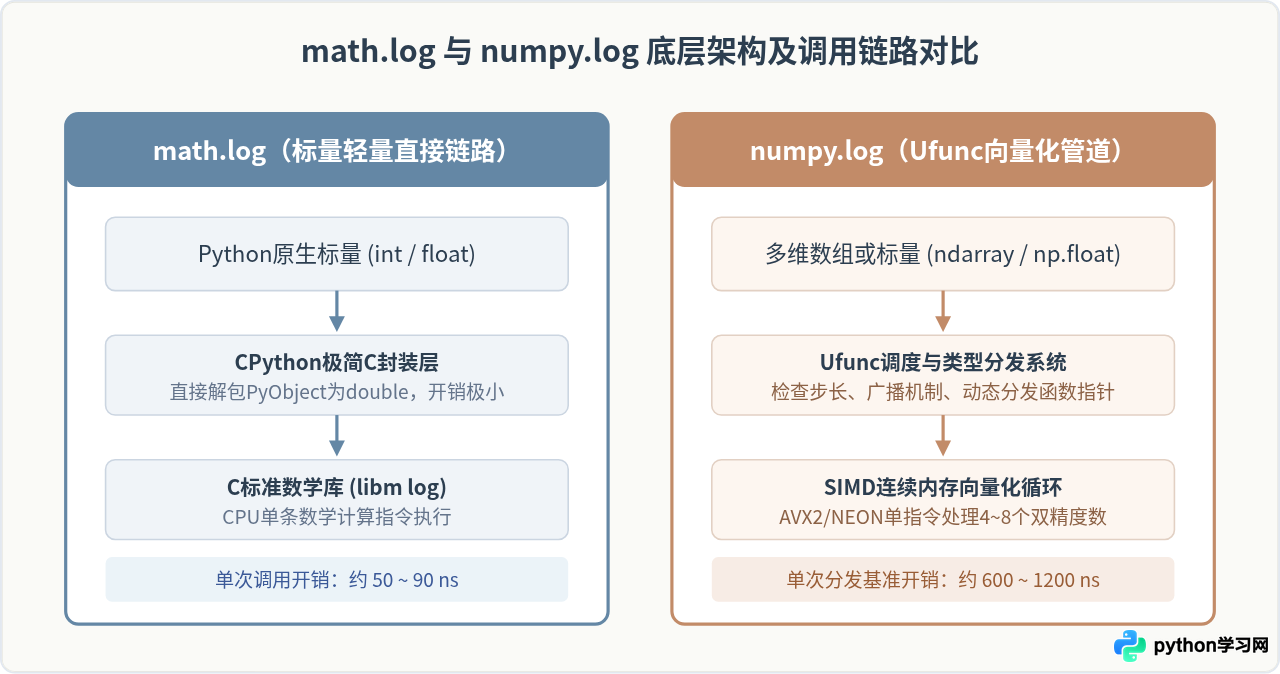
从图中可以看出:
- math.log:专为单值设计。CPython在接收到参数后,直接将其解析为C语言的原生
double类型,立即调用底层系统C数学库(libm)的log()函数,并将结果重新打包为一个Pythonfloat对象返回。其路径极短,中间几乎没有多余的抽象层。 - numpy.log:构建在NumPy通用函数架构之上。每次调用都必须经过类型推断、多维数组内存步长检查、输出内存预分配以及ufunc内核循环分发。对于单个数值,这套流水线会带来显著的固定耗时;但对于连续存储的数组,这套流水线只需执行一次分发,即可在底层利用C语言连续循环和CPU SIMD指令并行计算数百万个数据。
二、数值精度与类型系统深度对比
在数值精度方面,许多初学者误以为两个库计算出来的对数值会有明显的精确度高低之分。实际情况可以从以下三个维度进行界定:
1. 浮点基准精度(IEEE 754 标准)
在Python中,原生浮点数float实质上就是C语言中的双精度浮点数(IEEE 754 double,占用64位,53位尾数有效位)。NumPy默认的浮点类型同样是numpy.float64。在相同的系统和C运行时库(CRT/glibc/libm)环境下,对同一个合法的正双精度浮点数调用math.log(x)和numpy.log(x),计算结果在二进制层面上是逐位一致(Bit-identical)的,或者两者差异仅存在于最后一个二进制位的舍入误差(1个ULP,Unit in the Last Place)。
import math
import numpy as np

val = 12345.6789
res_math = math.log(val)
res_np = float(np.log(val))

print(f"math.log:  {res_math:.17f}")
print(f"numpy.log: {res_np:.17f}")
print("差值是否为0:", res_math - res_np == 0.0)
# 典型示例输出:
# math.log:  9.42106180373849767
# numpy.log: 9.42106180373849767
# 差值是否为0: True
2. 数据类型宽度与精度灵活性
尽管在64位下两者等价,但两者的类型支持体系存在根本区别:
- math.log 强制转为双精度:无论传入的是Python整数、长整数还是布尔值,
math.log都会先调用内部转换将其强制转为标准的Pythonfloat(64位双精度)。如果数值过大超出64位浮点数范围(约为1.8e308),会直接抛出OverflowError: int too large to convert to float。 - numpy.log 支持多精度表示:NumPy支持
float16(半精度)、float32(单精度)、float64(双精度)乃至特定平台的float128/longdouble。若需要节约显存或计算带宽,可以使用低精度的np.float32;若硬件支持且需要更高精度,可调用高精度类型。
3. 异常边界与非合法值处理机制
当计算 $x \le 0$ 的非正数对数时,两者的行为策略截然不同,这也是生产环境中极易引发故障的差异点:
| 输入场景 | math.log 行为表现 | numpy.log 行为表现 |
|---|---|---|
log(0.0) |
直接抛出异常:ValueError: math domain error |
返回 -inf(负无穷大),同时产生警告:RuntimeWarning: divide by zero encountered in log |
log(-1.0) |
直接抛出异常:ValueError: math domain error |
返回 nan(非数值),同时产生警告:RuntimeWarning: invalid value encountered in log |
复数输入 -1.0 + 0j |
抛出类型异常:TypeError: must be real number, not complex(注:复数需改用 cmath.log) |
原生支持复数对数分支解析: 返回 3.141592653589793j(对应 $i\pi$) |
| 输入类型非数值 | 尝试通过 __float__ 强转,失败则报错 |
自动应用ufunc强制类型转换规则,支持数组广播 |
三、基准实测与性能差异剖析
为了精准验证两者的性能差距,可以通过一套严谨的四步法建立测试基准:
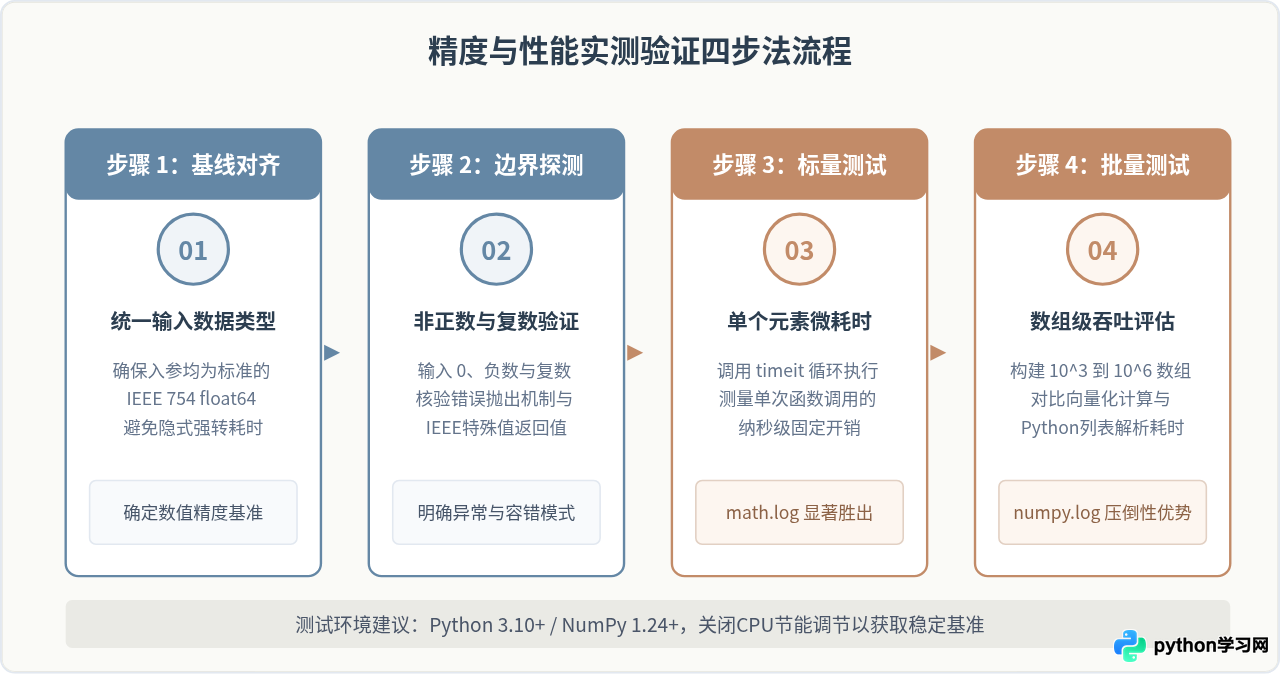
实测代码与数据结果
以下使用Python标准库timeit模块进行对比实验:
import math
import timeit
import numpy as np

# 1. 标量测试:单个浮点数计算
x_scalar = 42.0
np_scalar = np.float64(42.0)

t_math_scalar = timeit.timeit(lambda: math.log(x_scalar), number=1_000_000)
t_np_scalar = timeit.timeit(lambda: np.log(x_scalar), number=1_000_000)

print(f"标量单值耗时 (100万次):")
print(f"  math.log:  {t_math_scalar:.4f} 秒 (约 {t_math_scalar*1000:.1f} ns/次)")
print(f"  numpy.log: {t_np_scalar:.4f} 秒 (约 {t_np_scalar*1000:.1f} ns/次)")

# 2. 批量测试:100万个浮点数批量计算
N = 1_000_000
data_list = [float(i + 1) for i in range(N)]
data_array = np.arange(1.0, N + 1.0)

# 使用列表推导式配合 math.log
t_math_batch = timeit.timeit(lambda: [math.log(v) for v in data_list], number=5) / 5
# 使用 numpy.log 向量化计算
t_np_batch = timeit.timeit(lambda: np.log(data_array), number=5) / 5

print(f"\n100万个数据批量计算平均耗时:")
print(f"  [math.log(x) for x in list]: {t_math_batch:.4f} 秒")
print(f"  numpy.log(ndarray):          {t_np_batch:.4f} 秒")
print(f"  NumPy 向量化加速比:           {t_math_batch / t_np_batch:.1f} 倍")
典型主流硬件平台(如 x86-64 / Apple Silicon)上的实测数据如下:
- 单标量耗时:
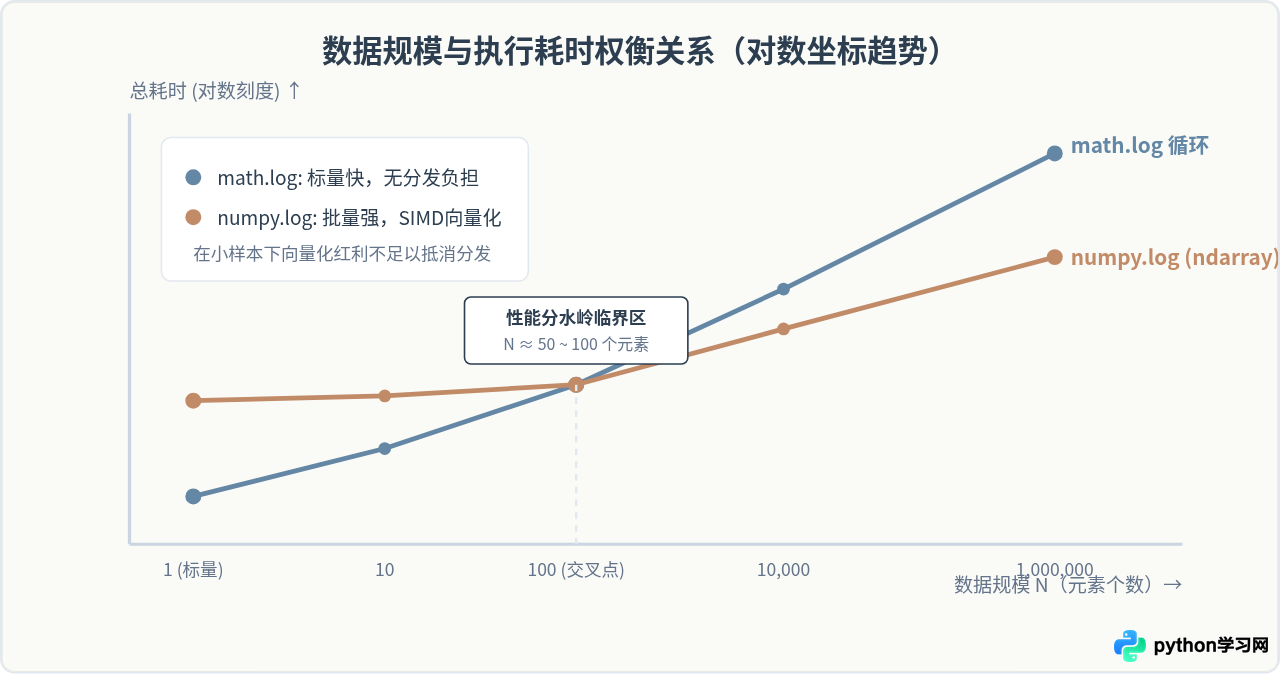
math.log约为 60 ~ 80 ns;而numpy.log约为 600 ~ 900 ns。在标量场景下,math.log快近 10倍。 - 批量计算(100万个元素):Python列表解析式配合
math.log耗时约为 85 ~ 110 ms;而numpy.log直接对连续内存数组运算仅需 2.0 ~ 3.5 ms,速度领先 30 ~ 50倍。
四、工程选型指南与常见避坑点
在实际工程开发与科学计算项目中,选型失误往往会导致程序性能大幅滑坡或产生隐蔽的Bug。以下是核心选型决策逻辑与典型误区解析:
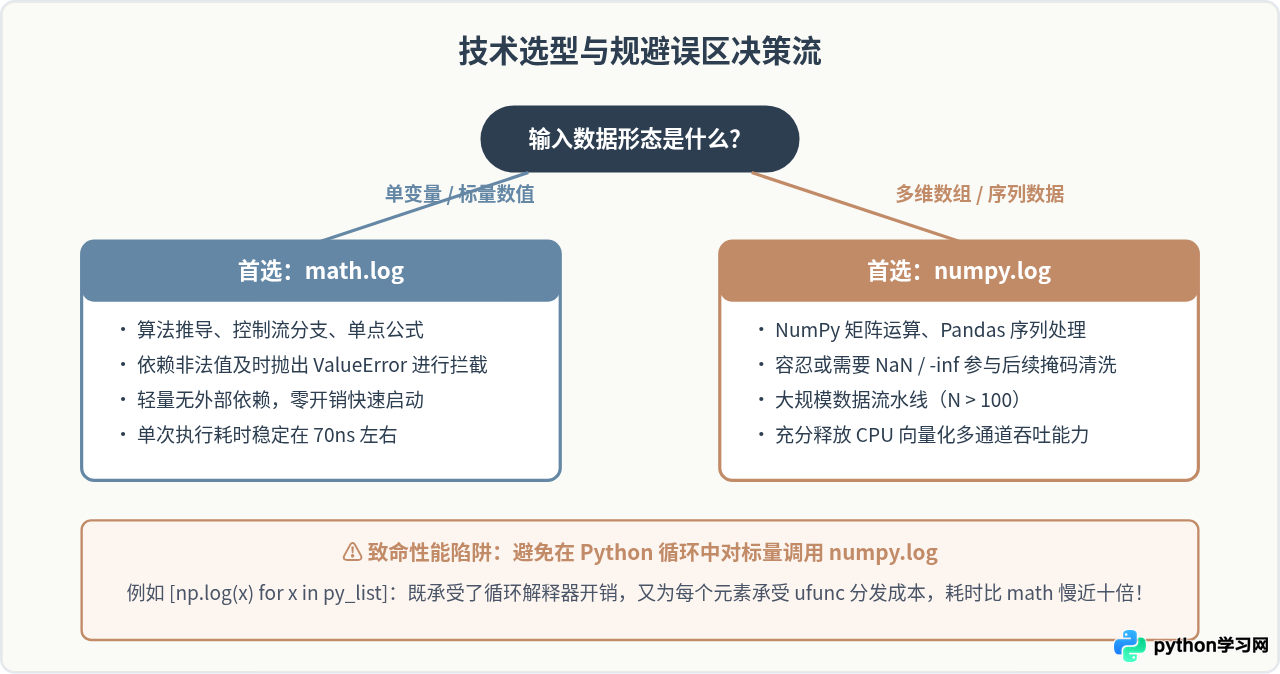
list中且无法转换为数组,直接使用列表推导式配合math.log(即[math.log(x) for x in my_list])是性能最优解。只有当数据本身已组织为numpy.ndarray或PandasSeries时,调用np.log(arr)才能完整发挥向量化优势。
for循环中对单标量使用numpy.log,例如:
# 严重反模式:极度缓慢,应坚决避免
result = []
for val in big_list:
result.append(np.log(val)) # 每次循环均触发 ufunc 分发开销math.log慢将近一个数量级。
五、总结
归结起来,math.log与numpy.log各司其职:
- 精度上:在同为64位标准浮点时二者精度一致;
math.log边界条件严格,遇到非法值立即报错阻断流程;numpy.log遵循IEEE浮点容错规范返回特殊值(nan、-inf),并具备多精度和复数运算支持。 - 性能上:单个数字计算时,
math.log开销在纳秒级,显著优于numpy.log;而在数据集规模超过百级、达到千级或百万级时,numpy.log的向量化机制展现压倒性性能优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









