

Scrapy结合Selenium实现动态网页数据抓取详解

本文详解如何利用Scrapy框架结合Selenium解决动态网站数据抓取问题。通过自定义下载中间件,在Request阶段使用Selenium渲染JS并获取源码,直接返回Response对象,从而跳过默认Downloader。文章提供了middlewares.py和taobao.py的完整代码示例,并针对单爬虫与多爬虫场景下的Driver初始化策略进行了对比分析,帮助开发者高效实现动态内容抓取。
Scrapy结合Selenium抓取动态网页原理
Scrapy框架原生仅支持静态网页的抓取。若目标网站包含动态加载内容,必须引入Selenium进行JavaScript渲染,才能成功获取动态生成的数据。
核心问题在于:如何绕过Scrapy默认的Downloader,直接通过Selenium发起URL请求?
解决方案是:在Request经过中间件时,于中间件内部调用Selenium执行URL请求,获取渲染后的页面源码。随后,将该源码封装为Response对象返回,直接交由process_response()处理并传回引擎。此过程会跳过后续中间件的process_request()及Downloader模块。
环境配置与中间件实现
实施前需完成以下环境配置:
1. 在Scrapy环境中安装Selenium库,执行命令:pip install selenium
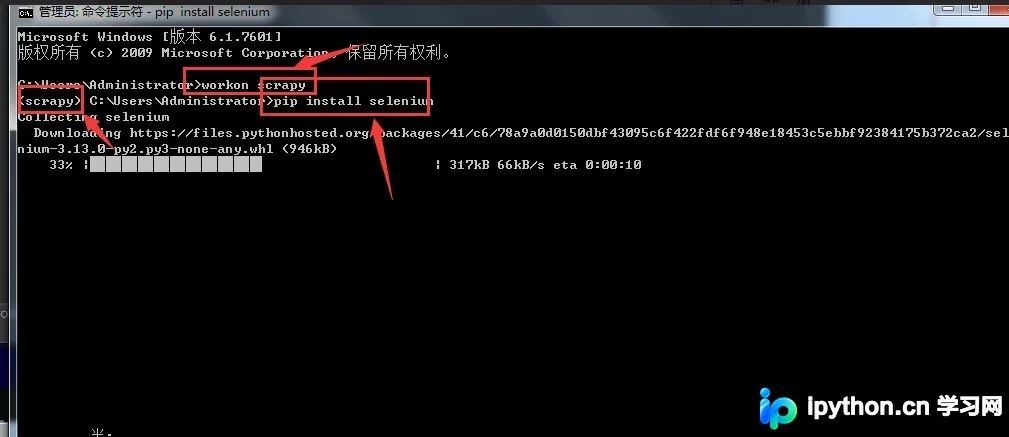
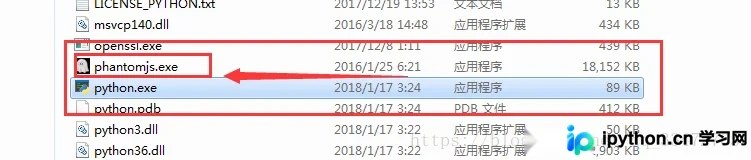
2. 确保Python运行环境中已配置PhantomJS(无头浏览器)或相应浏览器驱动。
Selenium的核心操作主要涉及下载中间件的实现,具体逻辑如下图所示:
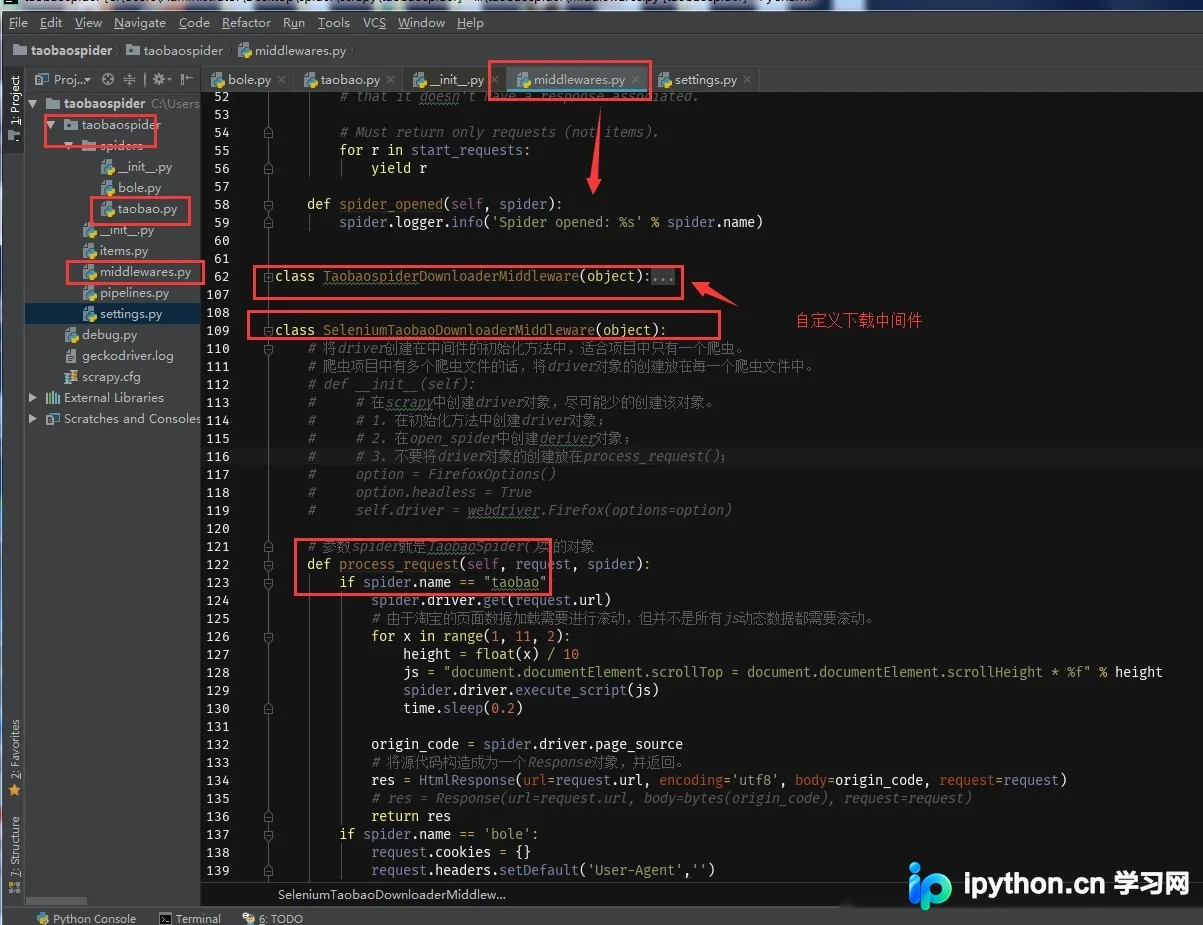
相关代码实现如下:
middlewares.py文件代码:
注意:此处为自定义下载中间件,采用Selenium进行请求处理。
# -*- coding: utf-8 -*-

# Define here the models for your spider middleware
#
# See documentation in:
# https://doc.scrapy.org/en/latest/topics/spider-middleware.html

from scrapy import signals
from selenium import webdriver
from selenium.webdriver import FirefoxOptions
from scrapy.http import HtmlResponse, Response
import time

class TaobaospiderSpiderMiddleware(object):
 # Not all methods need to be defined. If a method is not defined,
 # scrapy acts as if the spider middleware does not modify the
 # passed objects.

 @classmethod
 def from_crawler(cls, crawler):
  # This method is used by Scrapy to create your spiders.
  s = cls()
  crawler.signals.connect(s.spider_opened, signal=signals.spider_opened)
  return s

 def process_spider_input(self, response, spider):
  # Called for each response that goes through the spider
  # middleware and into the spider.

  # Should return None or raise an exception.
  return None

 def process_spider_output(self, response, result, spider):
  # Called with the results returned from the Spider, after
  # it has processed the response.

  # Must return an iterable of Request, dict or Item objects.
  for i in result:
   yield i

 def process_spider_exception(self, response, exception, spider):
  # Called when a spider or process_spider_input() method
  # (from other spider middleware) raises an exception.

  # Should return either None or an iterable of Response, dict
  # or Item objects.
  pass

 def process_start_requests(self, start_requests, spider):
  # Called with the start requests of the spider, and works
  # similarly to the process_spider_output() method, except
  # that it doesn't have a response associated.

  # Must return only requests (not items).
  for r in start_requests:
   yield r

 def spider_opened(self, spider):
  spider.logger.info('Spider opened: %s' % spider.name)


class TaobaospiderDownloaderMiddleware(object):
 # Not all methods need to be defined. If a method is not defined,
 # scrapy acts as if the downloader middleware does not modify the
 # passed objects.

 @classmethod
 def from_crawler(cls, crawler):
  # This method is used by Scrapy to create your spiders.
  s = cls()
  crawler.signals.connect(s.spider_opened, signal=signals.spider_opened)
  return s

 def process_request(self, request, spider):
  # Called for each request that goes through the downloader
  # middleware.

  # Must either:
  # - return None: continue processing this request
  # - or return a Response object
  # - or return a Request object
  # - or raise IgnoreRequest: process_exception() methods of
  # installed downloader middleware will be called
  return None

 def process_response(self, request, response, spider):
  # Called with the response returned from the downloader.

  # Must either;
  # - return a Response object
  # - return a Request object
  # - or raise IgnoreRequest
  return response

 def process_exception(self, request, exception, spider):
  # Called when a download handler or a process_request()
  # (from other downloader middleware) raises an exception.

  # Must either:
  # - return None: continue processing this exception
  # - return a Response object: stops process_exception() chain
  # - return a Request object: stops process_exception() chain
  pass

 def spider_opened(self, spider):
  spider.logger.info('Spider opened: %s' % spider.name)

*********************下面是相应是自定义的下载中间件的替换代码**************************
class SeleniumTaobaoDownloaderMiddleware(object):
 # 将driver创建在中间件的初始化方法中,适合项目中只有一个爬虫。
 # 爬虫项目中有多个爬虫文件的话,将driver对象的创建放在每一个爬虫文件中。
 # def __init__(self):
 #  # 在scrapy中创建driver对象,尽可能少的创建该对象。
 #  # 1. 在初始化方法中创建driver对象;
 #  # 2. 在open_spider中创建deriver对象;
 #  # 3. 不要将driver对象的创建放在process_request();
 #  option = FirefoxOptions()
 #  option.headless = True
 #  self.driver = webdriver.Firefox(options=option)

 # 参数spider就是TaobaoSpider()类的对象
 def process_request(self, request, spider):
  if spider.name == "taobao":
   spider.driver.get(request.url)
   # 由于淘宝的页面数据加载需要进行滚动,但并不是所有js动态数据都需要滚动。
   for x in range(1, 11, 2):
    height = float(x) / 10
    js = "document.documentElement.scrollTop = document.documentElement.scrollHeight * %f" % height
    spider.driver.execute_script(js)
    time.sleep(0.2)

   origin_code = spider.driver.page_source
   # 将源代码构造成为一个Response对象,并返回。
   res = HtmlResponse(url=request.url, encoding='utf8', body=origin_code, request=request)
   # res = Response(url=request.url, body=bytes(origin_code), request=request)
   return res
  if spider.name == 'bole':
   request.cookies = {}
   request.headers.setDefault('User-Agent','')
  return None

 def process_response(self, request, response, spider):
  print(response.url, response.status)
  return response
taobao.py爬虫文件代码:
# -*- coding: utf-8 -*-
import scrapy
from selenium import webdriver
from selenium.webdriver import FirefoxOptions


class TaobaoSpider(scrapy.Spider):
 """
 scrapy框架只能爬取静态网站。如需爬取动态网站,需要结合着selenium进行js的渲染,才能获取到动态加载的数据。

 如何通过selenium请求url,而不再通过下载器Downloader去请求这个url?
 方法:在request对象通过中间件的时候,在中间件内部开始使用selenium去请求url,并且会得到url对应的源码,然后再将源代码通过response对象返回,直接交给process_response()进行处理,再交给引擎。过程中相当于后续中间件的process_request()以及Downloader都跳过了。

 """
 name = 'taobao'
 allowed_domains = ['taobao.com']
 start_urls = ['https://s.taobao.com/search?q=%E7%AC%94%E8%AE%B0%E6%9C%AC%E7%94%B5%E8%84%91&imgfile=&commend=all&ssid=s5-e&search_type=item&sourceId=tb.index&spm=a21bo.2017.201856-taobao-item.1&ie=utf8&initiative_id=tbindexz_20170306']

 def __init__(self):
  # 在初始化淘宝对象时,创建driver
  super(TaobaoSpider, self).__init__(name='taobao')
  option = FirefoxOptions()
  option.headless = True
  self.driver = webdriver.Firefox(options=option)

 def parse(self, response):
  """
  提取列表页的商品标题和价格
  :param response:
  :return:
  """
  info_divs = response.xpath('//div[@class="info-cont"]')
  print(len(info_divs))
  for div in info_divs:
   title = div.xpath('.//a[@class="product-title"]/@title').extract_first('')
   price = div.xpath('.//span[contains(@class, "g_price")]/strong/text()').extract_first('')
   print(title, price)
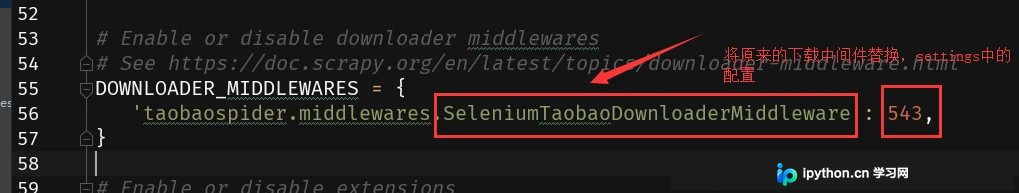
settings.py配置文件关键设置如下图所示:
Driver初始化策略:单爬虫与多爬虫场景
关于代码中Driver初始化的位置,存在两种常见情况:
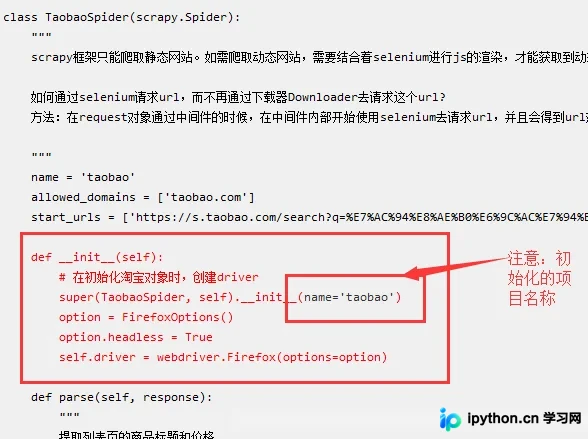
1. 若项目中仅包含一个爬虫文件,Driver的初始化函数可定义在middlewares.py的自定义中间件中(参考上述代码注释中的初始化部分),也可定义在爬虫文件内部(参考上述代码在爬虫文件中的初始化方式)。
注意:当仅有一个爬虫文件时,无需在自定义的process_requests方法中判断具体是哪个爬虫项目再分别发起请求。
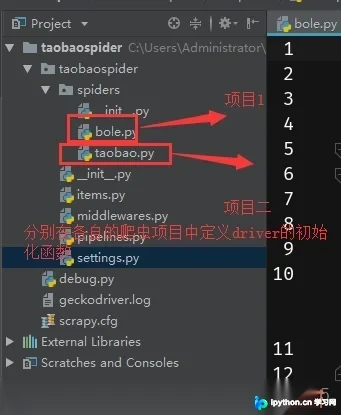
2. 若项目包含两个或更多爬虫文件(项目结构如下图所示),则需将Driver的初始化函数定义在各自的爬虫项目文件下(如上述代码所示)。同时,必须在process_requests方法中判断当前请求所属的爬虫项目,以区分处理。
至此,关于Scrapy与Selenium结合抓取数据的示例代码介绍完毕。如需了解更多Scrapy与Selenium配合抓取数据的相关内容,建议搜索本站往期文章或继续浏览后续系列教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









